PARTE XLV · Seguridad, resiliencia y riesgo sistémico
491
Resiliencia digital y continuidad de organizaciones
Mantener servicios, limitar dependencias y recuperar con confianza
En este capítulo
Una organización puede perder su capacidad de atender, pagar, coordinar o conservar registros aunque sus oficinas sigan en pie. Una avería, un error de configuración, la pérdida de credenciales, un fallo en un proveedor o un incidente malicioso pueden interrumpir procesos distintos y propagarse por dependencias compartidas. En ocasiones los datos siguen intactos, pero no se puede demostrar su integridad; en otras, el sistema vuelve a funcionar antes de que se recupere la confianza o el acceso de las personas usuarias. La continuidad digital no es simplemente mantener servidores encendidos.
La pregunta guía es: ¿cómo puede una organización mantener sus servicios prioritarios y recuperar capacidades digitales cuando sus datos, identidades, equipos y proveedores dependen unos de otros? La respuesta comienza por nombrar qué servicio debe sostenerse, para quién y bajo qué límites; después, identificar sus dependencias y formas de interrupción; preparar alternativas y copias que puedan usarse; acordar responsabilidades y comunicación; y comprobar la recuperación mediante ejercicios. Ninguna medida garantiza que no habrá incidentes. Las decisiones sobre prioridad, plazo y riesgo residual necesitan responsables, revisión y aprendizaje.
La resiliencia digital combina prevención, detección, respuesta y recuperación. El NIST Cybersecurity Framework 2.0 organiza resultados en seis funciones —gobernar, identificar, proteger, detectar, responder y recuperar—, aplicables a distintos tipos de organización y con grados de madurez diversos. No es una certificación automática ni una lista universal de controles. La edición 3 de la guía de NIST sobre respuesta a incidentes integra esas actividades al ciclo de gestión de riesgos y trata la respuesta como capacidad organizativa continua, no como un equipo que aparece sólo después del daño. Los marcos orientan preguntas; la selección concreta depende del contexto, obligaciones y recursos.
Este capítulo aborda continuidad de organizaciones que usan servicios y datos digitales. El capítulo 490 examinó dependencias físicas entre agua, energía y alimentos; aquí no se repite ese análisis. Se tratan proveedores tecnológicos y servicios en nube como parte de la cadena de continuidad, pero no se ofrece una guía de configuración ni un programa de pruebas intrusivas. La seguridad informática detallada, los requisitos de notificación y la recuperación ante un incidente real requieren profesionales y marcos aplicables a cada jurisdicción.
491.1. Servicios, datos y proveedores críticos#
Un inventario de equipos ayuda, pero una lista de servidores no explica qué necesita seguir haciendo una organización. El punto de partida es un servicio: una función reconocible por quienes dependen de ella, con usuarios, resultados y condiciones de operación. Puede ser emitir pagos, coordinar atención, registrar inventario, responder consultas o conservar expedientes. Un servicio puede usar muchos sistemas, y un mismo sistema puede servir a funciones distintas. Por ello, la criticidad se establece desde las consecuencias de su pérdida —seguridad, derechos, compromisos, operaciones y recuperación— y no sólo desde el costo del activo o su etiqueta técnica.
Después se traza el camino que convierte datos en una acción: quién los origina, dónde se almacenan, qué identidad permite acceder, qué software los interpreta, qué red los transporta y quién sostiene el servicio. Las dependencias incluyen dispositivos, energía, conectividad, personal especializado, contratos, certificados, dominios, servicios de autenticación, proveedores secundarios y procedimientos manuales. Un proveedor contratado puede depender de otra empresa que no aparece en la factura. Un inicio de sesión centralizado simplifica la operación cotidiana y puede convertirse en un punto común de interrupción si falla o queda comprometido.
El mapa es útil cuando distingue entre dependencia y consecuencia. Que un servicio consuma una plataforma no demuestra que la plataforma sea un punto único de fallo: puede existir una instancia alternativa o una operación manual. Y que haya redundancia no significa que sea independiente; dos copias pueden usar la misma identidad, cuenta de administración, ubicación física, conexión o proveedor. Una relación relevante debe acompañarse de la pregunta: si esta pieza falta, ¿qué función deja de operar, por cuánto tiempo y para quién?
Los datos tienen propiedades distintas. La disponibilidad busca acceso oportuno y fiable cuando se necesita; la integridad protege contra modificación o destrucción impropias, de modo que puedan comprobarse completitud y consistencia; la confidencialidad preserva restricciones autorizadas sobre acceso y divulgación. La recuperación puede mejorar una propiedad y afectar otra: restaurar una copia anterior repone disponibilidad, pero también puede volver a un estado que perdió transacciones o reintroducir una configuración débil. La organización debe definir qué estado es aceptable y quién puede declararlo confiable.
Priorizar exige escuchar a quienes usan el servicio, incluso a personas que no están representadas en las métricas internas. Un proceso puede parecer de baja criticidad para la administración y ser esencial para solicitar una prestación, acceder a un expediente o denunciar un problema. Un análisis de impacto puede agrupar servicios por consecuencias y dependencias, pero no debe esconder la decisión normativa detrás de una puntuación. Debe hacer visibles supuestos, tiempos tolerables, alternativas y daños previsibles, y actualizarse cuando cambian el servicio, el proveedor o las personas afectadas.
491.2. Concentración y dependencias de terceros#
La contratación externa puede permitir capacidades que una organización no podría mantener por sí sola. A la vez, crea dependencias de disponibilidad, identidad, soporte, ubicación, licencia, actualizaciones, formatos y decisiones de otra entidad. La nube no elimina infraestructura: cambia quién la opera y cómo se comparten responsabilidades. Un contrato puede asignar tareas, pero la organización usuaria conserva obligaciones sobre sus datos, sus servicios y el acceso de las personas, según la ley y los acuerdos aplicables.
La concentración puede aparecer en capas. Varias aplicaciones diferentes podrían usar una misma nube, proveedor de identidad, sistema de nombres, pasarela de pagos o proveedor de telecomunicaciones. La aparente diversidad del catálogo no implica diversidad técnica. También existe concentración geográfica y organizativa: equipos de soporte en una zona horaria, una sola persona con permisos, un único integrador que conoce las configuraciones o una misma cuenta administrativa para producción y copias. El riesgo común surge cuando eventos distintos pueden afectar varios servicios por compartir un componente o una autoridad.
Evaluar a un proveedor requiere saber qué servicio presta, qué información maneja, qué subcontratistas participan, qué notifica, cómo se recuperan los datos y qué ocurre al terminar el contrato. Las respuestas del proveedor no reemplazan evidencia ni validan automáticamente la seguridad. Certificados y auditorías pueden ayudar a entender controles dentro de un alcance y período concretos, pero no garantizan que una organización particular haya configurado bien su integración o que una interrupción no ocurra. La confianza debe ser proporcional a la función, los datos, la dependencia y las consecuencias.
La salida de un servicio merece atención antes de contratarlo. Exportar datos en un formato reutilizable puede no bastar si faltan metadatos, registros de auditoría, claves, derechos de uso o compatibilidad con otra plataforma. La terminación puede requerir conservar ciertos registros y eliminar otros con seguridad, sujeto a obligaciones legales. Migrar mientras el servicio está activo puede ser costoso o producir periodos de doble operación. La portabilidad no es sólo una cláusula: depende de capacidades técnicas, documentación, personal y tiempo que conviene probar en condiciones controladas.
La diversidad puede reducir una dependencia concentrada, pero sumar proveedores también aumenta superficie de coordinación, contratos y configuraciones. Dos proveedores que parecen independientes pueden usar el mismo centro de datos o intermediario. Por eso, la decisión no consiste en maximizar el número de terceros ni en rechazar toda externalización. Consiste en comprender qué servicio esencial depende de cuál proveedor, cómo se concentran los fallos, qué alternativas son realistas y quién tiene autoridad para activar el cambio. NIST CSF 2.0 incorpora la gestión del riesgo de cadena de suministro como parte de la gobernanza de ciberseguridad; es una guía de resultados, no una garantía contractual.
491.3. Protección, copias y recuperación#
Preparar la recuperación exige distinguir cuánto tiempo puede interrumpirse una función de cuánta información puede perderse. El objetivo de tiempo de recuperación, conocido como RTO, fija el tiempo previsto para recuperar la capacidad necesaria; el objetivo de punto de recuperación, RPO, indica hasta qué punto anterior deben recuperarse los datos. Son objetivos que orientan diseño y pruebas, no promesas que una copia cumpla automáticamente (NIST SP 800-34 Rev. 1).
Ejemplo construido. Un servicio fija un RTO de cuatro horas y exige recuperar datos hasta una hora antes de la interrupción. Si su última copia válida es de la noche anterior, restaurarla en dos horas cumple el objetivo de tiempo, pero puede incumplir el de datos. Si una copia reciente tarda diez horas en restaurarse, puede ocurrir lo contrario. Además, deben comprobarse transacciones entre sistemas: recuperar por separado pagos y pedidos de momentos distintos puede generar registros incompatibles. La recuperación completa exige conciliar el estado del servicio, no sólo terminar la transferencia de archivos.
La recuperación empieza mucho antes de restaurar datos. La protección reduce oportunidades de interrupción; la detección permite identificar cambios no esperados; la respuesta limita propagación y organiza decisiones; la recuperación devuelve servicios de forma ordenada. Separar estas funciones ayuda a evitar la idea de que una copia de seguridad resuelve cualquier incidente. Una copia puede ser inaccesible, estar incompleta, conservar el mismo error o haber quedado expuesta a la misma cuenta comprometida que los sistemas activos.
Una estrategia de copias considera qué información se debe conservar, con qué frecuencia, cuánto tiempo, dónde, quién puede modificarla y cómo se verifica que se pueda recuperar. Mantener una copia desconectada o protegida de cambios puede reducir el riesgo de que un incidente afecte a la vez producción y respaldo; no sirve si nadie puede acceder a ella durante la recuperación. Una política de retención también debe equilibrar restauración, privacidad, costo, obligaciones y minimización: guardar todo indefinidamente puede crear exposición y cargas adicionales. La guía CISA recomienda copias protegidas y pruebas regulares de disponibilidad e integridad en sus orientaciones contra ransomware; se trata de guía general estadounidense, no una receta legal para toda entidad.
La prueba debe demostrar algo más que la existencia de un archivo. Puede incluir restaurar datos en un entorno de ensayo, comprobar coherencia con la aplicación, medir dependencias y confirmar quién decide reabrir el servicio. Las pruebas cambian de alcance según criticidad y costo; un ensayo no garantiza desempeño idéntico bajo presión real. Los resultados deben producir acciones con dueño y fecha, no sólo una puntuación de cumplimiento. También importa que una alternativa no comparta el mismo fallo: otra cuenta administrada por las mismas credenciales quizá no aporte independencia.
La recuperación ordenada establece prioridades y criterios de confianza. Los servicios que protegen la vida o permiten sostener otros procesos pueden tener prioridad distinta de funciones menos urgentes. No existe secuencia correcta para todas las organizaciones. Los responsables necesitan saber qué sistemas deben estar limpios antes de reactivar otros, qué datos pueden estar desactualizados y cómo reconciliar operaciones manuales. Conectar demasiado pronto un sistema comprometido puede propagar el daño; esperar confirmación absoluta también puede prolongar pérdidas. La decisión depende de evidencia y de umbrales previamente definidos, con incertidumbre explícita.
La continuidad manual puede preservar operaciones durante una interrupción, pero no es sustituto gratuito. Formularios en papel, canales telefónicos y registros temporales exigen capacitación, accesibilidad, seguridad y un proceso posterior de conciliación. Si se diseñan sólo para personal de oficina, pueden excluir a usuarios que ya enfrentan barreras. Debe aclararse qué información mínima se recoge, quién puede verla, dónde se protege y cómo se incorpora al sistema una vez restaurado. El modo alternativo también requiere ejercicios y revisión para que no cree riesgos mayores que los que pretende reducir.
491.4. Comunicación y responsabilidades ante incidentes#
Un incidente digital es también un problema de coordinación. Diferentes equipos pueden ver síntomas parciales: personal operativo detecta retrasos, proveedor informa mantenimiento, usuarios reciben mensajes de error y seguridad observa actividad inusual. Alguien debe integrar la evidencia, distinguir hipótesis de hechos confirmados y asignar decisiones sobre continuidad, contención, privacidad, asuntos legales y comunicación. La respuesta mejora cuando las funciones se acuerdan antes, pero los nombres y obligaciones precisos dependen del tamaño de la organización, del sector, los contratos y la jurisdicción.
Los planes deben decir cómo escalar una duda, quién puede suspender una integración, quién comunica a la dirección, qué grupo consulta a proveedores y cómo se mantiene un registro de decisiones. Una lista de contactos envejece; los suplentes necesitan acceso y autoridad. La comunicación fuera de banda puede ser útil si los canales principales no son confiables o están afectados, pero también debe proteger información sensible y ser accesible para quienes participan. No es prudente asumir que un correo institucional sigue siendo íntegro durante una intrusión.
Al comunicar externamente, la organización debe separar lo que sabe, lo que investiga, las acciones que adoptó y lo que aún no puede confirmar. Ocultar una interrupción puede impedir que usuarios protejan sus intereses; afirmar una causa antes de tener evidencia puede inducir a error, afectar investigaciones o exponer datos. La persona responsable debe coordinar comunicación técnica, atención a usuarios, proveedores, autoridades y, cuando aplique, obligaciones de notificación. El plazo y destinatario legal varían: el capítulo no establece obligaciones regulatorias generales.
La comunicación interna también protege continuidad. El personal necesita instrucciones claras sobre canales autorizados, cambios temporales y modo de reportar fallas sin temor a sanciones automáticas. En situaciones confusas, mensajes contradictorios pueden multiplicar errores y agravar la interrupción. Una actualización puede indicar hora, alcance provisional, servicios disponibles, alternativa vigente, próxima actualización y contacto de apoyo. Estas decisiones se planifican; no deben improvisarse sobre una plantilla que presuponga incidente, culpable o tiempo de recuperación no verificados.
La responsabilidad no desaparece al contratar un proveedor. Las obligaciones se distribuyen según contrato y ley, pero la organización debe comprender qué controló, qué delegó y qué debe poder demostrar. Un informe posterior registra secuencia, decisiones, incertidumbres, consecuencias y acciones; protege la evidencia necesaria y evita atribuir automáticamente toda falla a una persona. Aprender exige corregir debilidades de diseño, acuerdos o incentivos, no sólo añadir recordatorios individuales.
491.5. Simulación defensiva y aprendizaje organizativo#
Una simulación ayuda a descubrir supuestos antes de que haya consecuencias reales. Puede presentar un escenario narrado —por ejemplo, pérdida de acceso a un proveedor y dudas sobre la integridad de una copia— y pedir que participantes indiquen qué servicio priorizan, qué evidencia necesitan, quién decide y cómo informan. La finalidad es examinar coordinación y dependencias, no probar técnicas de intrusión contra sistemas reales. Los ejercicios técnicos deben ser autorizados, delimitados, seguros y ejecutados por personal competente; el alcance de este capítulo es preparación organizativa, no un manual de ataque.
Los ejercicios de mesa, las pruebas controladas de restauración y los ensayos de canales alternativos responden a preguntas diferentes. Una conversación puede revelar que no hay autoridad clara; no demuestra que una copia sea restaurable. Una restauración exitosa verifica condiciones específicas del ensayo; no prueba que todos los servicios volverán a operar a tiempo durante una crisis. Un ejercicio funcional puede poner a prueba procedimientos, pero sus efectos sobre terceros y datos deben controlarse. El método debe ajustarse al riesgo, autorización, privacidad y capacidad de quienes participan.
Antes del ejercicio se fijan objetivos observables, supuestos, límites, participantes, criterios de detención y forma de manejar hallazgos. Después se registra qué ocurrió y qué cambió de la interpretación inicial. Las respuestas «correctas» pueden depender de información que un equipo no tenía; evaluar retrospectivamente con datos no disponibles en el momento distorsiona el aprendizaje. Conviene distinguir errores evitables, decisiones razonables bajo incertidumbre, restricciones de recursos y cambios del contexto. Los resultados se traducen en medidas con responsables, recursos, fechas y pruebas futuras.
La resiliencia requiere repetir la evaluación porque cambian personal, sistemas, amenazas, servicios, contratos y leyes. Una prioridad de ayer puede dejar de ser válida cuando una dependencia se desplaza. La misma medida puede tener costos nuevos, por ejemplo si se copia más información de la necesaria, se restringe acceso de forma desproporcionada o se crea un canal alternativo poco seguro. El ciclo de aprendizaje revisa no sólo si se recuperó un servicio, sino quién pudo usarlo, qué datos se perdieron o expusieron, qué obligaciones se atendieron y qué fallos comunes permanecen.
En una organización pequeña quizá no sea viable operar alternativas en paralelo. Eso no elimina la posibilidad de conocer sus dependencias, acordar a quién llamar, proteger una copia crítica y ensayar cómo continuar tareas esenciales. Una gran organización puede tener recursos para duplicar sistemas y, aun así, no conocer el proveedor que autentica varias divisiones. La resiliencia no se mide por el número de herramientas; se aprecia en la capacidad de entender consecuencias, decidir con autoridad, proteger a las personas y restaurar funciones con evidencia.
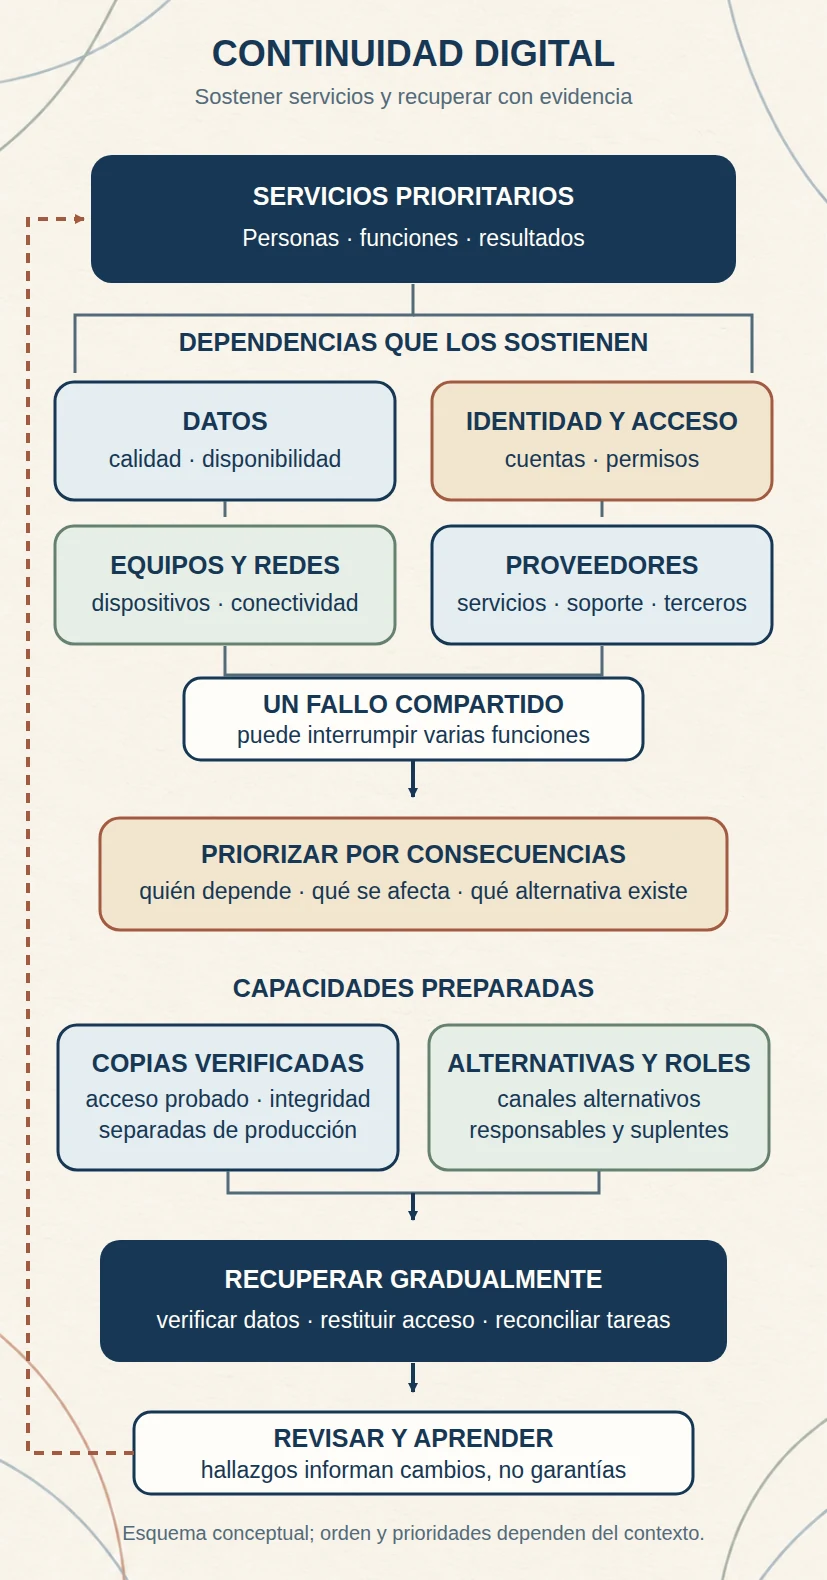
Esquema conceptual; la secuencia y las prioridades dependen de cada organización.
Síntesis#
La continuidad digital empieza por los servicios y las personas que dependen de ellos, no por una lista de máquinas. Identificar datos, identidades, equipos, redes y terceros permite distinguir dependencias de puntos únicos de fallo y descubrir dónde se comparte una misma autoridad o proveedor. Copias, alternativas y redundancia sólo aportan capacidad si están protegidas, son accesibles y se prueban para el propósito previsto. Responder requiere roles, registro de decisiones y mensajes que separen hechos de incertidumbres; los deberes de notificación dependen del sector y la jurisdicción. Los ejercicios comprueban supuestos distintos y deben estar autorizados y delimitados. La recuperación no acaba al encender sistemas: también exige verificar integridad, restituir acceso, conciliar operaciones y corregir causas organizativas. Ninguna herramienta elimina el riesgo; aprender consiste en conservar opciones y mejorar con evidencia.
- Una organización conserva copias diarias, pero nunca ha probado una restauración. ¿Qué puede afirmar sobre su continuidad? Que existen copias, si eso se ha verificado; no que sean completas, legibles, independientes de la cuenta comprometida o compatibles con los servicios. Debe probarse qué se recupera y bajo qué condiciones, sin convertir una prueba parcial en garantía total.
- Una aplicación está disponible desde dos nubes distintas. ¿Eso demuestra que no hay concentración? No. Ambas pueden compartir identidad, red, operador, proveedor de soporte o jurisdicción. Hay que seguir dependencias subyacentes y comprobar si la alternativa funciona cuando falla la parte común.
- Durante una interrupción, los datos parecen intactos, pero no se puede verificar quién accedió. ¿Por qué no reabrir de inmediato? La disponibilidad no demuestra integridad ni confidencialidad. La organización debe ponderar consecuencias de demorar frente a riesgos de operar con datos o accesos no confiables y decidir con criterios previamente acordados y evidencia disponible.
- Un ejercicio de mesa termina con un plan claro. ¿Qué brecha sigue sin comprobar? La conversación muestra coordinación y decisiones bajo ese escenario, pero no verifica restauración de copias, capacidad técnica, comunicación alternativa real ni obligaciones legales. Se necesitan pruebas separadas para esas capacidades, autorizadas y acordes con su riesgo.
Fuentes y lecturas del capítulo#
NIST, SP 800-34 Rev. 1, Contingency Planning Guide for Federal Information Systems, 2010. Referencia para análisis de impacto, objetivos de tiempo y punto de recuperación y pruebas de continuidad; su contexto son sistemas federales estadounidenses. Publicación oficial.
NIST, The NIST Cybersecurity Framework (CSF) 2.0, 26-02-2024. Marco de resultados organizados en seis funciones y aplicable a diversos sectores y tamaños. Es guía voluntaria, no certificación ni catálogo prescriptivo universal. NIST.
NIST, SP 800-61 Rev. 3, Incident Response Recommendations and Considerations for Cybersecurity Risk Management, 03-04-2025. Actualiza SP 800-61 Rev. 2 e integra respuesta a incidentes con las funciones del CSF 2.0. Guía de gestión de riesgos, no obligación legal general. NIST CSRC.
NIST, FIPS PUB 199, Standards for Security Categorization of Federal Information and Information Systems, febrero de 2004. Fuente de las definiciones de confidencialidad, integridad y disponibilidad utilizadas como propiedades de seguridad; no se trata como regulación universal para todas las organizaciones. NIST.
CISA, NSA, FBI y MS-ISAC, #StopRansomware Guide, revisión 19-10-2023. Recomienda preparar y probar copias protegidas, planes de respuesta y comunicación, con precauciones sobre recuperación. Guía estadounidense específica a ransomware; no se presenta como regla para todas las jurisdicciones o incidentes. CISA.
NIST, Cybersecurity Framework 2.0: Quick-Start Guide for Cybersecurity Supply Chain Risk Management, 2024. Apoya el tratamiento de proveedores y cadena de suministro como parte de la gestión de riesgos. Orientación para adaptar; no certifica controles de un tercero. NIST.
Nota editorial sobre alcance y actualización. Corte de investigación: 8 de octubre de 2026. No se ofrece configuración técnica, evaluación de proveedor, prueba de penetración, respuesta a incidente real ni dictamen de cumplimiento. Los plazos de notificación, retención y acceso dependen de leyes, contratos y sectores concretos. Las guías NIST son estándares/orientaciones estadounidenses y no imponen por sí mismas una obligación general a toda organización; CISA aborda particularmente ransomware. La seguridad absoluta no puede inferirse de una certificación, una arquitectura multicloud o una copia aislada.