PARTE XIII · Métodos: medición, territorio, capacidad e implementación
136
Inferencia causal fuera del experimento aleatorio
Construir comparaciones que permitan atribuir efectos
En este capítulo
Ejemplo construido. Una red de distribución repara fugas en los sectores con mayores pérdidas. Al terminar, esos sectores siguen perdiendo más agua que los que no recibieron reparaciones. La comparación podría sugerir que reparar empeora el servicio. Sin embargo, fueron seleccionados precisamente porque estaban en peor estado. También podría observarse una reducción de pérdidas después de reparar y atribuirla íntegramente al trabajo, aunque durante ese período haya bajado la presión de toda la red.
Ambas comparaciones contienen información, pero ninguna separa por sí sola el efecto de reparar de las otras causas de las pérdidas. La pregunta causal requiere representar qué habría ocurrido con esos mismos sectores, durante el mismo período, bajo una intervención alternativa. Fuera del experimento aleatorio, el rigor depende de construir una comparación defendible y explicar qué condiciones permiten utilizarla.
136.1. Intervenciones, resultados potenciales y contrafactuales#
Una pregunta causal debe precisar una acción, una población, un resultado y un horizonte. «¿Sirve reparar?» deja abiertos procedimientos, sectores y fechas. Una pregunta más definida compara reparar determinados tramos durante un mes con mantenerlos sin esa reparación hasta después de medir las pérdidas del mes siguiente. También necesita definir cómo se medirán las pérdidas: volumen diario, proporción del agua suministrada o diferencia entre entradas y consumos registrados no son resultados intercambiables.
En el ejemplo seguiremos la pérdida diaria por sector, expresada en metros cúbicos por día y medida en jornadas acordadas. El protocolo debe fijar condiciones comparables y reconocer la incertidumbre de los instrumentos. Si una reparación cambia el modo de registrar pérdidas, el cambio de dato puede incluir un cambio de medición. Los problemas tratados en los capítulos anteriores no desaparecen al formular una pregunta causal.
Para un sector identificado por el índice
El efecto individual se representa como
Promediar efectos individuales define un efecto promedio para una población especificada. No exige que todos los sectores respondan igual. Tampoco equivale necesariamente al promedio entre los sectores efectivamente reparados: si éstos tienen condiciones particulares, el efecto relevante para ellos puede diferir del efecto de reparar cualquier sector. Una evaluación debe indicar a quién corresponde su conclusión.
La dificultad no se resuelve observando más días sin cambiar el diseño. Una serie larga puede ayudar a construir el contrafactual, pero requiere supuestos sobre lo que habría ocurrido. Una incertidumbre estadística pequeña tampoco compensa una comparación inadecuada. La identificación causal consiste en establecer qué supuestos permiten obtener el efecto buscado a partir de la información disponible; la estimación calcula ese efecto bajo ellos.
Hay condiciones previas incluso antes de escoger el método. «Reparación» debe describir una intervención suficientemente definida: sellar una unión y reemplazar una tubería completa pueden producir resultados distintos. La consistencia exige que el resultado observado bajo una intervención corresponda al resultado potencial definido para esa intervención. Reunir versiones incompatibles bajo una misma etiqueta impide interpretar limpiamente la comparación.
También debe examinarse la interferencia, por la que intervenir un sector modifica resultados de otros. En una red hidráulica, reparar una fuga puede alterar la presión aguas abajo. Entonces el resultado de un sector depende de más decisiones que su propia reparación. Se puede redefinir la intervención para conjuntos de sectores o modelar explícitamente esas conexiones. Tratar cada sector como aislado sin justificación cambia la pregunta sin reconocerlo.
136.2. Confusión, selección, mediación y colisionadores#
La selección de los sectores dañados introduce una explicación alternativa de la diferencia entre grupos. El deterioro previo influye tanto en la decisión de reparar como en las pérdidas posteriores. Esa causa común es un factor de confusión. La asociación entre reparación y pérdidas mezcla el efecto de la reparación con diferencias que existían antes de ella.
Un diagrama causal representa supuestos sobre esas relaciones mediante variables y flechas dirigidas. En este caso, deterioro apunta a reparación y a pérdidas; reparación también podría apuntar a pérdidas. Las flechas expresan relaciones causales propuestas, no correlaciones calculadas. La ausencia de una flecha también contiene un supuesto. El capítulo de Cunningham sobre diagramas causales muestra cómo la estructura determina qué comparaciones pueden quedar contaminadas.
Registrar deterioro antes de intervenir puede permitir comparar sectores con estados semejantes. Pero la variable debe medir aquello que importa, y la comparación necesita sectores reparados y no reparados dentro de las condiciones consideradas. Si todas las tuberías muy deterioradas fueron reparadas, los datos no contienen su alternativa sin reparar. Una fórmula de ajuste puede extrapolarla; no la convierte en una observación disponible.
La intercambiabilidad condicionada supone que, al comparar unidades con determinadas características previas, sus resultados potenciales no difieren sistemáticamente según la intervención recibida. No significa que sean idénticas. Significa que las diferencias restantes no seleccionan resultados potenciales distintos de una manera que sesgue el efecto buscado. Se requiere una justificación sobre el proceso de asignación y las causas del resultado, no sólo una tabla donde las medias observadas sean parecidas.
La positividad exige que las alternativas comparadas sean posibles para las condiciones de la población objetivo. Su manifestación práctica es disponer de comparaciones con suficiente solapamiento. El análisis de comparación observacional de Cunningham distingue este requisito de la ausencia de confusión no controlada. Tener muchos sectores de ambos grupos no basta si se concentran en condiciones completamente distintas. Restringir el análisis a los comparables puede ayudar, pero cambia la población a la que se refiere el efecto.
No toda variable asociada con el resultado debe ajustarse. Una mediadora transmite parte del efecto. Si reparar permite aumentar la presión y esa presión afecta las pérdidas, la presión posterior está en una vía causal de la intervención. Ajustarla al estimar el efecto total puede eliminar parte de lo que se quería medir. Investigar un efecto directo que excluya esa vía constituye otra pregunta y requiere condiciones adicionales; incluir la mediadora en una regresión no lo identifica automáticamente.
El papel de una variable depende de cuándo se mide y de las relaciones propuestas. Una presión previa que influye en la prioridad de reparación y en pérdidas posteriores podría ser confusora. La presión posterior, modificada por la reparación, podría ser mediadora. La etiqueta «presión» no decide su función. El registro temporal y el conocimiento del sistema son necesarios para dibujar relaciones defendibles.
Otra dificultad aparece cuando se seleccionan casos por una consecuencia común de dos variables. Esa consecuencia se llama colisionador, porque recibe dos flechas. Condicionar la comparación a ella puede crear una asociación que no existía en la población original. Seleccionar sólo expedientes completos, participantes que terminaron un programa o casos que ingresaron en un servicio puede tener ese efecto si la inclusión depende de causas distintas relacionadas con intervención y resultado.
Ejemplo construido. Dos sensores independientes emiten una alerta, cada uno con probabilidad de un medio. Un registro se conserva si al menos uno alerta. Antes de seleccionar, las cuatro combinaciones de alertas tienen probabilidad igual. Después, quedan tres: sólo el primero, sólo el segundo y ambos. Entre los registros donde el primero no alertó, el segundo siempre alertó; donde el primero sí alertó, el segundo alertó en la mitad. La selección creó una asociación negativa sin que un sensor causara el comportamiento del otro.
No es una objeción contra toda selección ni todo ajuste. Es una razón para explicar cómo se produjo la muestra y qué representan las variables. Ajustar por causas comunes previas puede cerrar una comparación espuria; ajustar por consecuencias comunes puede abrirla. Un análisis que incorpora indiscriminadamente todas las columnas disponibles puede empeorar su interpretación causal.
136.3. Experimentos naturales y diseños cuasiexperimentales#
A veces una regla, un calendario o un evento externo introduce diferencias de intervención que permiten comparaciones más defendibles que la decisión ordinaria de participar. Se habla de experimento natural cuando esa variación procede de circunstancias ajenas al experimento organizado por el investigador. El nombre no garantiza aleatoriedad. Una inundación, por ejemplo, puede afectar lugares diferentes en topografía, infraestructura y población.
Un diseño cuasiexperimental construye la comparación a partir de una regla o estructura de asignación sin contar con el experimento aleatorio convencional. Su fuerza depende de que esa estructura sostenga el contrafactual pertinente. El marco de HM Treasury para evaluar impactos vincula la credibilidad de la atribución con la calidad de esa comparación, no con una etiqueta metodológica.
En la red del ejemplo, un calendario de reparación establecido antes de conocer las pérdidas podría ofrecer una oportunidad. Pero habría que saber cómo se elaboró. Si priorizó zonas accesibles, esa accesibilidad puede relacionarse con otros cambios del servicio. Si las cuadrillas alteraron el orden por daños urgentes, el calendario previsto y la intervención efectivamente realizada ya no coinciden. Documentos de programación, cambios y fechas permiten evaluar el mecanismo real.
Comparar asignación y recepción también define efectos distintos. El efecto de ser programado para una reparación incluye retrasos e incumplimientos presentes en la ejecución. El efecto de recibirla no se obtiene simplemente descartando los incumplimientos, porque ese descarte puede seleccionar unidades particulares. Un diseño que aprovecha asignación como instrumento para recepción necesita justificar condiciones adicionales; no basta con que la asignación prediga quién recibió el trabajo.
La disponibilidad de datos suele inducir una decisión prematura: aplicar el método que el programa estadístico ofrece y después buscarle una historia causal. El orden defendible parte de la pregunta y del proceso que produjo la intervención. Una base con dos fechas no adquiere automáticamente un buen grupo de comparación. Una regla de umbral tampoco permite usar toda la población como si hubiese sido aleatorizada.
Los métodos de emparejamiento buscan unidades con características observadas semejantes; los de ponderación modifican la contribución de unidades para construir una comparación. Ambos pueden mejorar equilibrio observado. Siguen necesitando que las características utilizadas sean suficientes para la pregunta causal y estén adecuadamente medidas. Una decisión tomada por una inspección no registrada puede mantener confusión aunque los grupos coincidan en edad de las tuberías y tamaño del sector.
Estas decisiones tienen consecuencias operativas. Antes de analizar conviene conservar reglas de elegibilidad, fechas de anuncio y ejecución, cambios concurrentes y motivos de excepción. Una entrevista a quienes asignaron los trabajos puede aclarar el proceso, pero también debe contrastarse con registros. La evidencia cualitativa del capítulo anterior ayuda a entender mecanismos; la identificación causal exige comprobar cómo esos mecanismos afectan la comparación concreta.
136.4. Series temporales, diferencias y discontinuidades#
La comparación antes y después puede ampliarse con un grupo que no recibió la intervención. En diferencias en diferencias, se resta al cambio del grupo intervenido el cambio del grupo comparador. La resta pretende eliminar cambios que ambos habrían experimentado sin intervención. No requiere que sus niveles iniciales sean iguales; exige una condición sobre la evolución contrafactual.
Ejemplo construido. En sectores reparados, la pérdida media pasa de 40 a 25 metros cúbicos por día. En sectores sin reparar, pasa de 30 a 24. El cambio observado de los primeros es −15; el de los segundos, −6. La diferencia de cambios es −9 metros cúbicos por día. Si los primeros habrían reducido sus pérdidas en 6 sin reparación, su contrafactual posterior sería 34 y el efecto estimado sería
La cuenta se escribe como
La condición de tendencias paralelas afirma que, sin intervención, ambos grupos habrían cambiado igual en promedio durante el período pertinente. No afirma que el grupo intervenido, después de intervenir, deba seguir al otro. El capítulo de Cunningham sobre diferencias en diferencias distingue esta evolución no observada de las trayectorias anteriores que sí pueden examinarse.
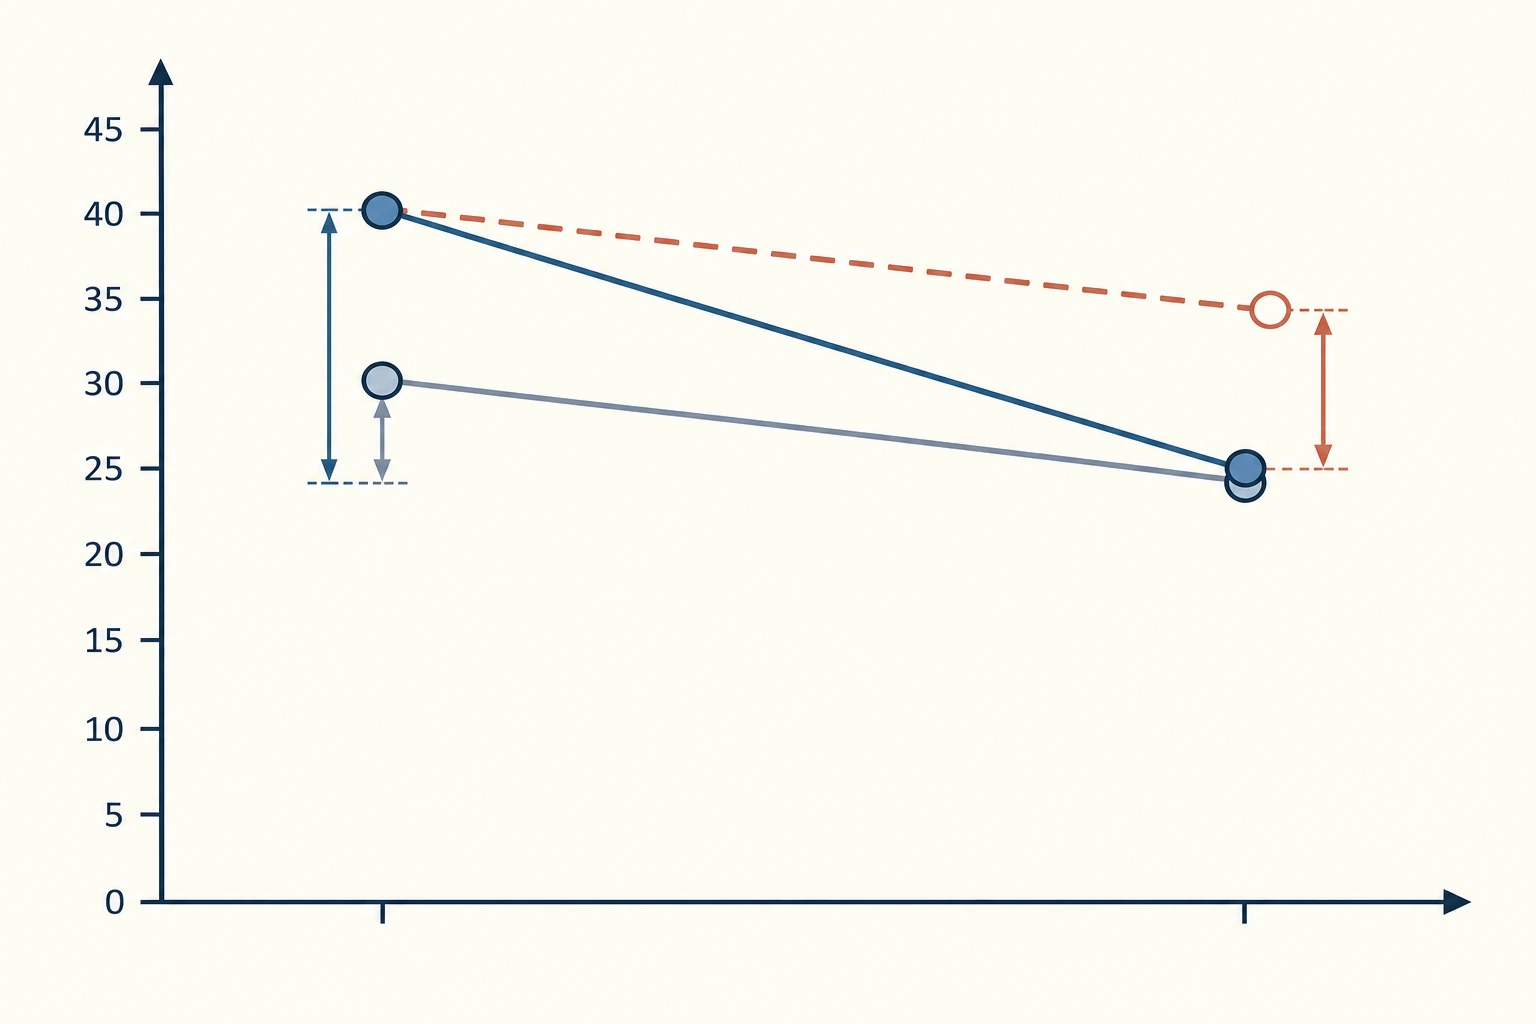
El cambio observado es −15, pero el efecto atribuido sería −9 si, sin reparación, el grupo intervenido hubiese experimentado la reducción de 6 del comparador
Trayectorias previas semejantes apoyan la plausibilidad del diseño, pero no demuestran que las tendencias contrafactuales posteriores habrían sido paralelas. Una obra simultánea sólo en los sectores reparados podría quebrar esa condición. También deben examinarse cambios anticipados por el anuncio, efectos sobre el comparador y cambios en composición o medición. Si la intervención altera la presión de toda la red, el grupo supuestamente no intervenido puede recibir parte del efecto.
Con muchas fechas y adopción en momentos distintos, la interpretación requiere mayor cuidado. Los efectos pueden variar con el tiempo transcurrido y entre grupos. Utilizar unidades ya intervenidas como comparación de otras recién intervenidas puede mezclar efectos diferentes. La fórmula sencilla no justifica cualquier modelo de regresión aplicado a un calendario complejo.
Una serie temporal interrumpida utiliza numerosas mediciones antes y después para examinar si la intervención coincide con un cambio de nivel, de tendencia o de ambos. La guía de GOV.UK sobre este diseño advierte sobre estacionalidad y dependencia entre observaciones sucesivas. Un modelo que ignore esas relaciones puede producir incertidumbres demasiado pequeñas o atribuir un ciclo ordinario a la intervención.
En la red, lecturas semanales permitirían reconocer una tendencia anterior y variaciones periódicas. La trayectoria previa podría proyectarse como contrafactual, pero una modificación de presión iniciada el mismo día que la reparación quedaría mezclada con ella. Añadir fechas no separa automáticamente dos cambios simultáneos. Una serie comparadora pertinente o información adicional puede ayudar; si no existe, la limitación debe permanecer en la conclusión.
La discontinuidad en regresión aprovecha un umbral que cambia la asignación. Ejemplo construido. Una ayuda para reparar se concede a sectores con una puntuación técnica de deterioro igual o superior a 60. Comparar todos los beneficiarios con todos los demás mezclaría reparación y deterioro. El diseño compara resultados cerca de 60 y pregunta si aparece un salto en el resultado donde cambia la elegibilidad.
La interpretación local requiere que las medias de los resultados potenciales sin y con intervención varíen de manera continua con la puntuación alrededor del umbral y que no aparezca allí otro cambio relevante. El desarrollo de Cunningham sobre discontinuidad explica esa identificación mediante la comparación a ambos lados del corte. La puntuación puede predecir pérdidas: lo problemático sería que otra causa introdujera un salto justo en 60.
Una capacidad de ajustar estratégicamente puntuaciones para obtener la ayuda amenaza la comparación. Conviene examinar su distribución, procedimientos de medición y características previas cerca del corte. No encontrar anomalías no prueba ausencia de manipulación. Ampliar mucho la ventana incorpora sectores menos comparables; estrecharla reduce información. Esas decisiones deben justificarse y su efecto sobre los resultados debe examinarse.
El anexo metodológico del Magenta Book delimita el alcance del diseño a unidades próximas al umbral. Un efecto allí no describe necesariamente tuberías en deterioro extremo. Si cruzar el corte sólo aumenta la probabilidad de recibir reparación, la discontinuidad de resultados no equivale directamente al efecto de recibirla: hacen falta un análisis y supuestos adicionales sobre esa asignación incompleta.
136.5. Supuestos identificables y pruebas de sensibilidad#
Los datos permiten examinar algunos aspectos del diseño: fechas, solapamiento observado, cambios de composición, continuidad de variables previas o diferencias de trayectoria anteriores. Otros supuestos se refieren a resultados que no se observaron, como lo que habría ocurrido sin intervención después de intervenir. Ninguna prueba estadística certifica todos esos supuestos a la vez.
Una comprobación puede intentar refutar una explicación. Si se atribuye a reparar una reducción que ya había comenzado mucho antes, el calendario contradice la interpretación sencilla. Un análisis con fechas anteriores donde no hubo intervención funciona como prueba placebo si existe una razón para esperar ausencia de efecto entonces. Un resultado inesperado obliga a investigar; la ausencia de resultado puede reflejar poca precisión y no demuestra validez del diseño.
La sensibilidad examina cuánto cambia la conclusión al modificar decisiones o supuestos plausibles. No consiste en ensayar muchas versiones y elegir la favorable. Debe mostrar el conjunto pertinente de resultados, explicar qué cambios representan y distinguir alternativas razonables de aquellas incompatibles con el contexto. También debe separar una incertidumbre de muestreo de una incertidumbre sobre el contrafactual.
En el ejemplo construido de diferencias en diferencias, la reducción observada del grupo reparado fue 15. Supongamos que su cambio sin reparación, en vez de −6, pudiera estar entre −8 y −4 metros cúbicos por día. Su contrafactual posterior estaría entre 32 y 36. El efecto correspondiente estaría entre
Si se considera plausible una caída contrafactual de 15 o más, la conclusión de beneficio deja de estar asegurada por esa comparación. La pregunta práctica pasa a ser qué registros sostienen o excluyen una caída de tal magnitud sin reparar. Un análisis de sensibilidad útil hace visible esa exigencia de conocimiento y evita presentar un número con precisión aparente como resultado inevitable.
La evaluación debe conservar decisiones sobre exclusiones, ventanas, períodos, variables de ajuste y medición del resultado. Una conclusión defendible informa el contraste elegido, la población a la que se refiere, el efecto estimado y la incertidumbre calculada, junto con los supuestos y amenazas que no quedaron resueltos. El capítulo siguiente trata de los registros que hacen esas decisiones examinables.
Atribuir un efecto fuera de la asignación aleatoria exige una explicación del proceso que produjo las comparaciones. Un buen diseño puede sostener una inferencia causal si se justifican sus supuestos para las condiciones estudiadas. En la red construida, la evidencia pertinente mostraría por qué la trayectoria elegida representa lo que habría sucedido sin reparar y qué información podría obligar a revisar esa conclusión.
Preguntas de transferencia#
¿Por qué pérdidas mayores entre sectores reparados no demuestran que reparar perjudique?#
Mostrar respuesta razonada
La reparación se asignó a sectores inicialmente peores. Las pérdidas posteriores combinan estado previo y efecto de intervenir. Hay que construir una comparación que represente sus pérdidas sin reparación en el mismo período; comparar niveles brutos con otros sectores no la proporciona.
¿Conviene ajustar por toda variable que prediga el resultado?#
Mostrar respuesta razonada
No. Su papel causal y temporal importa. Ajustar por una causa común puede reducir confusión; hacerlo por una mediadora puede excluir parte del efecto total, y por un colisionador puede introducir asociación espuria. La capacidad predictiva no determina qué ajuste responde a la pregunta causal.
¿Tendencias previas semejantes prueban el supuesto de diferencias en diferencias?#
Mostrar respuesta razonada
Apoyan su plausibilidad, pero el supuesto concierne al cambio posterior que habría ocurrido sin intervenir. Una modificación concurrente exclusiva de un grupo puede invalidarlo aunque las trayectorias anteriores fueran semejantes. También hacen falta precisión suficiente y evaluación de anticipación, interferencia y medición.
¿Puede aplicarse un efecto estimado cerca de un umbral a toda la población?#
Mostrar respuesta razonada
Requiere otra justificación. La comparación identifica un efecto local bajo sus supuestos. Las unidades alejadas pueden responder de modo distinto o recibir versiones distintas de la intervención. Extrapolar demanda evidencia o un modelo adicional, cuyo alcance debe declararse.
Fuentes y lecturas del capítulo#
Fuentes consultadas el 29 de septiembre de 2026. Los ejemplos, valores y cálculos del capítulo son construidos, no resultados de las investigaciones enlazadas.
- Scott Cunningham. «Potential Outcomes and Randomization», Causal Inference: The Remix, versión web. Utilizada para definir resultados potenciales, efectos y el problema de observar sólo una alternativa.
- Scott Cunningham. «Directed Acyclical Graphs», misma obra. Consultada para distinguir causas comunes, vías mediadas y selección por consecuencias comunes; los diagramas representan supuestos causales.
- Scott Cunningham. «Unconfoundedness», misma obra. Utilizada para separar comparabilidad condicionada y soporte común, y delimitar lo que aporta el ajuste observacional.
- HM Treasury. Quality in Policy Impact Evaluation, versión HTML. Marco utilizado para evaluar comparaciones contrafactuales y amenazas de atribución.
- Scott Cunningham. «Difference-in-Differences», Causal Inference: The Remix, versión web. Consultada para la comparación de cambios y el supuesto sobre tendencias contrafactuales; las comprobaciones anteriores no lo certifican.
- GOV.UK. Interrupted time series study, guía publicada el 22 de diciembre de 2020. Utilizada para cambios de nivel y tendencia, estacionalidad y dependencia temporal; no sustituye el análisis del mecanismo de intervención.
- Scott Cunningham. «Regression Discontinuity», Causal Inference: The Remix, versión web. Desarrollo consultado sobre identificación alrededor de un umbral y continuidad de resultados potenciales.
- HM Treasury. Magenta Book, Annex A: Analytical methods for use within an evaluation, versión HTML. Consultado para el alcance local de discontinuidades y los límites de comparación de cambios.