PARTE XII · Matemáticas: estructuras, cambio e incertidumbre
127
Probabilidad: incertidumbre y procesos aleatorios
Asignar posibilidades y revisar lo que se sabe al recibir información
En este capítulo
Una señal puede ser frecuente cuando hay un defecto y, aun así, no indicar con mucha certeza que una pieza señalada tenga ese defecto. Para interpretar la señal importa tanto su comportamiento como la frecuencia previa del problema. La pregunta «qué ocurre si hay defecto» y la pregunta «qué defecto hay si ocurre la señal» usan información parecida, pero no tienen la misma respuesta.
La probabilidad permite organizar esas relaciones sin exigir conocer el resultado de cada caso. Combina una descripción de posibilidades con pesos que deben ser coherentes entre sí. Sus conclusiones son exactas respecto del modelo adoptado; asignar ese modelo a un proceso observado es una tarea adicional. La incertidumbre puede reflejar variación entre realizaciones, información incompleta o ambas cosas.
127.1. Espacios de resultados y eventos#
Para calcular una probabilidad hay que fijar qué se observa y qué resultados se distinguen. Si se registran dos señales binarias sucesivas, las posibilidades ordenadas son 00, 01, 10 y 11. Si sólo se registra cuántas señales positivas hubo, los valores son cero, uno y dos. Las tres cantidades no son necesariamente igual de probables: dos secuencias distintas producen un único resultado positivo.
El espacio de resultados, o espacio muestral, contiene las realizaciones admitidas por el modelo; se denota
Una ley de probabilidad asigna a cada evento admitido
Como el evento
En un espacio finito con todos los resultados elementales igualmente probables,
Un registro de frecuencias puede ayudar a asignar o comprobar esos pesos cuando describe repeticiones comparables. También se emplean probabilidades para representar incertidumbre sobre un estado ya existente pero desconocido. En ambos usos, los cálculos deben especificar información y supuestos. Una pieza no cambia de estado al recibir nueva información sobre ella, aunque la probabilidad asignada a su defecto sí cambie.
Para dos eventos, la regla de suma es
La intersección se resta porque sus resultados quedaron incluidos dos veces. La misma lógica de inclusión y exclusión del conteo se aplica a pesos desiguales. Si los eventos son disjuntos, la intersección está vacía y basta sumarlos. (OpenStax, reglas básicas).
127.2. Probabilidad condicional e independencia#
Recibir información puede restringir el conjunto de posibilidades y exigir recalcular sus pesos relativos. La probabilidad condicional de
El denominador fija el evento al que se limita la evaluación, y el numerador conserva la parte que también cumple
Ejemplo construido. Un modelo de inspección fija una proporción de piezas defectuosas del uno por ciento. La señal es positiva en el noventa por ciento de las piezas defectuosas y en el cinco por ciento de las no defectuosas. Se elige una pieza según esa población de referencia, sin otra información. Se supone que las tres probabilidades describen el mismo tipo de pieza y las mismas condiciones de inspección.
En diez mil selecciones comparables, las frecuencias esperadas son cien piezas defectuosas y 9.900 sin defecto. Se esperan noventa señales positivas del primer grupo y 495 del segundo. Hay 585 positivas en total; noventa corresponden al defecto. Por tanto, para una pieza con señal positiva, la probabilidad de defecto es
La frecuencia de señales positivas entre piezas defectuosas era noventa por ciento; la proporción de piezas defectuosas entre señales positivas es aproximadamente quince por ciento. La diferencia aparece porque las piezas sin defecto son mucho más numerosas. Un cinco por ciento de ese grupo produce más señales que un noventa por ciento del grupo raro.
Sean
Los dos términos pertenecen a casos excluyentes y exhaustivos. Al dividir la probabilidad conjunta de defecto y señal por la probabilidad de señal,
Esta inversión del condicionamiento es la regla de Bayes. Procede de que
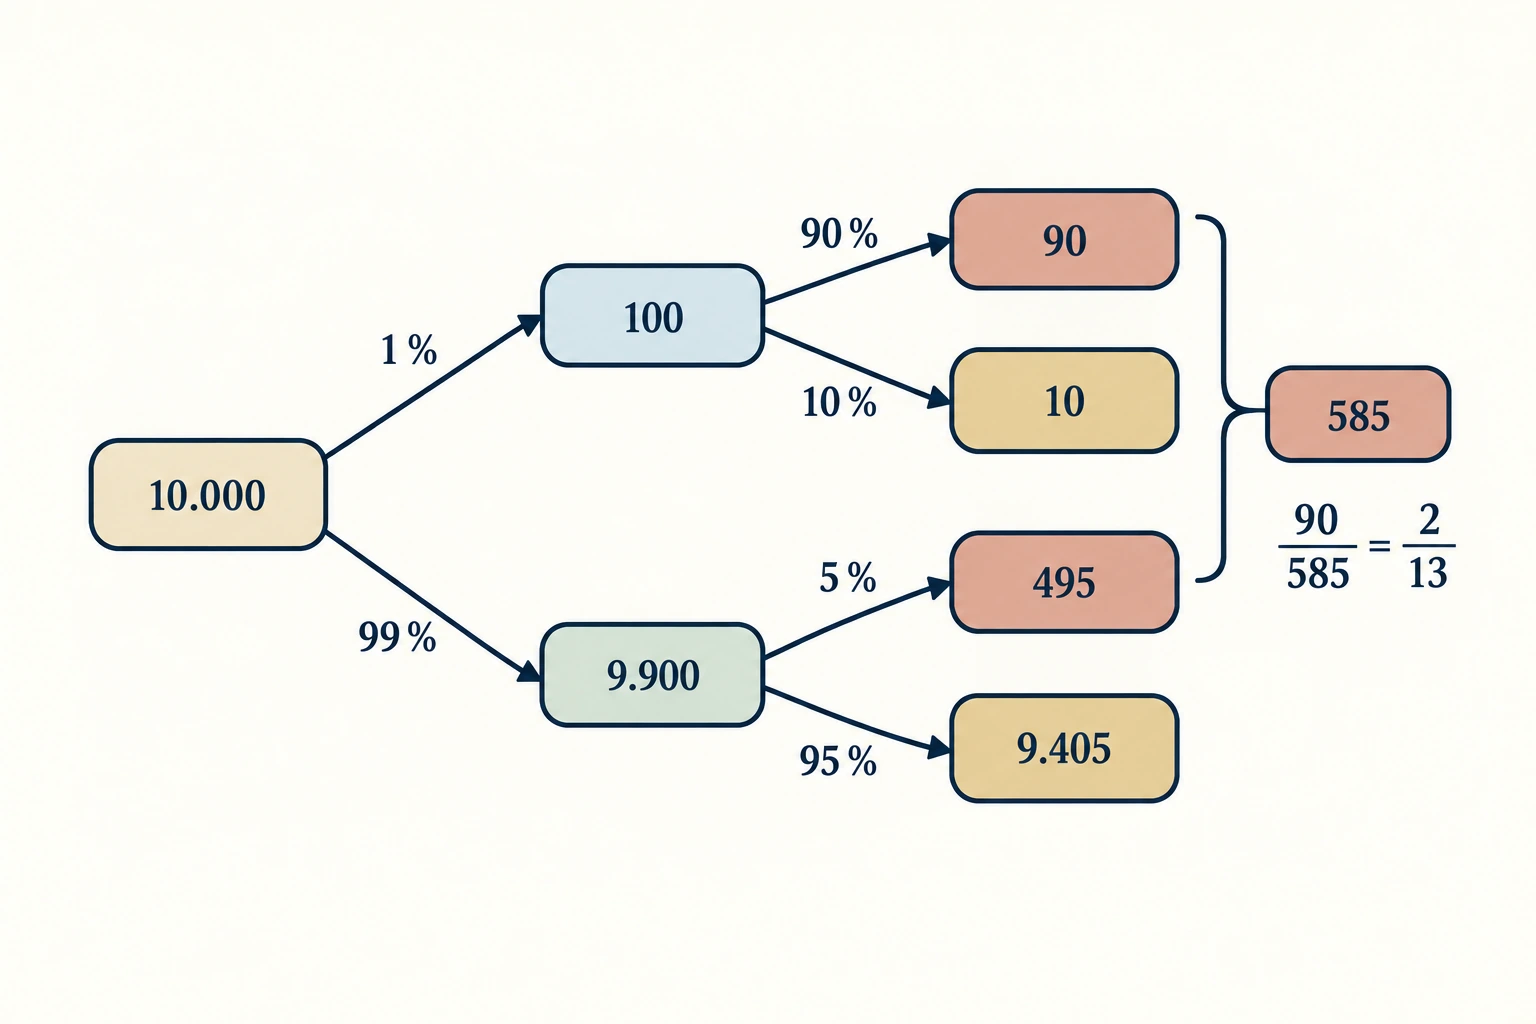
Las probabilidades de cada rama se aplican a su grupo de origen. Condicionar a señal positiva reúne las dos ramas positivas y usa ese total como denominador; las cantidades son esperadas
Dos eventos son independientes si
Dos eventos mutuamente excluyentes de probabilidad positiva no son independientes. Su intersección tiene probabilidad cero, mientras que el producto de sus probabilidades es positivo. Saber que ocurrió uno descarta el otro. En una extracción sin reposición, conocer el primer resultado cambia la composición para la segunda; la independencia necesitaría justificarse de otra manera. Tampoco comprobar independencia de cada par garantiza independencia conjunta de una colección mayor.
Esto último puede verse con dos señales binarias independientes y equiprobables. Sean
127.3. Variables aleatorias y distribuciones#
Puede interesar una cantidad asociada al resultado en vez de toda su descripción. Una variable aleatoria es una función que asigna un valor numérico a cada resultado del espacio, con las condiciones necesarias para que sus eventos tengan probabilidades definidas. «Aleatoria» no significa que cada número admisible sea igual de probable ni que la función cambie arbitrariamente.
Su distribución indica cómo se reparte la probabilidad entre valores o intervalos. Para una variable discreta
Si
Para una variable con distribución continua descrita por una densidad, la probabilidad de un intervalo se obtiene integrando esa densidad. Si
La densidad es no negativa y su integral total vale uno. Su altura no es una probabilidad puntual y puede superar uno. Si
Ejemplo construido. Un modelo de tiempo
Esto no convierte tres minutos en un valor lógicamente prohibido. Cada realización continua toma un valor, aunque cada punto por separado tenga probabilidad cero. Un registro redondeado a «3,0 minutos» representa un intervalo de resolución y puede tener probabilidad positiva. Tampoco es posible sumar sin condiciones las probabilidades de una colección no numerable de puntos como si fuera una lista finita.
La función de distribución acumulada,
127.4. Esperanza, varianza y leyes de los grandes números#
Un promedio probabilístico pondera los valores por sus probabilidades. Para una variable discreta con esperanza bien definida,
La suma recorre los valores posibles. En una distribución continua con densidad se usa la integral de
Ejemplo construido. Un retraso
La varianza mide el promedio de desviaciones cuadráticas respecto de la esperanza:
La desviación estándar es la raíz cuadrada de la varianza, seis minutos. No afirma que todos los retrasos se encuentren a seis minutos o menos de la media.
La esperanza de una suma es la suma de las esperanzas, sin exigir independencia, si las cantidades son integrables. La varianza de una suma necesita considerar dependencia. Para variables de magnitudes compatibles y con segundo momento finito,
donde
Una versión de la ley de los grandes números considera variables
La tolerancia tiene las unidades de
La ley no promete que la media se acerque en cada paso ni que corrija un sesgo de observación. Para ensayos independientes de probabilidad
Una racha tampoco obliga a compensarse. Si los ensayos siguen siendo independientes con probabilidad
127.5. Procesos aleatorios, dependencia y simulación#
Un proceso aleatorio reúne variables indexadas por tiempo u otro parámetro. Una distribución por instante no basta para describirlo: también se necesita cómo se relacionan los instantes. Dos procesos pueden tener igual probabilidad de interrupción en cada momento y presentar duraciones o agrupaciones de interrupciones diferentes.
Una cadena de Markov modela la transición entre estados bajo el supuesto de que, conocido el estado actual, el pasado no aporta información adicional para el siguiente. No exige que estados sucesivos sean independientes. Una versión homogénea mantiene las mismas probabilidades de transición en cada paso. (Pishro-Nik, cadenas de Markov).
Ejemplo construido. Un modelo de servicio usa pasos de una hora y dos estados: disponible e interrumpido. Si está disponible, la probabilidad de interrupción en el paso siguiente es
Partiendo del estado disponible, la interrupción en el primer paso tiene probabilidad
Si
La simulación genera realizaciones de un modelo para estudiar resultados difíciles de calcular directamente. Para el servicio, se puede generar en cada paso un nuevo número uniforme
Un generador seudoaleatorio produce una secuencia mediante un procedimiento determinista. Registrar su semilla, versión y configuración permite reproducir un cálculo bajo condiciones compatibles. La documentación de Python, por ejemplo, distingue reproducibilidad de semillas y posibles cambios de algoritmos entre versiones. Repetir una secuencia reproduce la simulación, no demuestra independencia empírica ni validez del modelo del servicio. (Python, generación seudoaleatoria y reproducibilidad).
Hay que distinguir el error de simulación de la incertidumbre del modelo. Aumentar el número de realizaciones puede reducir la variación del promedio calculado, pero no corrige probabilidades de transición equivocadas, estados insuficientes o relaciones omitidas. Para un suceso raro, una simulación corta puede no observarlo aunque tenga probabilidad positiva. Cero apariciones no equivale a una demostración de imposibilidad.
La probabilidad hace explícito qué se condiciona, qué varía y qué depende de qué. La estadística añade otra pregunta: cómo aprender esos pesos y relaciones a partir de datos que también tienen un proceso de selección y medición. Un cálculo coherente es necesario, pero necesita evidencia para convertirse en una descripción defendible de un sistema.
Preguntas de transferencia#
¿La misma prueba conserva la misma interpretación en otra población?#
Ejemplo construido. La proporción de defectos sube al diez por ciento y permanecen las probabilidades de señal del ejemplo:
Mostrar respuesta razonada
El cálculo es
Aumenta desde aproximadamente quince por ciento a aproximadamente sesenta y siete por ciento. La prueba conserva sus probabilidades dentro de cada estado; cambia la mezcla de estados que produce las señales.
¿Dos sucesos excluyentes pueden ser independientes?#
Dos eventos tienen probabilidades
Mostrar respuesta razonada
No. Su intersección tiene probabilidad cero y el producto es
¿Un valor con probabilidad cero está prohibido?#
En el tiempo uniforme entre cero y diez minutos,
Mostrar respuesta razonada
No. El valor exacto tiene probabilidad cero en un modelo continuo, pero un registro redondeado representa un intervalo. Con redondeo al décimo más cercano, «3,0» corresponde aproximadamente a
¿Mil copias de una observación equivalen a mil repeticiones?#
Se observa una variable
Mostrar respuesta razonada
No. Todos los registros son la misma variable, por lo que su media es exactamente
Fuentes y lecturas del capítulo#
Barbara Illowsky y Susan Dean. Introductory Statistics 2e, OpenStax (2023), secciones Terminology, Independent and Mutually Exclusive Events y Two Basic Rules of Probability. Consultadas para eventos y reglas de suma y producto, preservando las condiciones de independencia y los denominadores del condicionamiento. (Terminología; independencia; reglas).
Barbara Illowsky y Susan Dean. Misma obra, Mean or Expected Value and Standard Deviation, Binomial Distribution y Continuous Probability Functions. Consultadas para promedios ponderados, condiciones binomiales y probabilidades como integrales de densidad. (Esperanza; binomial; densidades).
MIT OpenCourseWare, John Tsitsiklis y Patrick Jaillet. Introduction to Probability, lección 1, Probability Models and Axioms (2018). Diapositivas consultadas para distinguir resultados, eventos y las reglas que debe satisfacer una asignación de probabilidades. (Documento).
Hossein Pishro-Nik. Introduction to Probability, Statistics, and Random Processes (2014), versión web, secciones Conditional Probability, Bayes' Rule, Cumulative Distribution Function, Covariance and Correlation e introducción a cadenas de Markov. Se consultaron sus definiciones y relaciones; los ejemplos numéricos del capítulo son construidos. (Condicionamiento; Bayes; distribución acumulada; covarianza; Markov).
Scott Sheffield. 18.440: Lecture 30 — Weak law of large numbers y Lecture 33 — Markov Chains, MIT (2014). Diapositivas consultadas para convergencia en probabilidad, la prueba con varianza finita y distribuciones de transición y estacionarias. (Grandes números; cadenas).
Python Software Foundation. random — Generate pseudo-random numbers, documentación consultada el 29 de septiembre de 2026. Fuente para las condiciones de reproducción de secuencias seudoaleatorias; no se usa como garantía de validez de una simulación científica. (Documentación).