PARTE XII · Matemáticas: estructuras, cambio e incertidumbre
128
Estadística: variación, estimación e inferencia
Aprender de datos sin confundir precisión con alcance
En este capítulo
Cinco observaciones pueden sumar treinta y describir situaciones muy diferentes. Los valores 4, 5, 6, 7 y 8 tienen media seis; también la tienen 2, 2, 6, 10 y 10. El promedio coincide, pero la segunda serie presenta mayor separación. Si seis unidades fuera un límite operativo, la media no resolvería cuántas observaciones lo superan, cuánto lo superan ni por qué aparecen agrupadas.
La estadística estudia cómo describir esa variación y cómo aprender de observaciones que sólo muestran una parte de una población o de un proceso. Una descripción resume los registros disponibles. Una inferencia afirma algo más allá de ellos y necesita justificar el puente. El cálculo puede ser impecable y el puente inadecuado: conocer con mucha precisión a quienes respondieron una consulta no equivale a conocer a quienes quedaron fuera.
128.1. Poblaciones, muestras y procesos de datos#
Antes de promediar conviene establecer qué representa cada fila. Una fila puede corresponder a una persona, una parcela, un viaje o una lectura de un instrumento. La unidad de observación no coincide necesariamente con la unidad sobre la que se quiere concluir. Cien lecturas de una sola parcela describen esa parcela con detalle; no constituyen cien parcelas independientes. La relación entre registros forma parte del problema estadístico, aunque una tabla no la muestre.
La población objetivo es el conjunto al que se refiere la pregunta. Debe delimitarse por características, lugar y periodo cuando corresponda. «Las solicitudes recibidas este trimestre» y «las solicitudes que podrían recibirse bajo otra regla» son objetivos distintos. El primero puede ser una colección finita ya existente; el segundo requiere modelar un proceso y condiciones que aún no se han observado. Una muestra es la parte observada, no una reproducción garantizada del conjunto. (OpenStax, datos, muestreo y variación).
Ejemplo construido. Se desea estimar el tiempo entre presentar y resolver una solicitud en una oficina, durante un trimestre. La tabla disponible sólo contiene solicitudes resueltas al finalizarlo. Las pendientes no tienen todavía un tiempo total conocido; las retiradas pueden haber desaparecido de la tabla. Calcular la media de los casos resueltos responde a una pregunta concreta, pero puede subestimar la duración que interesa si los casos más largos siguen abiertos. Añadir más filas del mismo registro no recupera los casos ausentes.
Aquí la falta de un dato es informativa: el procedimiento que lo vuelve desconocido está ligado a la duración. Registrar para cada solicitud su fecha de entrada, estado y tiempo de seguimiento permitiría formular otra estrategia; no bastaría rellenar todas las pendientes con cero. El ejemplo señala un principio general: seleccionar, medir, clasificar y conservar datos modifica lo que puede aprenderse de ellos.
Un parámetro resume una característica de la población o del modelo, como su media o una proporción. Un estadístico se calcula a partir de la muestra, como su media observada. La diferencia no depende de usar letras griegas o latinas, sino de qué conjunto describe cada cantidad. Si se dispone de todos los registros de una población finita y son correctos, su media es conocida para esa colección. Aun así, puede quedar incertidumbre de medición o sobre el comportamiento de un periodo futuro.
La selección aleatoria permite describir probabilísticamente qué muestras podrían haberse obtenido. En un muestreo aleatorio simple de tamaño fijo, todas las muestras de ese tamaño tienen la misma probabilidad. Otros diseños pueden dar probabilidades distintas a diferentes unidades y compensarlas mediante ponderaciones. La igualdad de probabilidades individuales no es una condición universal de toda inferencia válida; conocer y tratar el diseño sí es decisivo. El capítulo 134 desarrollará los diseños de muestreo y los errores de encuesta. (Statistics Canada, ponderación según el diseño).
El sesgo de un estimador es su diferencia media respecto del parámetro bajo las repeticiones definidas por el diseño o el modelo. No significa que toda muestra se equivoque en la misma cantidad. Puede originarse también una discrepancia persistente al estudiar una población mal delimitada o una medida que representa otra cosa. La variación entre muestras y esa discrepancia no son intercambiables. Un instrumento que añade siempre una cantidad constante puede producir registros poco dispersos y, a la vez, desplazados.
Con muestras independientes y comparables, aumentar el tamaño suele reducir la variación de muchos estimadores. No elimina automáticamente errores de cobertura, no respuesta, definiciones inconsistentes ni cambios de proceso. La pregunta pertinente es cuánto crece la información útil. Duplicar una tabla, observar repetidamente una misma unidad o incorporar registros de otra población puede aumentar el número de filas sin mejorar la inferencia prevista.
128.2. Describir distribuciones sin ocultar su forma#
Una distribución empírica conserva los valores observados y sus frecuencias. Puede resumirse, pero cada resumen descarta información. La media usa todos los valores y permite reconstruir el total al multiplicarla por el número de observaciones. La mediana se basa en el orden: con una cantidad impar de registros es el valor central; con una cantidad par, una convención habitual toma la media de los dos centrales. Cambiar mucho un valor extremo puede modificar mucho la media y dejar intacta la mediana. (OpenStax, medidas del centro).
Ejemplo construido. Cinco entregas tardan 2, 3, 3, 4 y 18 días. El total es treinta días, la media seis y la mediana tres. Si la última duración pasa a treinta y ocho días, la media sube a diez, mientras la mediana permanece en tres. Para describir una entrega central, la mediana puede resultar útil; para calcular el tiempo total consumido, la media conserva una relación que la mediana no tiene. No hay una elección correcta al margen de la pregunta.
Los cuantiles sitúan cortes en la distribución ordenada. La mediana corresponde al corte de la mitad; los cuartiles separan aproximadamente cuartos. En muestras pequeñas existen distintas convenciones de interpolación, por lo que un informe o programa debe especificar la empleada si la diferencia importa. El rango intercuartílico, diferencia entre los cuartiles tercero y primero, resume la extensión central sin depender tanto de los extremos. No describe toda la dispersión y puede omitir una cola larga que sea operativamente decisiva.
Para los valores
El índice
En las dos series de la apertura, las sumas de desviaciones cuadráticas son diez y sesenta y cuatro. Sus varianzas muestrales son
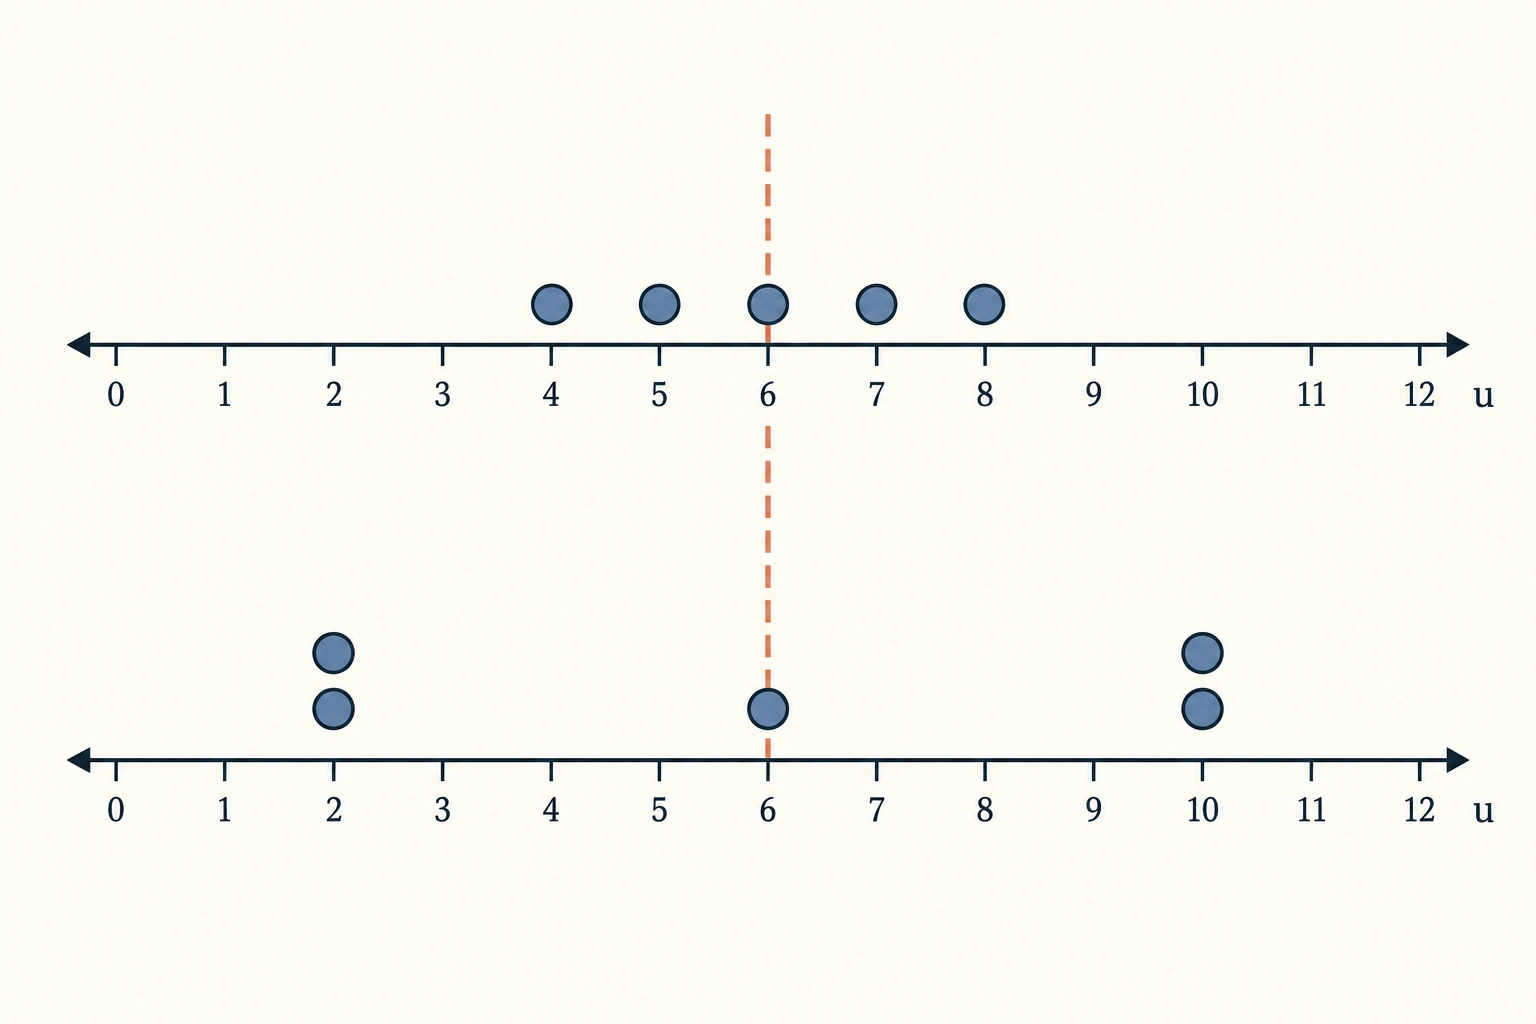
Cada punto representa un dato construido. La referencia común fija la media; las distancias horizontales revelan la dispersión que ese resumen oculta
Los diagramas de puntos conservan las observaciones cuando son pocas. Un histograma agrupa valores en intervalos; su aspecto cambia con el ancho y la posición de esos intervalos. Si los anchos son desiguales y se quiere representar proporción mediante área, la altura debe dividir la proporción por el ancho. De otro modo una barra ancha puede sugerir indebidamente mayor concentración. Un histograma puede revelar agrupaciones, asimetría o extremos, pero no demostrar por sí solo que la población tiene una forma particular. (NIST, histogramas).
Una observación extrema exige averiguar su procedencia. Puede ser una equivocación, una condición infrecuente real o un indicio de que se mezclaron procesos diferentes. Eliminarla sólo porque estorba al resultado confunde depuración con selección favorable. Es útil conservar el dato original, explicar cualquier exclusión y comparar cómo cambia la conclusión. Del mismo modo, una nube de puntos entre dos variables muestra relaciones que los resúmenes separados ocultan; una curva o grupos distintos pueden hacer engañosa una única correlación lineal. (NIST, diagramas de dispersión).
128.3. Estimadores, intervalos e incertidumbre#
Un estimador es una regla que transforma una muestra en una estimación. La regla tiene propiedades bajo las repeticiones posibles; el número obtenido es una realización de esa regla. La distribución de los resultados del estimador entre muestras es su distribución de muestreo. No debe confundirse con la distribución de los individuos observados. Los tiempos de entrega pueden variar mucho aunque su media se estime con precisión.
Para observaciones independientes de una distribución común con varianza
Un intervalo de confianza añade a una estimación una regla para cubrir el parámetro. Un procedimiento del noventa y cinco por ciento tiene esa cobertura bajo las repeticiones y supuestos que lo definen; algunos intervalos realizados no contendrán el parámetro. No significa que el noventa y cinco por ciento de los individuos esté dentro del intervalo ni, en su interpretación frecuentista, que se haya calculado una probabilidad posterior del parámetro fijo. (NIST, significado de los intervalos de confianza).
La distribución normal tiene una densidad simétrica en forma de campana, fijada por su media y su desviación estándar. Adoptarla es un supuesto sobre la forma de la variación, no una consecuencia de calcular esos dos resúmenes.
Ejemplo construido. Un modelo supone veinticinco observaciones independientes de una población normal, con media desconocida y desviación estándar conocida de cinco unidades. La media observada es veinte. El error estándar es
Si se obtuvieran cien observaciones bajo las mismas condiciones, el error estándar sería
Con desviación poblacional desconocida y observaciones normales independientes, se utiliza
Un intervalo bayesiano de credibilidad responde a otra definición: asigna probabilidad al parámetro dado los datos, una distribución previa y un modelo probabilístico. La actualización usa el condicionamiento del capítulo anterior. Su interpretación no elimina la necesidad de comprobar el modelo ni de explicar la información previa. No puede intercambiarse automáticamente su significado con la cobertura de un intervalo de confianza, aunque ambos produzcan límites numéricos parecidos. (Pishro-Nik, intervalos bayesianos).
La incertidumbre comunicada debe corresponder a la pregunta. Un intervalo para una media, uno para predecir un caso nuevo y uno que integre errores de medición no son objetos equivalentes. Una presentación útil identifica el parámetro, la población, el nivel, el método y los supuestos principales. Muchas cifras decimales añaden apariencia de precisión; no amplían el alcance de la evidencia.
128.4. Pruebas, errores y tamaños de efecto#
Una prueba estadística compara los datos con lo que sería esperable bajo una hipótesis y un modelo. La hipótesis nula,
El valor p es la probabilidad, bajo la hipótesis nula y los supuestos de la prueba, de obtener un estadístico al menos tan extremo como el observado, según el criterio de extremidad elegido. No es la probabilidad de que
Ejemplo construido. Se contrasta una media de referencia de veinte unidades en el modelo normal con desviación conocida de cinco. Con veinticinco observaciones y media observada veintiuno, la diferencia es una unidad y el error estándar una. El estadístico normal es
Una necesidad práctica puede fijar, por ejemplo, dos unidades como diferencia mínima relevante. Entonces estimar una diferencia pequeña con precisión no la vuelve grande. Si una muestra pequeña no descarta diferencias de ese tamaño, su resultado tampoco demuestra ausencia de un efecto importante. El tamaño de efecto expresa la magnitud de la relación o diferencia. Conviene informar unidades originales y, cuando ayude la comparación, una medida estandarizada cuya definición y denominador queden claros.
Si se decide rechazar
«No rechazar» conserva una hipótesis entre las compatibles con la información; no certifica su verdad. Probar equivalencia dentro de un margen requiere formular ese margen y una prueba apropiada. Asimismo, superar un umbral no demuestra causalidad: una asociación puede depender de selección, condiciones compartidas o medición. Los capítulos 133 y 136 abordarán qué diseños permiten sostener conclusiones causales.
La elección entre muchos análisis afecta los errores. Si se hacen veinte pruebas independientes con nulas verdaderas y probabilidad exacta de rechazo
Elegir sólo la comparación favorable, cambiar el análisis después de ver el resultado o detener la recolección al cruzar un umbral altera la referencia probabilística. La exploración sigue siendo valiosa, pero debe reconocerse como tal y confirmarse con procedimientos adecuados. Informar el conjunto de decisiones y resultados permite evaluar la inferencia. Un umbral puede servir en una regla operativa; no sustituye por sí solo el juicio sobre evidencia, costes y consecuencias.
128.5. Modelos estadísticos, supuestos y diagnóstico#
Un modelo estadístico representa relaciones y variación entre observaciones. Una regresión lineal sencilla propone
Los métodos de ajuste buscan parámetros a partir de datos. Minimizar desviaciones cuadráticas, como en el capítulo 124, determina una recta ajustada; no justifica automáticamente probabilidades de error, intervalos o interpretación causal. Distintos usos requieren distintos supuestos. La normalidad no es necesaria para calcular una recta de mínimos cuadrados; puede ser necesaria para ciertas distribuciones exactas de sus estadísticos. La dependencia y la varianza cambiante afectan a los errores estándar calculados con fórmulas ordinarias.
Un residuo es la diferencia entre el dato observado y su predicción ajustada. No es el error verdadero del modelo, cuyos parámetros no se conocen. Examinar residuos frente a valores ajustados, variables explicativas y orden temporal puede revelar curvaturas, dispersión cambiante o estructura temporal. Un coeficiente de ajuste alto no excluye esos problemas. (NIST, validación y residuos).
Ejemplo construido. Un registro relaciona duración de transporte y distancia. Una recta puede dejar residuos positivos en distancias muy cortas y largas, y negativos en las intermedias. Ese patrón indica que la forma lineal omite estructura; no identifica por sí solo la causa. Pueden intervenir rutas, tiempos fijos, agrupaciones o una relación curva. Introducir un término cuadrático podría mejorar el ajuste, pero también conviene comprobar la procedencia de los grupos y reservar observaciones para evaluar predicción.
Cuanto más flexible es un modelo, más puede adaptarse a detalles particulares de la muestra. El sobreajuste aparece cuando esa adaptación empeora la generalización. Evaluar con datos que participaron en elegir la forma del modelo puede dar una impresión demasiado favorable. Una separación para evaluación debe respetar cómo se usará la predicción: en una serie temporal, mezclar indiscriminadamente pasado y futuro puede introducir información que no estaría disponible en el momento de predecir. (Hyndman y Athanasopoulos, evaluación con datos nuevos; validación temporal).
El diagnóstico tampoco se resuelve con una lista rígida de pruebas. Una desviación pequeña puede importar poco para estimar una media y mucho para predecir valores extremos. El patrón puede resultar invisible en una muestra pequeña, y una diferencia irrelevante volverse detectable en una enorme. Conviene relacionar cada comprobación con el uso del modelo, contrastar conclusiones bajo alternativas razonables y distinguir lo que los datos identifican de lo que se ha impuesto por conveniencia.
La inferencia termina en una afirmación con alcance: sobre una cantidad, para una población o proceso, bajo condiciones declaradas. Su precisión estadística es una parte de su calidad. La siguiente decisión puede exigir escoger entre acciones con recursos limitados; para ello, una estimación debe combinarse con objetivos y consecuencias que la estadística no decide por sí sola.
Preguntas de transferencia#
Un registro grande con casos pendientes#
Ejemplo construido. Una oficina duplica los registros de solicitudes resueltas, pero siguen sin incluirse las pendientes. El intervalo para la media de las resueltas se estrecha. ¿Se ha estimado mejor la duración total de todas las solicitudes?
Mostrar respuesta razonada
Se puede haber reducido la variación del estimador para los casos resueltos, si los nuevos registros aportan información apropiada. La exclusión de pendientes sigue vinculada a la duración; por tanto, no se ha reparado el puente hacia todas las solicitudes. Hace falta registrar su seguimiento y formular un análisis que trate ese proceso, o limitar expresamente la conclusión a los casos resueltos.
Media estable, carga distinta#
Ejemplo construido. Dos servicios informan la misma media de duración. Uno tiene todos sus registros cerca de ella; el otro alterna duraciones muy cortas y muy largas. ¿Qué dato adicional conviene pedir antes de planificar capacidad?
Mostrar respuesta razonada
La distribución de duraciones, sus cuantiles y su secuencia permiten estudiar dispersión, extremos y agrupamiento. La media conserva información sobre el total por caso, pero no sobre la concentración de carga ni el riesgo de esperas largas. Incluso una desviación estándar común sería insuficiente para reconstruir colas y dependencia temporal.
Un intervalo que no describe individuos#
Una media tiene intervalo de confianza estrecho, pero las observaciones son muy dispersas. ¿Hay contradicción?
Mostrar respuesta razonada
No. El intervalo estudia incertidumbre del estimador de la media, mientras la dispersión describe diferencias entre observaciones. Muchas unidades independientes pueden permitir conocer bien la media de una población heterogénea. Para un individuo nuevo se necesita una predicción con su propia variabilidad, y para extrapolar a otra población se necesita justificar comparabilidad.
Una diferencia pequeña con un valor p pequeño#
Ejemplo construido. Un análisis detecta una diferencia de una unidad con gran precisión, aunque la mejora mínima útil se fijó antes en dos. ¿El resultado estadístico obliga a adoptar el cambio?
Mostrar respuesta razonada
No. La incompatibilidad con una diferencia exactamente cero y la utilidad de una diferencia son preguntas distintas. Deben considerarse la estimación, su intervalo, la relevancia definida, costes y efectos adicionales. Si la diferencia es asociativa, también falta justificar qué parte se produciría al intervenir.
Fuentes y lecturas del capítulo#
Barbara Illowsky y Susan Dean. Introductory Statistics 2e, OpenStax (2023), secciones Data, Sampling, and Variation in Data and Sampling, Measures of the Center of the Data y Measures of the Spread of the Data. Consultadas para distinguir población, muestra y variación, y para las convenciones de centro y dispersión. Las limitaciones de los diseños se explicitan sin equiparar todo muestreo válido con probabilidades iguales. (Muestreo; centro; dispersión).
Barbara Illowsky y Susan Dean. Misma obra, A Single Population Mean using the Student t Distribution y Outcomes and the Type I and Type II Errors. Consultadas para el intervalo con dispersión estimada y para la distinción entre rechazo, errores y potencia. (Student; errores).
NIST/SEMATECH. e-Handbook of Statistical Methods, páginas Histogram y Scatter Plot. Apoyan la descripción gráfica de formas y relaciones y la distinción entre alturas y áreas en histogramas. (Histogramas; dispersión entre variables).
NIST/SEMATECH. Misma obra, What are confidence intervals? y Critical Values of the Student's t Distribution. Consultadas para cobertura repetida, condiciones del intervalo normal y los factores críticos empleados en los ejemplos construidos. (Intervalos; tabla de Student).
American Statistical Association. American Statistical Association Releases Statement on Statistical Significance and P-Values (7 de marzo de 2016). Comunicación institucional consultada que expone los seis principios de la declaración; se utiliza para evitar interpretar valores p como probabilidades de hipótesis o medidas de importancia práctica. (Documento).
NIST/SEMATECH. e-Handbook of Statistical Methods, How can I tell if a model fits my data?. Consultada para residuos y el límite de resumir la validación mediante un único coeficiente de ajuste. (Validación).
Statistics Canada. Statistics: Power from Data!, sección 3.5.1 Weighting (actualización de 2021). Consultada para explicar por qué un diseño puede usar probabilidades de inclusión distintas y necesitar ponderaciones apropiadas. (Documento).
Hossein Pishro-Nik. Introduction to Probability, Statistics, and Random Processes (2014), versión web, Bayesian Interval Estimation. Consultada para la definición de credibilidad como probabilidad posterior del intervalo. (Sección).
Rob J. Hyndman y George Athanasopoulos. Forecasting: Principles and Practice, tercera edición (2021), versión web consultada el 29 de septiembre de 2026, secciones Evaluating point forecast accuracy y Time series cross-validation. Consultadas para distinguir residuos de evaluación con datos nuevos y preservar el orden temporal al comprobar predicción. (Evaluación; validación temporal).