PARTE XIV · Mente, conducta y desarrollo humano
148
Inteligencia y capacidades cognitivas
Qué representan las puntuaciones y hasta dónde llegan sus predicciones
En este capítulo
Ejemplo construido. Dos aspirantes a un taller resuelven una prueba de razonamiento. Obtienen 108 y 112 en una escala transformada. La dirección propone llamar al segundo «más inteligente» y asignarle todas las tareas difíciles. Antes de aceptar esa interpretación, interesa conocer qué tareas se incluyeron, qué significan los puntos, cuánto error de medida hay y qué evidencia relaciona la prueba con el trabajo. La diferencia observada es una cifra; su significado requiere un argumento.
La inteligencia designa un conjunto de capacidades relacionadas con aprender, comprender, razonar y resolver problemas, según la teoría utilizada. No hay una única definición que agote todos los usos del término. Las capacidades cognitivas son posibilidades de desempeño en actividades de conocimiento y procesamiento; las habilidades describen formas de hacer que pueden adquirirse y desarrollarse. Estas palabras se solapan en algunos marcos. Aquí importa especificar qué actividad y qué medida representan, en lugar de dar por supuesto que una etiqueta las reúne sin pérdida.
El capítulo anterior mostró que el juicio depende de información, reglas y entorno. Esa dependencia también importa al medir capacidades. Reconocerla no elimina la utilidad de las pruebas: exige interpretar sus resultados respecto a tareas, poblaciones y usos definidos.
148.1. Capacidades, habilidades y modelos de inteligencia#
Una batería cognitiva reúne varias tareas para examinar desempeño. Puede incluir razonamiento con relaciones, comprensión verbal, memoria de trabajo, velocidad u otras dimensiones. El resultado de una sola operación no representa automáticamente todas ellas. También hay conocimientos específicos necesarios para ejecutar actividades reales que una batería general no pretende cubrir.
La síntesis de Neisser y colaboradores explica que los rendimientos en distintas pruebas suelen correlacionarse positivamente y que sus relaciones pueden organizarse mediante factores generales y específicos. El factor general, denominado
Un factor es una variable del modelo que representa relaciones entre medidas; no se observa directamente como se cuenta un acierto. El análisis factorial examina cómo pueden describirse covariaciones mediante un conjunto de variables comunes y específicas. Sus resultados dependen de tareas, muestra, restricciones y método. Una agrupación numérica necesita interpretación y contraste, no sólo un nombre atractivo.
Ejemplo construido. Una prueba verbal y otra numérica covarían entre aspirantes. Podrían compartir exigencias de comprensión de instrucciones, atención o experiencia educativa, además de otros procesos. Observar la correlación no permite escoger entre esas explicaciones. Para contrastar un mecanismo harían falta tareas y diseños que separasen las alternativas pertinentes.
La presentación de modelos en Psychology 2e distingue razonamiento fluido, conocimientos adquiridos y organizaciones jerárquicas de capacidades. Razonamiento fluido se refiere a resolver relaciones y problemas relativamente nuevos; conocimiento cristalizado, al conocimiento y recursos adquiridos. No son actividades puras: resolver una tarea nueva suele requerir comprender símbolos e instrucciones aprendidos.
Una jerarquía puede organizar capacidades generales, amplias y específicas. Esa organización permite estudiar relaciones sin exigir que todas las tareas sean intercambiables. Dos personas con una puntuación compuesta semejante pueden mostrar perfiles distintos. A la inversa, una diferencia pequeña entre subpruebas puede depender de error y no justificar un perfil estable de fortalezas y debilidades.
Existen propuestas que amplían el término hacia capacidades prácticas, creativas o diversas formas de desempeño. Nombrar campos valiosos no demuestra que constituyan factores independientes, ni que una clasificación identifique el método adecuado para enseñar a cada persona. Cada propuesta requiere definición operacional, medidas y evidencia para las inferencias que pretende sostener.
Ejemplo construido. Un aspirante domina el mantenimiento de una prensa porque la conoce desde hace años. Otro resuelve mejor relaciones nuevas en papel. No hay que negar ninguno de los resultados para distinguir conocimientos del oficio y desempeño en la prueba. Si se necesita reparar la prensa mañana, la familiaridad puede ser crucial; si se necesita aprender una operación nueva, interesa investigar qué predice ese aprendizaje.
La psicometría estudia cómo construir, analizar e interpretar medidas psicológicas. No reduce una persona a un número por necesidad: proporciona herramientas para comprobar si una puntuación representa una pregunta definida. El riesgo aparece cuando una medida útil para un propósito se extiende sin evidencia a creatividad, carácter, valor personal o destino.
También debe separarse capacidad de oportunidad de demostrarla. Si alguien no comprende el idioma de la instrucción, el fallo puede mezclar demandas lingüísticas con el proceso buscado. Ese problema no se resuelve afirmando que toda prueba es inútil ni ignorándolo porque la puntuación sea exacta como conteo. Se resuelve examinando qué produjo la respuesta y qué interpretación admite.
148.2. Medición, fiabilidad y validez#
Una prueba define estímulos, condiciones, respuestas y reglas de puntuación. La puntuación bruta puede ser un conteo o una combinación de resultados. Una puntuación transformada cambia su escala mediante una regla; las normas sitúan el resultado respecto a un grupo de referencia. Ninguna transformación añade por sí sola capacidad explicativa.
Ejemplo construido. En un grupo de referencia ficticio, la puntuación bruta tiene media
Las escalas de cociente intelectual contemporáneas suelen utilizar comparaciones normativas por edad. El CI o cociente intelectual es una puntuación de determinadas pruebas e interpretaciones, no una proporción física de conocimiento ni un porcentaje de capacidad total. Una misma posición respecto a la edad puede acompañar cambios importantes de desempeño absoluto durante el desarrollo.
La fiabilidad concierne a consistencia o precisión frente a fuentes de error definidas. La validez concierne al apoyo que evidencia y teoría ofrecen a una interpretación para un uso. Los Standards for Educational and Psychological Testing de 2014 sitúan la validación en esas interpretaciones y usos, no en una aprobación universal del instrumento. Un resultado consistente puede no representar el atributo propuesto.
Ejemplo construido. Contar palabras técnicas conocidas podría producir resultados repetibles. Si se interpreta como medida de toda capacidad para aprender un oficio nuevo, la repetibilidad no basta. La tarea puede representar vocabulario previo y omitir actividades decisivas. Para justificar la interpretación habría que mostrar qué relación tiene con el aprendizaje buscado y qué alternativas explican sus resultados.
Un modelo clásico ayuda a separar componentes. Modelo construido. Sea
Suponemos error de media cero, varianza constante y ausencia de covariación entre
Fijamos valores construidos
No es una probabilidad clínica de poseer cierta capacidad, ni un intervalo del máximo alcanzable con enseñanza. Tampoco garantiza cubrir cambios de idioma, fatiga sistemática u otras alteraciones no representadas como el error asumido. En una aplicación real importaría cómo se estimó la precisión y si cambia por nivel de puntuación y grupo.
La diferencia también tiene error. Si los errores de ambos aspirantes son independientes y cada uno tiene desviación seis, el error estándar de la diferencia vale
Este cálculo no demuestra igualdad de capacidades; muestra que esos supuestos y resultados no precisan una diferencia con el signo pretendido. Si los errores covarían, la fórmula cambia. Mirar únicamente el solapamiento de intervalos separados tampoco sustituye al análisis directo de la diferencia.
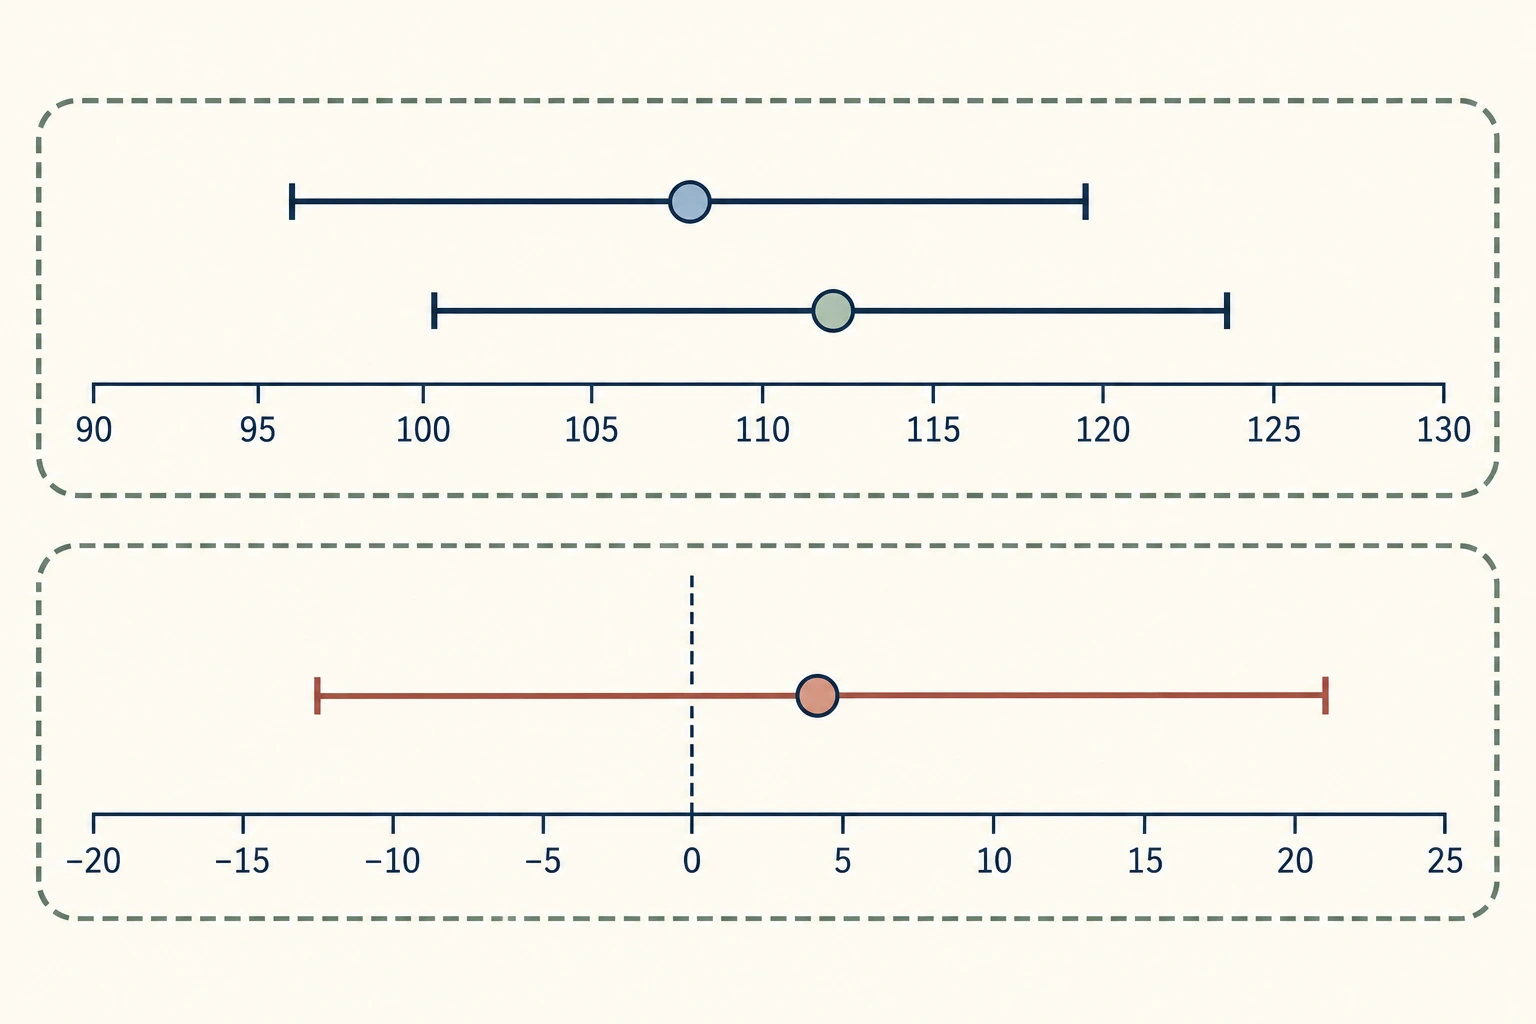
Intervalos bajo un modelo de error explícito. La diferencia requiere su propio cálculo; los números no describen potencial ni valor personal
148.3. Desarrollo, aprendizaje y ambiente#
Las capacidades se estudian durante el desarrollo y en relación con experiencias. Describir diferencias en una edad no explica cómo surgieron. Comparar personas con distinta escolaridad tampoco aísla el efecto de la educación: pueden diferir previamente en capacidades, recursos y oportunidades. Para investigar cambio causal se necesitan diseños que aborden esas relaciones.
El metaanálisis de Ritchie y Tucker-Drob reunió diseños con control de capacidad previa, cambios de políticas educativas y fechas de entrada escolar. Sus resultados apoyan efectos de educación sobre puntuaciones cognitivas, con límites propios de cada diseño. No establecen que cada año adicional produzca el mismo incremento en toda persona, ni que los efectos puedan sumarse indefinidamente. Tampoco identifican de forma completa los mecanismos.
Ejemplo construido. Un curso enseña a interpretar planos y mejora la resolución de ejercicios de planos. La mejora es relevante si ese era el objetivo. Para afirmar aumento de una capacidad general harían falta tareas diferentes y evidencia de transferencia, no sólo repetir lo entrenado con otros dibujos. Transferencia designa utilización o efecto del aprendizaje en actividades distintas de las practicadas; su alcance debe medirse.
Mantener una puntuación normativa mientras se aprende no significa ausencia de desarrollo. Si el grupo de referencia de la nueva edad también resuelve tareas más complejas, la posición relativa puede permanecer similar y el desempeño absoluto aumentar. Por eso hay que precisar si se compara cantidad resuelta, nivel de dificultad, posición entre pares o cambio en una escala común.
El material de MedlinePlus sobre genética e inteligencia presenta contribuciones genéticas y ambientales y la dificultad de separarlas. La semejanza familiar no identifica por sí sola su proporción: familiares pueden compartir condiciones además de variantes genéticas. Una asociación genética tampoco equivale a descubrir un gen que determine de manera única una capacidad compleja.
La heredabilidad es un parámetro de variación en una población y unas condiciones. La explicación de MedlinePlus sobre este concepto advierte que no reparte un rasgo individual entre porcentajes genéticos y ambientales, ni indica cuánto podría cambiarse. Una estimación puede variar al cambiar población, ambiente o edad. Interpretarla exige especificar qué variación y qué modelo se estudiaron.
Ejemplo construido. Si las condiciones educativas fueran muy semejantes en una población, su variación contribuiría de otro modo a las diferencias observadas que en otra con oportunidades muy desiguales. Esto no permite asignar una cifra de heredabilidad sin datos; muestra por qué una proporción de variación no puede trasladarse automáticamente. Tampoco permite deducir las causas de una diferencia entre medias de grupos a partir de una estimación dentro de uno de ellos.
Genes y entorno no son piezas que puedan restarse de una persona para observar el resto. Las experiencias pueden depender de características de quien participa y, a su vez, influir en su desarrollo. Separar relaciones requiere diseños y supuestos; el lenguaje «natural» o «aprendido» puede esconder esa complejidad si se utiliza como explicación final.
La posibilidad de cambio tampoco justifica prometer aumentos universales mediante ejercicios breves. Entrenamiento, familiaridad con el formato, conocimiento específico y cambio amplio son hipótesis diferentes. Una intervención debe mostrar qué mejoró, cuánto duró y en qué tareas se observó. No es necesario negar una mejora específica para delimitar su alcance.
En el taller, la evaluación puede identificar una necesidad de instrucción en lugar de fijar una etiqueta permanente. Si el objetivo es aprender una operación, observar el desempeño antes, durante y después de ayuda definida aporta información distinta de una única clasificación inicial. Cualquier interpretación de capacidad para aprender tendría que apoyarse en esa evidencia, no sólo en una intención educativa favorable.
148.4. Comparación entre tareas y contextos#
Dos puntuaciones numéricas no son comparables sólo porque usen cifras parecidas. Treinta aciertos en una prueba de cuarenta preguntas y treinta en otra de sesenta tienen denominadores distintos; aun convertidos en porcentajes, las tareas pueden diferir en dificultad y contenido. Igual porcentaje tampoco garantiza igual capacidad medida.
Ejemplo construido. Una prueba A contiene ejercicios de relaciones espaciales sencillas y otra B relaciones verbales complejas. Obtener 75 % en ambas describe proporciones de aciertos. No permite afirmar que las capacidades espacial y verbal sean iguales. Haría falta una interpretación que considerase tareas, precisión y referencias adecuadas para comparar los resultados.
La equivalencia de medida requiere que una comparación conserve el significado relevante de las puntuaciones. La invariancia examina, bajo modelos concretos, si relaciones entre tareas y variables medidas son suficientemente semejantes entre grupos o momentos. No consiste en exigir igual media a todos los grupos ni demuestra por sí sola que sus experiencias hayan sido iguales.
Las directrices de la International Test Commission para traducir y adaptar pruebas requieren considerar idioma, cultura, contenido y principios de evaluación. Traducir palabras no asegura que una tarea conserve dificultad, instrucciones o significado. La adaptación necesita evidencia; no basta aplicar sin cambios las normas de la versión original a cualquier población.
Ejemplo construido. Una pregunta de razonamiento utiliza una palabra técnica conocida por un grupo y desconocida por otro. Si el objetivo era inferir una relación nueva, el término añade una demanda de conocimiento previo. Sustituirlo puede mejorar acceso a la tarea, pero también cambiar su dificultad. La versión revisada necesita examinarse antes de tratar sus puntuaciones como equivalentes.
Una prueba con figuras no está libre de toda experiencia cultural. Comprender que se debe elegir una respuesta, explorar alternativas y atender a un tiempo límite implica familiaridad con prácticas de evaluación. Ese reconocimiento no establece que todo formato esté sesgado: indica variables que conviene investigar para el uso propuesto.
También importa la accesibilidad: la posibilidad de demostrar el atributo buscado sin barreras ajenas a él. Si se examina razonamiento y la respuesta exige una habilidad motora no pertinente, la limitación puede contaminar el resultado. Si se examina velocidad motora, esa misma exigencia forma parte de la pregunta. La adecuación de un ajuste depende del atributo, no del nombre del dispositivo utilizado.
La administración estandarizada mantiene condiciones y reglas definidas para favorecer interpretación. No obliga a ignorar necesidades de acceso. Un cambio documentado puede ser adecuado, pero sus efectos sobre el significado de la puntuación deben examinarse. Alterar instrucciones, tiempo o ayudas sin registrarlo impide saber qué comparación se está haciendo.
El contexto del taller también puede diferir del de la prueba. Una actividad real permite consultar un plano, preguntar y revisar; una tarea individual cronometrada puede prohibir todo eso. Ambas ofrecen información, pero responden a demandas distintas. Si se pretende predecir trabajo cooperativo, la evidencia relevante debe incluir su relación con ese trabajo.
Ningún perfil debería interpretarse mediante la simple diferencia entre dos números sin error de medida. Además de precisión, importa si las escalas y referencias permiten esa resta y cuántas comparaciones se examinaron. Encontrar la mayor discrepancia entre muchas subpruebas puede exagerar su singularidad. La interpretación debe conservar el diseño completo de la evaluación.
148.5. Predicción poblacional y límites de la evaluación individual#
Una puntuación puede predecir resultados sin explicarlos de forma completa. La predicción utiliza relaciones observadas o un modelo para anticipar una variable. La explicación causal afirma qué cambiaría si se interviniera sobre una condición. Una correlación, por sí sola, no responde a esa segunda pregunta.
Modelo construido. Para mostrar el límite individual, suponemos dos variables con distribución normal conjunta:
Bajo esos supuestos, la media condicional de
La desviación condicional vale
El coeficiente
Una relación poblacional puede resultar útil para organizar apoyos y, a la vez, dejar amplio margen de incertidumbre individual. Utilidad y límites deben comunicarse juntos. Tampoco basta un buen promedio de predicción si el procedimiento falla sistemáticamente para un grupo relevante o cambia al aplicarse fuera de la población estudiada.
El criterio de evaluación es el resultado que se quiere anticipar o describir. Si se utilizan calificaciones, se predicen calificaciones, que incorporan procedimientos y condiciones educativas. Si se quiere ejecutar una operación con precisión, ese desempeño necesita su propia medida. Llamar «éxito» a ambos sin definirlo oculta diferencias importantes.
La decisión exige además valorar consecuencias. Una diferencia de cuatro puntos puede ser insuficiente para justificar un reparto rígido de tareas, aunque la prueba tenga alguna capacidad predictiva. Importan precisión, evidencia para ese uso y alternativas de evaluación. Un umbral administrativo no convierte diferencias diminutas a sus lados en una discontinuidad natural de capacidades.
En los aspirantes iniciales, una interpretación responsable conserva lo observado y sus límites: puntuaciones en tareas determinadas, incertidumbre y relación comprobada con objetivos. Puede combinarse con desempeño pertinente y oportunidades de aprendizaje. No autoriza a asignar valor personal, a negar desarrollo ni a inferir motivos o personalidad. El capítulo siguiente examina precisamente patrones de personalidad, una pregunta distinta de las capacidades cognitivas.
Preguntas de transferencia#
Una puntuación de 130 en la transformación construida, ¿significa 130 % de inteligencia?#
Mostrar respuesta razonada
No. La transformación sitúa dos desviaciones por encima de la media del grupo ficticio en una escala con origen 100 y factor 15. Los puntos no son porcentajes ni una cantidad física de inteligencia. Su interpretación depende de tarea y referencia.
¿Una diferencia de cuatro puntos entre 108 y 112 demuestra superioridad estable?#
Mostrar respuesta razonada
No por sí sola. Con errores construidos independientes de desviación seis, el error de la diferencia es aproximadamente 8,49; su intervalo aproximado del 95 % incluye cero. Esto no demuestra igualdad: delimita la precisión de la comparación bajo los supuestos adoptados.
Si un rasgo presenta heredabilidad alta, ¿una persona no puede mejorar mediante aprendizaje?#
Mostrar respuesta razonada
La heredabilidad describe variación en una población y unas condiciones, no una fracción inmutable de cada individuo. No mide el cambio posible ante una intervención. Para evaluar mejora se necesitan datos de aprendizaje y su alcance.
El modelo predice una media de aprendizaje de 56. ¿Debe esperarse exactamente 56 de cada persona con X = 115?#
Mostrar respuesta razonada
No. Es una media condicional con dispersión individual de ocho puntos bajo el modelo. El intervalo predictivo construido va aproximadamente de 40,32 a 71,68. Predicción media, resultado individual y explicación causal son afirmaciones diferentes.
Fuentes y lecturas del capítulo#
Puntuaciones, aspirantes, rendimientos y modelos numéricos son construidos. Las fuentes se utilizaron para definiciones, marcos y límites indicados; ninguna certifica que los parámetros inventados pertenezcan a una prueba real.
- Neisser, U.; Boodoo, G.; Bouchard, T. J., Jr.; Boykin, A. W.; Brody, N.; Ceci, S. J.; Halpern, D. F.; Loehlin, J. C.; Perloff, R.; Sternberg, R. J.; y Urbina, S. (1996). Intelligence: knowns and unknowns. American Psychologist, 51(2), 77–101. DOI: 10.1037/0003-066X.51.2.77. Texto de autor consultado para correlaciones, factores y posición normativa por edad. Es una síntesis histórica; no se presenta como inventario actualizado de toda la evidencia genética.
- Spielman, R. M.; Jenkins, W. J.; y Lovett, M. D. (2020). Psychology 2e, sección 7.4, «What are intelligence and creativity?». OpenStax. Manual consultado para vocabulario y contraste de modelos, sin adoptar como hecho la independencia de todas las capacidades propuestas.
- American Educational Research Association; American Psychological Association; y National Council on Measurement in Education (2014). Standards for Educational and Psychological Testing. Secciones sobre validez, precisión y uso de puntuaciones consultadas. Apoyo para distinguir interpretación válida y consistencia; los ejemplos matemáticos explicitan sus propios supuestos.
- Ritchie, S. J., y Tucker-Drob, E. M. (2018). How much does education improve intelligence? A meta-analysis. Psychological Science, 29(8), 1358–1369. DOI: 10.1177/0956797618774253. Texto consultado para diseños y límites de inferencia sobre educación; no se promete un incremento uniforme individual.
- National Library of Medicine (2023, actualización del 1 de agosto). Is intelligence determined by genetics?. MedlinePlus Genetics. Página institucional consultada para contribuciones genéticas y ambientales; no ofrece una descomposición individual causal.
- National Library of Medicine (2021, actualización del 16 de septiembre). What is heritability?. MedlinePlus Genetics. Apoyo para ámbito poblacional y errores de interpretación del parámetro.
- International Test Commission (2017). The ITC Guidelines for Translating and Adapting Tests, segunda edición, versión 2.4. Directrices consultadas para adaptación lingüística, cultural y de contenido; la traducción no se trata como equivalencia automática.