PARTE XIV · Mente, conducta y desarrollo humano
147
Razonamiento, juicio y sesgos cognitivos
Evaluar reglas de pensamiento mediante tareas, evidencia y contexto
En este capítulo
Ejemplo construido. Un taller debe renovar uno de dos vehículos que recorrerán la misma distancia. El primero pasaría de 10 a 15 kilómetros por litro; el segundo, de 20 a 25. Ambos ganan cinco unidades en el indicador. Si el objetivo exclusivo es ahorrar combustible en esos recorridos, ¿aportan el mismo ahorro? La respuesta exige relacionar una razón con la cantidad buscada, no sólo comparar diferencias entre cifras.
El razonamiento conecta premisas, información y conclusiones; el juicio estima o evalúa algo; la decisión selecciona una acción entre alternativas. Una conclusión puede ser lógicamente correcta y partir de datos equivocados. Una estimación puede ser buena sin constituir una demostración. Una elección puede depender de metas que un observador desconoce. Estudiar sesgos requiere separar esas cuestiones y declarar con qué criterio se evalúan las respuestas.
El capítulo anterior distinguió querer, esperar y poder actuar. Aquí se examina cómo se utiliza la información para juzgar. No se trata de repartir etiquetas de irracionalidad, sino de identificar procedimientos, condiciones de error y posibles mejoras que puedan comprobarse.
147.1. Heurísticas y economía de recursos cognitivos#
Una heurística es un procedimiento que simplifica búsqueda, valoración o elección. Puede utilizar pocas señales, detener una búsqueda al alcanzar un criterio o recurrir a información accesible. La simplificación no equivale por definición a error. Para evaluar una regla hay que conocer la tarea, la información disponible y qué resultado se pretende obtener.
El estudio clásico de Tversky y Kahneman sobre juicio bajo incertidumbre examina representatividad, disponibilidad y anclaje como procedimientos que pueden producir desviaciones sistemáticas. Su contribución no consiste en demostrar que cualquier respuesta rápida sea incorrecta. Identifica tareas donde ciertos indicios intuitivos no conservan relaciones probabilísticas relevantes.
La representatividad utiliza semejanza con una clase o un patrón para juzgar pertenencia o probabilidad. Parecerse a una descripción no incorpora automáticamente la frecuencia de las clases. Ejemplo construido. Una descripción de conocimientos y preferencias encaja con trabajadores de dos oficios. Para estimar a cuál pertenece una persona elegida al azar, interesa también cuántas personas hay en cada oficio y cuán frecuente es esa descripción dentro de ellos. La semejanza aislada no resuelve la pregunta.
Las tasas de base son frecuencias o probabilidades previas relevantes para la población y el procedimiento de selección. No son cifras que deban imponerse siempre ignorando información nueva. Su función es combinarse con evidencia cuya fuerza se conozca. Si la selección no es aleatoria, utilizar la composición total de la población como si lo fuera puede producir otro error.
También existe la pregunta inversa: ¿puede una regla muy simple funcionar bien? Gigerenzer y Goldstein propusieron modelos que buscan señales ordenadas y se detienen al encontrar una que distingue alternativas. Compararon procedimientos mediante simulaciones de inferencias sobre poblaciones de ciudades. En ese marco, algunos algoritmos simples alcanzaron resultados competitivos. No se deduce que ignorar información sea óptimo para cualquier tarea ni que todos los participantes usen ese algoritmo.
Ejemplo construido. Para escoger una herramienta que quepa en una abertura, el tamaño máximo puede descartar inmediatamente opciones. No hace falta integrar color y comodidad si una pieza no entra. Para elegir entre dos herramientas que sí caben y tienen costes, duración y precisión diferentes, el mismo descarte no basta. La utilidad de detener la búsqueda depende del criterio y de la estructura de las alternativas.
La racionalidad limitada reconoce restricciones de tiempo, conocimientos y procesamiento. Elegir requiere emplear recursos que también tienen un coste. Buscar indefinidamente una mejora mínima puede impedir resolver la tarea. Sin embargo, reconocer límites no vuelve adecuada cualquier regla: algunas simplificaciones omiten precisamente el dato decisivo y deben corregirse.
Puede distinguirse un criterio normativo, que define qué respuesta sería adecuada bajo ciertos supuestos, de una descripción descriptiva, que explica cómo se responde efectivamente. Un procedimiento prescriptivo intenta mejorar el desempeño. Confundirlos produce saltos: que un modelo matemático permita calcular una solución no demuestra que las personas calculen así; que utilicen otra regla no prueba su fracaso en todos los entornos.
Un sesgo cognitivo, en este capítulo, es una desviación sistemática respecto a un criterio especificado, vinculada al procesamiento de información. Un error aislado no demuestra sistematicidad. Para establecerla se necesita observar un patrón con un diseño y unas condiciones definidos. Además, el criterio debe corresponder a la pregunta que el participante interpretó.
La velocidad tampoco identifica por sí sola una clase de pensamiento. Una persona experta puede resolver deprisa una tarea conocida y comprobarla correctamente; otra puede dedicar mucho tiempo a una interpretación errónea. Las expresiones «intuitivo» y «deliberado» describen aspectos del proceso, pero no localizan dos personas dentro del cerebro ni garantizan calidad por el mero tiempo invertido.
147.2. Encuadre, disponibilidad y anclaje#
El encuadre es la representación de las alternativas, consecuencias y relaciones relevantes para una decisión. El artículo de Tversky y Kahneman de 1981 mostró cambios de elección entre formulaciones de problemas equivalentes. Los ejemplos iniciales se administraron a estudiantes mediante cuestionarios. Es evidencia sobre esas tareas y muestras, no una ley que obligue a cada persona a preferir certeza ante ganancias y riesgo ante pérdidas.
Ejemplo construido. De un lote de 120 piezas amenazadas por deterioro, una opción conservará exactamente 40; otra conservará las 120 con probabilidad un tercio y ninguna con probabilidad dos tercios. Se especifica que no hay otros resultados ni costes. La primera puede describirse como perder exactamente 80 piezas. La segunda equivale a perder cero con probabilidad un tercio y 120 con probabilidad dos tercios.
Las dos redacciones conservan las mismas distribuciones de resultados si «conservar» y «perder» agotan las posibilidades y el lote inicial es fijo. La media esperada de piezas conservadas vale 40 en ambas opciones, pero su variabilidad difiere. Elegir una opción segura o arriesgada no es, por sí solo, un error: puede reflejar preferencias. Cambiar de preferencia sólo por una redacción equivalente plantea una cuestión de consistencia, siempre que la equivalencia haya sido comprendida.
La equivalencia puede romperse si se omite información. «Conservar al menos 40» no es lo mismo que conservar exactamente 40. «Hay una posibilidad de conservar todo» no comunica la probabilidad completa. Un efecto de redacción debe estudiarse sin confundirlo con efectos de información distinta. Una comparación justa registra lo que se dijo, no sólo lo que el investigador pretendía decir.
La disponibilidad utiliza la facilidad con que se recuperan o imaginan casos para juzgar frecuencia o posibilidad. Recordar tres averías recientes puede servir para detectar algo que merece investigación; no basta para estimar una tasa de fallos. El recuerdo depende de exposición, atención y registro, además de cuántos casos ocurrieron.
Ejemplo construido. En el taller se comentan ocho fallos de la máquina A y cuatro de la B. Si A realizó 800 operaciones comparables y B sólo 100, las tasas observadas son 1 % y 4 %. A produjo más casos, pero B presentó más fallos por operación en ese registro. La conclusión depende del denominador; no establece todavía qué máquina causaría menos fallos bajo las mismas condiciones.
Si las operaciones de B eran más difíciles, la comparación de tasas puede mezclar dificultad y máquina. Aquí aparecen dos problemas distintos: omitir el denominador y atribuir causalidad a una asociación. Corregir el primero no corrige automáticamente el segundo. Se necesitaría información sobre tareas y condiciones, o un diseño que las comparase adecuadamente.
El anclaje describe influencia de un punto de partida sobre una estimación posterior. Un número comunicado antes de valorar puede orientar la respuesta incluso cuando su relación con la cantidad buscada es débil. Detectar esa influencia requiere comparar condiciones. Que dos personas hagan estimaciones diferentes después de ver números distintos no basta si también recibieron información pertinente diferente.
Ejemplo construido. Para estimar la duración de un trabajo, el taller puede mostrar primero «¿serán más o menos de dos horas?» o «¿serán más o menos de ocho?». Se propone contrastar el efecto asignando al azar la pregunta inicial y manteniendo iguales los detalles. Las cifras no serían pruebas de duración; serían condiciones del experimento. Sin resultados observados no puede afirmarse que se haya producido anclaje ni cuánto.
Un presupuesto profesional sí puede aportar información relevante. Utilizarlo no debe llamarse automáticamente sesgo. La cuestión es si se ajusta su peso a la calidad, independencia y pertinencia de la fuente. Tampoco basta adoptar el extremo opuesto al ancla: esa reacción sigue organizada alrededor de ella y puede alejarse más del valor correcto.
147.3. Confirmación, razonamiento motivado y confianza#
El sesgo de confirmación se refiere a buscar o interpretar evidencia de manera favorable a una creencia o hipótesis existente. La revisión de Raymond Nickerson distingue selectividad no advertida de una defensa deliberada de una posición. También considera formas que no requieren un interés material evidente. Tener una hipótesis no constituye por sí solo un sesgo; el problema es cómo se trata la evidencia pertinente.
Ejemplo construido. Se supone que una prensa sólo produce defectos con material húmedo. Revisar únicamente piezas húmedas defectuosas puede encontrar casos compatibles con la idea, pero omite piezas húmedas correctas y secas defectuosas. Para comprobar la afirmación «sólo con humedad» interesa especialmente buscar un defecto en material seco, verificando que ambas clasificaciones sean fiables.
Sea
La relación lógica no resuelve la causalidad. Aunque todos los defectos registrados coincidan con humedad, podría existir otra condición común que los explique. Tampoco un caso discordante demuestra inmediatamente error de la teoría si la medida de humedad falló. La revisión debe examinar medición y supuestos, sin utilizar cualquier discrepancia como excusa imposible de contrastar.
La prueba más útil no siempre es la que «busca lo contrario» de forma literal. Si dos hipótesis predicen el mismo resultado en una condición, repetirla no las distingue, aunque se la llame crítica. Hace falta encontrar una observación cuyos resultados esperados difieran. Esta exigencia enlaza con el diseño experimental del capítulo 133.
El razonamiento motivado investiga cómo las metas influyen en acceso, construcción y evaluación de creencias. Ziva Kunda distingue buscar exactitud de buscar una conclusión deseada y analiza los procedimientos que podrían mediar esa influencia. Su revisión no supone que alguien pueda creer cualquier cosa sólo por desearla: las justificaciones disponibles limitan qué conclusión puede sostenerse. También señala que querer acertar no garantiza disponer de mejores estrategias.
Ejemplo construido. Una responsable ha defendido comprar la prensa. Ante un fallo, acepta una explicación favorable basada en un único caso, mientras exige muchas pruebas para una explicación desfavorable. La asimetría es un comportamiento que merece examinarse. No basta para afirmar qué sintió o si lo hizo conscientemente. El análisis puede comprobar si aplica criterios distintos, sin convertir la acusación de sesgo en sustituto de evidencia.
La confianza es una evaluación de la corrección o solidez de una respuesta. No es equivalente a corrección. Moore y Healy separan sobreestimar el desempeño propio, situarse demasiado alto respecto a otros y expresar excesiva precisión en creencias. Esas medidas responden a preguntas distintas; pueden divergir en una misma persona y tarea.
Ejemplo construido. Una operaria cree resolver nueve de diez pruebas y resuelve siete: sobreestimó el número de aciertos. Si cree estar por debajo de sus compañeros y éstos resuelven cinco, su posición relativa fue subestimada. Los dos resultados pueden coexistir. No existe contradicción porque se comparan referencias distintas.
Para evaluar probabilidades de acierto interesa la calibración: la relación entre confianza declarada y frecuencia de aciertos en conjuntos pertinentes de respuestas. Si, en cien pronósticos construidos con confianza 0,8, se aciertan sesenta, la proporción observada es 0,6 y la diferencia 0,2, es decir, veinte puntos porcentuales. Ese registro sugiere desajuste en ese conjunto; para estimar el patrón general hacen falta incertidumbre, selección de tareas y observaciones suficientes.
Una sola respuesta incorrecta con confianza 0,8 no demuestra mala calibración: una probabilidad de 0,8 admite resultados incorrectos. Tampoco calibración perfecta basta para utilidad. Declarar siempre la tasa general de acierto puede estar bien calibrado y distinguir mal cuáles casos son fáciles o difíciles. Calidad de juicio requiere más de una comparación.
147.4. Decisiones individuales y condiciones del entorno#
El entorno proporciona representaciones que facilitan o dificultan operaciones. El problema inicial del combustible lo muestra sin atribuir un defecto permanente a nadie. Una diferencia igual en kilómetros por litro no implica ahorro igual en litros para una distancia fija. El cálculo puede quedar oculto por el indicador o hacerse visible al representar la cantidad relevante.
El estudio de Larrick y Soll sobre la ilusión de las millas por galón comparó juicios y formulaciones del consumo. En una tarea de reemplazo de vehículos, expresar también combustible por distancia cambió la elección hacia el mayor ahorro. No demuestra que una conversión resuelva todo comportamiento ambiental: estudió elecciones con condiciones y metas especificadas. El ejemplo siguiente utiliza otras cifras y unidades y es construido.
Sea
Para el primer vehículo, pasar de 10 a 15 km/L reduce el consumo de 100 a aproximadamente 66,67 L; ahorra aproximadamente 33,33 L. Para el segundo, pasar de 20 a 25 km/L reduce de 50 a 40 L; ahorra 10 L. Se han conservado iguales distancia y ganancia de cinco km/L, pero no la reducción de combustible.
Desliza horizontalmente para ver la tabla completa.
| Cambio construido | Litros antes por 1000 km | Litros después por 1000 km | Ahorro por 1000 km |
|---|---|---|---|
| 10 → 15 km/L | 100 | 66,67, aproximadamente | 33,33 L, aproximadamente |
| 20 → 25 km/L | 50 | 40 | 10 L |
La diferencia procede de una relación recíproca. Para una ganancia positiva fija
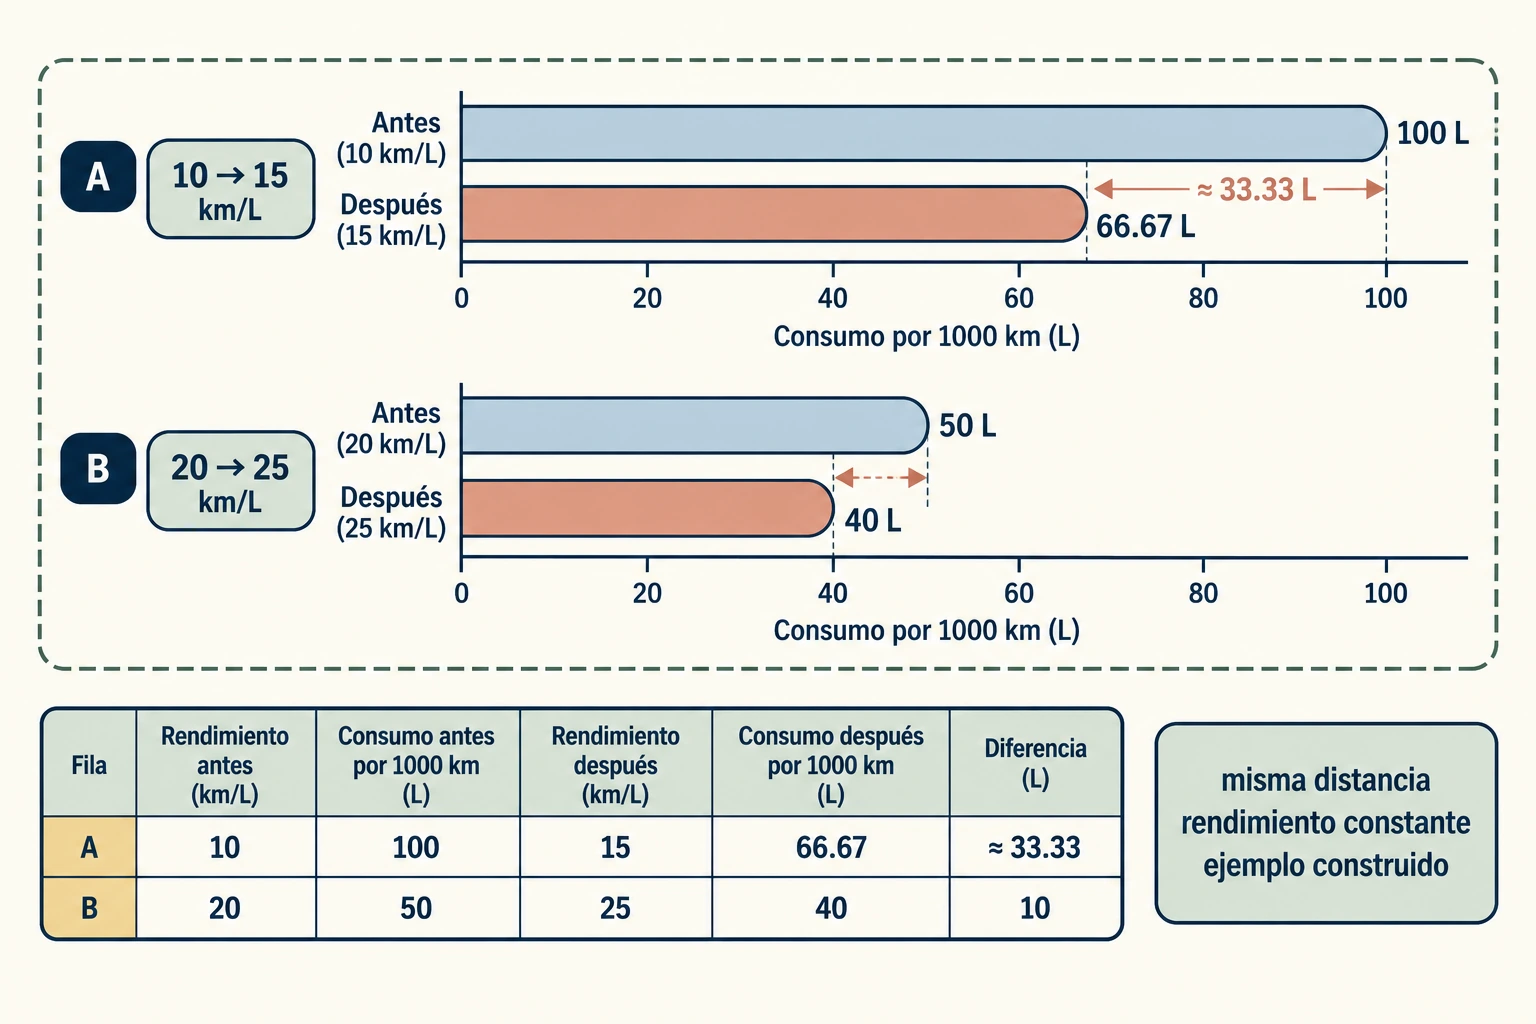
La cantidad ahorrada depende del rendimiento inicial: 33,33 y 10 litros aproximadamente, pese a una mejora idéntica de cinco km/L. Modelo construido con distancia fija
Si las distancias fueran diferentes, también cambiaría la comparación. Un vehículo que recorra muy pocos kilómetros podría ahorrar menos combustible total aunque su ahorro por kilómetro sea mayor. Si importan coste de compra, seguridad o capacidad, el combustible deja de ser el único criterio. Declarar esas metas evita diagnosticar como error una elección que responde a un problema más amplio.
El cálculo necesita supuestos verificables fuera del modelo. El rendimiento real puede variar con condiciones de uso; un promedio de catálogo no demuestra consumo en una ruta determinada. Mostrar litros por distancia facilita una operación, pero no corrige datos inadecuados. Representación clara y calidad de medición son requisitos distintos.
Los formularios también organizan decisiones. Si el taller muestra siempre el resultado aprobado primero y oculta la alternativa, estudiar elecciones como si ambos se hubieran presentado igual omite una condición. Si obliga a resolver una operación larga sin permitir papel, mide desempeño bajo esa restricción. Una dificultad así no es automáticamente una limitación general de la persona.
Ejemplo construido. Para revisar presupuestos, se propone una tabla que muestre importe total, duración, condiciones y operaciones realizadas. Su utilidad tendría que evaluarse con tareas concretas: errores de comparación, tiempo y comprensión de supuestos. Añadir columnas irrelevantes podría entorpecer. «Más información» no es una intervención precisa sin indicar cuál se añade y cómo se usa.
El apoyo externo puede incluir registros, calculadoras, referencias y revisión por otras personas. Su presencia cambia la actividad evaluada. No debe confundirse saber ejecutar un cálculo de memoria con saber resolver una decisión utilizando recursos disponibles. El criterio adecuado depende de lo que la tarea real exige y de si el apoyo será accesible.
147.5. Cuándo una regularidad experimental no se generaliza#
Una regularidad experimental describe un resultado dentro de condiciones estudiadas. Generalizar exige justificar qué se mantiene al pasar a otra tarea, población o situación. No basta que el efecto tenga un nombre conocido. Hay que examinar qué se manipuló, qué se midió, con quién y qué incertidumbre tiene la estimación.
La revisión de Henrich, Heine y Norenzayan cuestionó la extensión de hallazgos de muestras estrechas a toda la humanidad. El acrónimo WEIRD reúne los términos ingleses occidental, educado, industrializado, rico y democrático. La advertencia concierne a la representatividad de la evidencia, no establece que toda persona de esas sociedades responda igual ni que no existan procesos compartidos.
Una diferencia entre grupos tampoco tiene explicación única. Puede depender de interpretación de instrucciones, experiencia con tareas, condiciones materiales u otros factores. Encontrarla no autoriza a atribuirla directamente a una cultura completa. El diseño debe separar hipótesis y evitar convertir una categoría de muestreo en una esencia psicológica.
Ejemplo construido. Una pregunta usa probabilidades y pagos ficticios. En un grupo se comprende «probabilidad un tercio»; en otro, la frase se interpreta como una oportunidad imprecisa. Una diferencia de elección puede incorporar comprensión distinta. Antes de atribuirla a preferencias de riesgo conviene comprobar qué entendieron los participantes. Esa comprobación no garantiza eliminar todas las diferencias, pero identifica una condición relevante.
El paso del laboratorio a una decisión repetida introduce cambios. Recibir consecuencias, aprender de errores, consultar a otros y ajustar estrategias puede alterar el desempeño. Una elección hipotética única y una conducta observada durante meses no son la misma medida. Ninguna debe reemplazar a la otra sin justificar la relación.
La magnitud media no describe a cada individuo. Si una intervención reduce errores en promedio, puede ayudar a algunos, no cambiar a otros o perjudicar en ciertas condiciones. Para convertirla en una recomendación hacen falta propósito, coste y alcance. Tampoco un promedio nulo prueba ausencia de todos los efectos: podría combinar diferencias o medir con poca precisión.
Una replicación, en el sentido de nueva recogida de datos, examina si una conclusión recibe apoyo en otro estudio. Reproducir cálculos con los mismos datos verifica otra cuestión. Cambiar una tarea de forma sustancial puede probar una generalización en lugar de repetir el procedimiento original. Distinguir esas preguntas permite interpretar acuerdos y discrepancias con precisión.
No toda diferencia entre estudio y práctica refuta el mecanismo propuesto. Quizá cambiaron condiciones que el modelo considera esenciales. Pero esa explicación tiene que ser comprobable: indicar qué cambió y qué resultado se esperaba. Atribuir cualquier fallo a «contexto» sin precisarlo vuelve la teoría inmune a la evidencia.
También debe conservarse el criterio normativo. En el lote de piezas, igualar medias no vuelve indiferentes dos opciones con variabilidad distinta. En los vehículos, elegir mayor ahorro es correcto respecto al objetivo exclusivo y supuestos definidos, no respecto a toda compra posible. El juicio sobre error requiere reconstruir el problema, en lugar de comparar respuestas con la preferencia del evaluador.
Volver al taller permite reunir las comprobaciones: convertir rendimientos en consumos, fijar la distancia, declarar otros criterios y revisar datos. Si después aparece una elección inesperada, puede investigarse qué regla se utilizó. Ese orden hace de los sesgos hipótesis sobre procedimientos, no etiquetas personales. El capítulo siguiente examina cómo se definen y miden capacidades cognitivas, conservando la misma cautela entre tarea observada y atributo general.
Preguntas de transferencia#
Se recuerdan más fallos de A que de B. ¿Demuestra que A es menos fiable?#
Mostrar respuesta razonada
No sin conocer operaciones comparables y registro. Ocho fallos en 800 operaciones equivalen al 1 %, mientras cuatro en cien equivalen al 4 %. Incluso esas tasas necesitan condiciones comparables para sostener una comparación causal. Recuerdo, conteo y tasa son medidas distintas.
¿Preferir conservar exactamente cuarenta piezas a una lotería con media cuarenta demuestra un sesgo?#
Mostrar respuesta razonada
No. La lotería tiene variabilidad y una persona puede preferir certeza. La cuestión de encuadre aparece al cambiar preferencias entre formulaciones realmente equivalentes, manteniendo información, metas e interpretación. Igualdad de medias no significa identidad de opciones.
Todos los defectos observados ocurrieron con humedad. ¿Prueba que toda pieza húmeda sale defectuosa?#
Mostrar respuesta razonada
No. «Defecto implica humedad» y «humedad implica defecto» son relaciones diferentes. Una pieza húmeda correcta es compatible con la primera y refuta la segunda bajo las medidas adoptadas. Ninguna asociación, por sí sola, demuestra causalidad.
Una mejora de cinco km/L, ¿produce siempre el mismo ahorro?#
Mostrar respuesta razonada
No. Para distancia fija y rendimiento constante, el consumo es distancia dividida por rendimiento. Por mil kilómetros, 10→15 km/L ahorra unos 33,33 litros, mientras 20→25 ahorra diez. Si cambian las distancias u otros criterios, también debe cambiar el análisis de la decisión.
Fuentes y lecturas del capítulo#
Las referencias aportan modelos, fenómenos y criterios de interpretación. Vehículos, piezas, máquinas y pronósticos son ejemplos construidos; sus cifras no se atribuyen a participantes de los estudios citados. Las lecturas se utilizan para las cuestiones expresamente indicadas, sin convertirlas en una revisión exhaustiva del campo.
- Tversky, A., y Kahneman, D. (1974). Judgment under uncertainty: heuristics and biases. Science, 185(4157), 1124–1131. DOI: 10.1126/science.185.4157.1124. Artículo consultado para representatividad, disponibilidad y anclaje; sus tareas no certifican rasgos de cada persona.
- Gigerenzer, G., y Goldstein, D. G. (1996). Reasoning the fast and frugal way: models of bounded rationality. Psychological Review, 103(4), 650–669. Copia de autor consultada, identificada en el archivo como distinta de la versión editorial definitiva. Apoyo para reglas de búsqueda y límites de interpretar simulaciones como conducta universal.
- Tversky, A., y Kahneman, D. (1981). The framing of decisions and the psychology of choice. Science, 211(4481), 453–458. DOI: 10.1126/science.7455683. Texto consultado para equivalencia de formulaciones y condiciones de los ejemplos iniciales.
- Nickerson, R. S. (1998). Confirmation bias: a ubiquitous phenomenon in many guises. Review of General Psychology, 2(2), 175–220. DOI: 10.1037/1089-2680.2.2.175. Revisión consultada para selectividad de evidencia, con distinción entre hipótesis, defensa deliberada y procesamiento no advertido.
- Kunda, Z. (1990). The case for motivated reasoning. Psychological Bulletin, 108(3), 480–498. Texto consultado para metas de exactitud y dirección, mecanismos propuestos y límites de las justificaciones disponibles.
- Moore, D. A., y Healy, P. J. (2008). The trouble with overconfidence. Psychological Review, 115(2), 502–517. DOI: 10.1037/0033-295X.115.2.502. Texto consultado para separar sobreestimación, posición relativa y precisión excesiva.
- Larrick, R. P., y Soll, J. B. (2008). The MPG illusion. Science, 320(5883), 1593–1594. DOI: 10.1126/science.1154983. Artículo consultado para relación recíproca y efecto de la representación en una tarea definida; no se copian sus cifras al ejemplo.
- Henrich, J.; Heine, S. J.; y Norenzayan, A. (2010). The weirdest people in the world?. Behavioral and Brain Sciences, 33(2–3), 61–83, seguido de comentarios y respuesta en el archivo enlazado. DOI: 10.1017/S0140525X0999152X. Se consultó el texto inicial sobre muestreo y alcance; no se adopta una explicación única de todas las diferencias entre poblaciones.