PARTE XIII · Métodos: medición, territorio, capacidad e implementación
134
Muestreo, encuestas y errores de medición
Cómo unas respuestas llegan a representar una población
En este capítulo
Ejemplo construido. Una cooperativa consulta por internet a quienes figuran en su lista de contacto. Recibe miles de respuestas y concluye que casi todas las explotaciones agrícolas de su comarca tienen conexión estable. La cifra describe bien lo contestado. Sin embargo, las explotaciones sin conexión pudieron tener menos posibilidades de estar en la lista, recibir la invitación y completarla. Aumentar las respuestas dentro de ese mismo circuito puede estrechar un intervalo estadístico sin resolver la ausencia que afecta a la conclusión.
Una encuesta convierte experiencias, hechos o juicios particulares en una estimación colectiva. Entre la población que interesa y el número publicado intervienen varias operaciones: delimitar quién cuenta, disponer de una vía para localizarlo, seleccionarlo, obtener su participación y transformar respuestas en variables. Cada operación conserva parte de la información y puede perder o deformar otra. Comprender la encuesta exige reconstruir esa relación, además de conocer cuántas personas respondieron.
134.1. Población objetivo, marco y unidad de análisis#
La población de interés debe definirse antes de extraer la muestra. «Agricultores de la comarca» puede referirse a personas propietarias, trabajadoras, hogares o explotaciones. Esas entidades tienen cantidades y distribuciones distintas. Una persona puede trabajar en varias explotaciones; una explotación puede reunir a varias personas. La unidad que se desea describir determina el denominador de porcentajes y medias.
La población objetivo es el conjunto de unidades sobre el que se quiere obtener información. Su definición incluye criterios de pertenencia, territorio y referencia temporal. Para el problema inicial podría consistir en explotaciones activas dentro de límites especificados durante una campaña determinada. La condición de actividad debe traducirse a un criterio verificable. Las directrices de Statistics Canada sobre cobertura y marcos distinguen ese objetivo de la población a la que una operación puede acceder en la práctica.
La cantidad que interesa también necesita definición. La proporción de explotaciones con conexión, la proporción de trabajadores con acceso y la fracción del área cultivada gestionada mediante conexión estable responderían a preguntas diferentes. Aunque se obtuvieran del mismo cuestionario, no se calcularían dando a todas las filas la misma importancia. Para describir superficie, una explotación extensa puede contribuir más al total que una pequeña; para describir explotaciones, ambas cuentan como una unidad.
El marco de muestreo es el recurso que permite identificar y seleccionar unidades: un registro, un conjunto de direcciones o una delimitación territorial con procedimientos de enumeración. No tiene que ser una lista de nombres. Un marco de áreas puede permitir seleccionar zonas y luego localizar unidades dentro de ellas. Lo decisivo es la relación documentada entre sus entradas y la población que se quiere representar.
Una lista de socios de la cooperativa no equivale a un registro de todas las explotaciones. Puede omitir no socios e incluir antiguos miembros. También puede contener dos contactos para la misma explotación. La omisión, la inclusión de unidades ajenas y la duplicación alteran la selección de maneras distintas. Dos entradas para una unidad pueden aumentar su oportunidad de inclusión si el procedimiento no reconoce el duplicado. Eliminar después una fila sin revisar esa oportunidad no reconstruye necesariamente el diseño original.
La unidad seleccionada, la unidad que informa y la unidad analizada pueden diferir. Si se selecciona una vivienda, contesta una persona adulta y se busca describir a todos sus residentes, hace falta un procedimiento para obtener información sobre ellos. Entrevistar a quien abre la puerta no selecciona automáticamente a una persona al azar dentro de la vivienda. Las directrices de diseño muestral vinculan unidades, etapas y disponibilidad de información con la estrategia de selección.
En el ejemplo agrícola, un administrador podría informar sobre varias explotaciones. Sus respuestas tendrían que conservar la identidad de cada unidad y su referencia temporal. Que el mismo informante complete varios registros puede introducir dependencias o errores compartidos; no convierte las explotaciones en una sola unidad, pero tampoco garantiza que sus respuestas sean independientes. El diseño y la medición deben representar ambas relaciones.
La fecha del registro puede importar tanto como su extensión. Nuevas explotaciones, cierres o cambios de actividad modifican la población. Un registro completo de una campaña anterior puede estar desactualizado para la siguiente. Comparar fuentes, comprobar una parte del marco en campo y registrar exclusiones ayuda a evaluar cobertura. Cuando la población accesible sea más limitada que la objetivo, esa diferencia debe aparecer en el alcance de los resultados.
134.2. Muestreo probabilístico y no probabilístico#
Seleccionar una parte de la población permite dedicar recursos a localizar, preguntar y verificar mejor. La legitimidad de la inferencia depende de cómo se obtiene esa parte. En un muestreo probabilístico, la selección utiliza un mecanismo de azar y las unidades de la población cubierta tienen probabilidades positivas de inclusión que pueden determinarse. Estas probabilidades no tienen que ser iguales.
En el muestreo aleatorio simple sin reemplazo, todas las muestras de un tamaño fijado tienen igual probabilidad. Ejemplo construido. Un registro depurado contiene 2.400 explotaciones y se seleccionan 240 mediante ese diseño. Cada explotación tiene probabilidad 240/2.400 = 0,10 de inclusión. La selección se realiza sobre el marco entero, no sólo entre quienes se ofrecen a responder. Que las respuestas finales sean menos de 240 plantea un problema posterior de no respuesta.
Dar igual oportunidad individual no basta para definir muestreo aleatorio simple. Un diseño sistemático puede seleccionar una entrada cada cierto intervalo después de un inicio aleatorio. Sus muestras posibles dependen del orden de la lista. Si ese orden contiene ciclos relacionados con la variable, un intervalo coincidente puede generar muestras muy diferentes entre sí. La explicación de muestreo probabilístico de Statistics Canada permite distinguir estos diseños. Registrar orden, intervalo e inicio conserva información necesaria para interpretarlos.
La estratificación divide la población cubierta en grupos, llamados estratos, definidos antes de seleccionar y extrae muestras dentro de ellos. En la comarca podrían usarse zonas agroclimáticas o categorías de tamaño conocidas en el registro. La intención puede ser mejorar precisión o asegurar suficientes casos para un grupo pequeño. Seleccionar proporcionalmente no es obligatorio: una categoría rara puede recibir una fracción mayor, siempre que esa decisión entre en la estimación.
Los conglomerados reúnen unidades que se seleccionan conjuntamente o en etapas, como localidades y luego explotaciones dentro de ellas. Esta organización puede reducir desplazamientos. Si las unidades de una localidad comparten infraestructura de conexión, sus respuestas aportan menos variación entre entornos que igual número de unidades dispersas. El número de observaciones sigue siendo real, pero no debe interpretarse como el mismo volumen de información que proporcionaría una muestra aleatoria simple del mismo tamaño.
El muestreo no probabilístico utiliza mecanismos como disponibilidad, voluntariado o selección deliberada sin probabilidades de inclusión conocidas. Sus usos incluyen explorar experiencias, comprobar la comprensión de preguntas y estudiar casos pertinentes. El problema surge al convertir automáticamente la distribución de esos casos en una distribución poblacional. Una invitación abierta puede atraer sobre todo a quienes tienen acceso al canal o una motivación intensa para contestar.
Las cuotas fijan cantidades para ciertas categorías, pero no necesariamente introducen azar en la elección dentro de ellas. Igualar edades o tamaños de explotación no asegura igualdad en conectividad, confianza institucional o interés por el tema. Dos muestras con idéntica composición en variables observadas pueden diferir en una propiedad no medida que influye tanto en participación como en respuesta.
El medio de entrevista tampoco define el diseño. Una encuesta por internet puede invitar a unidades previamente seleccionadas mediante un marco probabilístico; otra puede aceptar voluntarios desde un enlace público. Las buenas prácticas de la American Association for Public Opinion Research distinguen estas situaciones. Internet describe un canal de recogida; «probabilístico» describe una selección.
Es posible hacer inferencias desde muestras no probabilísticas mediante modelos y fuentes auxiliares, pero entonces la validez depende de supuestos adicionales sobre selección y resultados. Esos supuestos necesitan explicación y comprobaciones pertinentes. El número de respuestas no revela por sí solo cuáles se cumplen. Tampoco la selección probabilística inicial garantiza un resultado final libre de sesgo: la cobertura, participación y medición pueden deteriorar sus ventajas.
134.3. No respuesta, cobertura y sesgo de selección#
Una unidad ausente del marco y una unidad seleccionada que no responde son pérdidas distintas. La primera no pudo entrar por el mecanismo previsto; la segunda sí entró, pero no proporcionó toda la información necesaria. La no respuesta de unidad afecta a un registro completo, según criterios establecidos. La no respuesta de ítem afecta a preguntas concretas dentro de un registro utilizable.
No responder una pregunta sobre ingresos no significa ingresos nulos. Tampoco significa lo mismo que declarar desconocimiento o que la pregunta no corresponda. Mezclar esos estados cambia la distribución que se pretende estimar. Una cifra puede convertirse en artificialmente baja si un programa transforma casillas vacías en ceros sin justificación. Conservar códigos diferenciados permite reconocer el problema y aplicar tratamientos explícitos.
El sesgo de un estimador es la diferencia entre su valor esperado bajo el proceso considerado y la cantidad poblacional que pretende estimar. Se distingue de la variación entre muestras: unas pueden dar valores altos y otras bajos sin desplazar sistemáticamente su promedio. La no respuesta puede introducir ese desplazamiento si las unidades que contestan representan de manera inadecuada la propiedad que interesa. Su magnitud no está determinada únicamente por la tasa de respuesta. El recurso institucional de AAPOR sobre definiciones y resultados de contacto explica por qué esa tasa es un indicador necesario pero insuficiente. Una gran fracción ausente puede ser poco problemática para una variable y muy problemática para otra.
Ejemplo construido. En una operación simplificada se intenta consultar a las 1.000 unidades de una población completa, todas elegibles. Responden 600; 420 declaran conexión estable. El 70 % describe a quienes respondieron. Si entre las 400 ausentes la proporción fuera también 70 %, la proporción total sería 70 %. Si fuera 20 %, habría 80 unidades adicionales con conexión y el total sería 500/1.000 = 50 %. La misma tasa de respuesta y el mismo archivo observado son compatibles con ambas situaciones.
Sin información adicional sobre las ausentes, el mínimo total sería 420/1.000 = 42 % y el máximo, (420 + 400)/1.000 = 82 %, suponiendo que las respuestas presentes midan correctamente una condición binaria. Son límites lógicos, no un intervalo de confianza. Expresan qué queda sin identificar por la ausencia de información. Las suposiciones o nuevos datos pueden estrecharlos, pero no corresponde sustituirlos por una certeza obtenida sólo de las 600 respuestas.
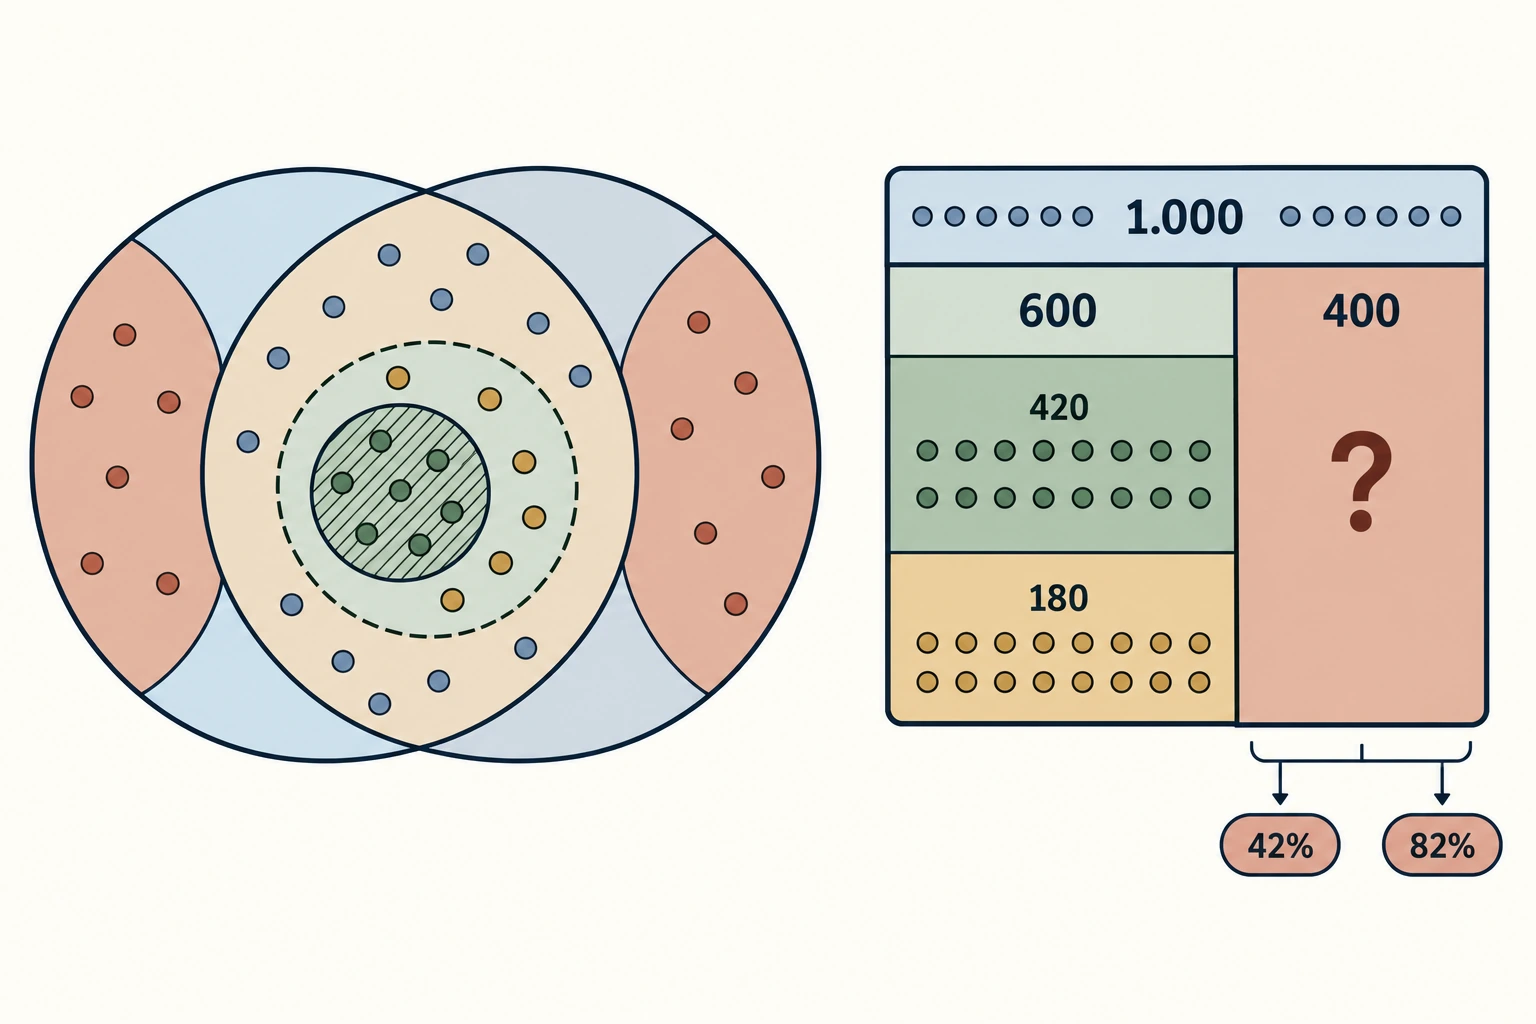
La selección y la respuesta dejan ausencias diferentes. En el ejemplo de la derecha, la condición de las 400 unidades desconocidas determina los límites lógicos del total; el 70 % sólo describe las 600 respuestas
La evaluación utiliza información sobre el proceso y sobre la población. Reintentos en horarios distintos pueden alcanzar unidades antes inaccesibles. Una submuestra planificada de no respondientes puede recibir un seguimiento más intenso. Comparar características disponibles para respondientes y ausentes permite detectar diferencias, aunque coincidir en esas características no demuestra coincidencia en una variable desconocida. Las directrices sobre respuesta y no respuesta de Statistics Canada relacionan seguimiento, información auxiliar y ajuste.
Conviene registrar si faltó contacto, hubo rechazo, falló el canal o se descubrió que una unidad no era elegible. Las tasas comparables requieren denominadores y reglas coherentes para elegibilidad desconocida y entrevistas parciales. El cálculo simple 600/1.000 del ejemplo funciona porque se fijó que todas las unidades eran elegibles y se definió respuesta completa. En una encuesta real, omitir esas condiciones puede producir tasas aparentemente diferentes para operaciones semejantes.
Sustituir una unidad que no responde por la más próxima o accesible modifica la selección. La nueva unidad no hereda automáticamente la probabilidad de la anterior. El seguimiento y las reservas muestrales necesitan procedimientos previstos y documentados. Buscar un número final de entrevistas sin conservar el mecanismo puede transformar una muestra planificada en otra cuyo alcance sea desconocido.
134.4. Diseño de preguntas y efectos de medición#
Obtener una respuesta no asegura haber medido la propiedad buscada. «¿Dispone de buena conexión?» deja al informante decidir qué significa buena, dónde se evalúa y durante qué periodo. La velocidad puede orientar la respuesta de una persona y las interrupciones o el precio, la de otras. Un porcentaje agrega entonces criterios distintos bajo una etiqueta compartida.
Ejemplo construido. Para estudiar continuidad del servicio, una pregunta podría pedir el número de días de una semana especificada en que la explotación sufrió interrupciones superiores a una duración definida. Esa formulación delimita una experiencia, pero aún requiere comprobar si el informante conoce lo ocurrido en toda la explotación. También exige decidir cómo se registran funcionamiento nocturno, ausencia de uso o falta de registros. La precisión verbal no sustituye la posibilidad real de responder.
Una respuesta suele requerir comprender la pregunta, recuperar información, evaluar qué cuenta y elegir cómo expresarlo. El National Center for Health Statistics describe la entrevista cognitiva como una forma de investigar esos procesos. Esta evaluación puede revelar que dos informantes usan interpretaciones distintas incluso cuando ambos completan sin dificultad una misma casilla.
El periodo de referencia afecta a la recuperación. Preguntar por una semana concreta y por «habitualmente» puede medir cosas diferentes. Un periodo largo puede exigir reconstrucción aproximada; uno muy corto puede representar mal una actividad estacional. La elección depende del fenómeno y del acceso a registros. No existe una duración que garantice buena memoria y representatividad temporal para cualquier variable.
Una pregunta que reúne dos propiedades produce respuestas difíciles de interpretar. «¿Es económica y fiable la conexión?» admite que sea económica pero poco fiable o cara pero fiable. Un sí o un no no identifica cuál de esas situaciones existe. Separar propiedades permite comparar y evita que una respuesta aparentemente precisa oculte combinaciones diferentes.
La formulación también puede sugerir una valoración. Presentar una técnica como moderna y necesaria antes de preguntar por su uso introduce un juicio que puede favorecer cierta respuesta. Algunas personas contestan según lo que consideran aceptable ante el entrevistador; otras evitan revelar información sensible. El error de medición puede ser sistemático sin que exista intención de engañar. La interacción, la privacidad percibida y el propósito atribuido al estudio forman parte de las condiciones de respuesta.
Las opciones deben corresponder a distinciones que la persona pueda utilizar. Categorías de superficie cuyos extremos se solapan asignan un mismo caso a dos respuestas. Una escala sin posibilidad de desconocimiento puede obligar a inventar una valoración. Añadir «no sabe» o permitir omisión tiene sentido cuando esos estados son posibles; no convierte por sí solo el instrumento en válido. Las respuestas abiertas conservan matices, pero su clasificación posterior introduce decisiones de codificación.
Los ensayos previos examinan preguntas con personas pertinentes para la población. Una entrevista cognitiva busca dificultades e interpretaciones; no necesita una muestra representativa para estimar una prevalencia porque ése no es su objetivo. Un piloto del conjunto comprueba además contactos, duración, navegación y transformación de datos. Traducir preguntas requiere conservar significado en contextos de uso, no sólo correspondencia literal entre palabras.
Un cambio de canal, entrevistador o redacción puede cambiar respuestas aunque el fenómeno permanezca estable. Si una serie pasa de entrevistas presenciales a respuestas privadas, una diferencia temporal puede reunir cambio real y cambio de medición. Comparaciones planificadas entre versiones ayudan a estudiar esa posibilidad. Mantener una pregunta defectuosa por continuidad tampoco es una solución universal: corregirla exige documentar la ruptura y evaluar qué comparaciones siguen siendo defendibles.
134.5. Ponderación, incertidumbre y límites de generalización#
Las unidades seleccionadas pueden representar cantidades distintas de población. Un peso de diseño compensa esa desigualdad mediante la inversa de la probabilidad de inclusión. Si una unidad tiene probabilidad
Un estimador es la regla utilizada para obtener una estimación a partir de la muestra. Para estimar un total se suman los valores observados multiplicados por esos pesos. Si
El acento sobre
La no respuesta impide aplicar esa justificación sin más a quienes contestaron. Los pesos finales pueden incorporar ajustes y datos auxiliares. La guía de ponderación y estimación de Statistics Canada distingue estos pesos de los originales. La calibración estadística ajusta contribuciones para concordar con totales externos conocidos; aquí el término designa una operación sobre estimadores, distinta de la calibración instrumental del capítulo 132.
Ejemplo construido. La población consta de 800 explotaciones pequeñas y 200 grandes. Se seleccionan 80 de cada grupo mediante muestras aleatorias simples independientes y todas responden correctamente. Declaran conexión estable 40 pequeñas y 72 grandes. La proporción sin ponderar es 112/160 = 70 %. Sin embargo, se seleccionó una fracción 0,10 de pequeñas y 0,40 de grandes. Sus pesos son 10 y 2,5. El total estimado con conexión es 40 × 10 + 72 × 2,5 = 580; dividido por las 1.000 explotaciones da 58 %.
El ajuste de composición funciona en ese ejemplo porque se conocen el diseño, los grupos y sus tamaños. No demuestra que cualquier corrección por tamaño elimine todo sesgo. Si las pequeñas sin conexión responden menos dentro de su grupo, representar correctamente las 800 pequeñas todavía puede dejar una proporción incorrecta dentro de ellas. Un ajuste necesita supuestos sobre la relación entre las variables auxiliares, la participación y lo que se quiere estimar.
La incertidumbre de muestreo debe corresponder al diseño y al estimador. Estratos, conglomerados y pesos modifican la variación de las estimaciones entre muestras posibles. Procedimientos de cálculo o de remuestreo que ignoren esa estructura pueden ofrecer errores estándar inadecuados. Ponderar el porcentaje y calcular después su incertidumbre como si todos los casos procedieran de una muestra aleatoria simple no basta.
Como referencia limitada, para la proporción observada
Incluso un cálculo de muestreo correcto no incluye toda incertidumbre de la encuesta. Una pregunta que mide otra cosa, un registro incompleto o una selección voluntaria pueden desplazar el resultado fuera de un intervalo estrecho. La imputación, que asigna valores plausibles a ausencias según un método, tampoco convierte esos valores en respuestas observadas. Debe conservarse su identificación y considerar la incertidumbre del tratamiento aplicado.
Un informe interpretable especifica población, marco, selección, fechas, canal, cuestionario, resultados de contacto y métodos de ajuste. Conserva también información suficiente para reconocer qué denominador corresponde a cada porcentaje. Los resultados de subgrupos pequeños pueden ser mucho menos precisos que el agregado. Dividir una muestra amplia en muchas categorías no transmite a cada categoría la precisión del total.
La generalización termina donde terminan la cobertura defendible y los supuestos justificados. Una encuesta puede estimar frecuencias o asociaciones sin identificar por qué ocurren; esa pregunta requiere otros diseños. También puede dejar fuera los significados que orientan una respuesta aparentemente idéntica. La investigación cualitativa del capítulo siguiente profundiza en esa dimensión y puede ayudar a comprender qué mide realmente una variable antes de volver a contarla.
Preguntas de transferencia#
¿Consultar todo un registro elimina el error de cobertura?#
Mostrar respuesta razonada
Elimina la selección de una muestra dentro de ese registro si todas sus unidades se consultan, pero no añade las unidades omitidas. Tampoco garantiza respuesta completa ni medición correcta. La evaluación debe comparar el registro con la población objetivo y examinar las operaciones posteriores.
¿Una encuesta con cuotas iguales a las proporciones poblacionales equivale a una selección probabilística?#
Mostrar respuesta razonada
No. Las cuotas controlan cantidades en categorías observadas, mientras que el diseño probabilístico establece oportunidades de inclusión mediante un mecanismo conocido. Dentro de cada cuota pueden participar sobre todo unidades accesibles o motivadas. La inferencia requiere conocer qué mecanismo o supuestos permiten representarlas.
¿Puede bajar la tasa de respuesta sin aumentar el sesgo de una variable?#
Mostrar respuesta razonada
Sí. Si las nuevas ausencias no alteran la representación de esa variable, el sesgo puede no aumentar, aunque se pierda precisión. También puede ocurrir lo contrario para otra variable de la misma encuesta. La tasa no identifica sola la relación entre participación y resultados; se necesitan datos auxiliares, seguimiento o análisis de sensibilidad.
¿Por qué más respuestas no resuelven una pregunta ambigua?#
Mostrar respuesta razonada
Porque aumentan observaciones producidas por el mismo instrumento sin asegurar que representen una propiedad común. Si «buena conexión» significa velocidad para unas personas y continuidad para otras, una muestra mayor puede estimar con precisión una mezcla de criterios. Definir y probar la pregunta corrige un problema que el tamaño no aborda.
Fuentes y lecturas del capítulo#
- Statistics Canada. Coverage and frames, Quality Guidelines, versión web archivada consultada. Consultado para distinguir población objetivo, marco y errores de cobertura. Se emplean principios metodológicos; no se presenta como normativa vigente.
- Statistics Canada. Sample design, Quality Guidelines, versión web archivada consultada. Aporta la relación entre probabilidades, etapas de selección y condiciones de planificación; no se trasladan sus ejemplos históricos al presente.
- *Statistics Canada. 3.2.2 Probability sampling, Statistics: Power from Data!.* Consultado para las diferencias entre selección aleatoria simple, sistemática, estratificada y por conglomerados. Los escenarios y cantidades agrícolas del capítulo son construidos.
- American Association for Public Opinion Research. Best Practices for Survey Research. Orienta la distinción entre canal y selección y la revisión de instrumentos. Se usa como guía metodológica, sin convertir recomendaciones generales en garantías de ausencia de sesgo.
- American Association for Public Opinion Research. Standard Definitions, página institucional. Consultada para interpretar resultados de contacto y límites de la tasa de respuesta. La consulta corresponde a la explicación web, no a todos los informes enlazados.
- Statistics Canada. Response and nonresponse, Quality Guidelines, versión web archivada consultada. Apoya el papel de seguimiento e información auxiliar. Los límites 42–82 % se deducen de un ejemplo construido, no de datos de la institución.
- National Center for Health Statistics, CDC (2024). Cognitive Interviewing. Describe la evaluación de comprensión, recuperación, juicio y respuesta y su finalidad cualitativa. No se utilizan tamaños recomendados como recetas universales.
- Statistics Canada. Weighting and estimation, Quality Guidelines, versión web archivada consultada. Consultado para distinguir pesos de diseño y ajustes y exigir que la incertidumbre represente el diseño. La derivación y los cálculos numéricos del capítulo son explicativos propios.