PARTE XIII · Métodos: medición, territorio, capacidad e implementación
133
Diseño experimental, controles y replicación
Crear comparaciones que permitan aprender de una intervención
En este capítulo
Ejemplo construido. Dos tratamientos superficiales pretenden reducir la absorción de agua de un tablero. El primero se aplica a material de un lote y se ensaya por la mañana; el segundo, a otro lote y por la tarde. Al terminar, el primero presenta menor absorción. La diferencia puede reflejar el tratamiento, el material o las condiciones de ensayo. Medir con mayor precisión la absorción no separa esas explicaciones que el diseño mantuvo unidas.
Un experimento crea variaciones deliberadas para estudiar sus consecuencias. Su fuerza depende de la comparación que hace posible: qué cambió, qué se mantuvo y qué otras diferencias pudieron acompañar la intervención. El diseño empieza al formular la pregunta y continúa en la asignación, ejecución, medición y análisis. Una tabla numerosa obtenida de una comparación ambigua puede contener menos información pertinente que un ensayo pequeño bien organizado.
133.1. Pregunta, hipótesis y resultado medible#
«Encontrar un tratamiento mejor» es una intención, todavía no una pregunta experimental. Hace falta determinar respecto de qué alternativa, sobre qué material, bajo qué condiciones y para qué propiedad. El manual de diseño experimental del NIST relaciona objetivos, factores modificados y respuestas observadas. Esa relación organiza la elección de operaciones y permite interpretar lo que sucede.
En el ejemplo, una pregunta concreta sería si el tratamiento R reduce, respecto de S, la absorción media de agua por unidad de área después de una hora de exposición mediante un procedimiento especificado. La respuesta se expresa en gramos por metro cuadrado. Temperatura, preparación, exposición y definición de superficie entran en el protocolo. El ensayo delimita la superficie expuesta y controla los bordes creados al cortar las probetas. El resultado no representaría automáticamente resistencia mecánica, durabilidad durante años ni comportamiento ante otra forma de exposición.
La hipótesis sustantiva propone una diferencia con significado para el uso. Una hipótesis estadística traduce parte de esa propuesta a un modelo: por ejemplo, igualdad de medias entre tratamientos. Rechazar esa igualdad no demuestra todo el mecanismo físico que motivó el ensayo. Un tratamiento puede alterar simultáneamente varias propiedades; la comparación descubre consecuencias de la intervención ejecutada, dentro de su alcance.
Conviene decidir qué resultado será principal antes de observar los datos. Absorción, cambio de masa, tiempo hasta una filtración y proporción de tableros que superan un límite no son resúmenes equivalentes. El resultado principal determina gran parte del análisis y de la planificación de precisión. El apartado sobre resultados de CONSORT 2025 especifica variable, métrica, agregación y tiempo de medición para ensayos clínicos. Esa exigencia ilustra una necesidad que también aparece en experimentos materiales, sin convertir una guía clínica en normativa universal de laboratorio.
La unidad experimental es la entidad a la que se asigna la intervención. No coincide necesariamente con cada objeto medido o cada fila de datos. La guía del Experimental Design Assistant del NC3Rs distingue la unidad que recibe el tratamiento de las mediciones múltiples realizadas sobre ella. La distinción es decisiva para evaluar cuánta repetición de la intervención existe.
En una nueva organización del ensayo construido se utilizan cuatro lotes, con dos tableros por lote. Dentro de cada lote se asigna al azar R a uno y S al otro. El tratamiento se aplica por separado a cada tablero; de cada uno se obtienen después tres probetas para medir absorción. Hay ocho tableros que reciben tratamiento y veinticuatro observaciones de probetas. Esas observaciones ayudan a caracterizar cada tablero, pero no representan veinticuatro asignaciones independientes.
Si todo el material de R se tratara en un único baño y todo el de S en otro, la diferencia podría incluir características de ambos baños. Para estudiar un efecto reproducible entre aplicaciones se necesitarían aplicaciones independientes de cada tratamiento. El análisis debe representar ese nivel; introducirlo en un modelo no crea las réplicas que faltan cuando sólo existe un baño por tratamiento. La unidad pertinente puede cambiar con la forma de administrar el tratamiento. Dibujar primero la estructura física de aplicación y medición ayuda a impedir que el análisis invente independencia.
La elección de unidades tampoco determina por sí sola la población a la que se generaliza. Un experimento con material elegido por disponibilidad informa directamente sobre ese material y las condiciones evaluadas. Extenderlo a todos los proveedores o tipos de tablero requiere supuestos y evidencia adicionales. La asignación aleatoria facilita una comparación causal interna; el muestreo de la población, tratado en el capítulo siguiente, cumple otra función.
133.2. Controles, aleatorización y cegamiento#
El grupo de comparación permite interpretar qué habría ocurrido bajo una alternativa. Un control sin tratamiento estudia el cambio asociado al conjunto de operaciones añadidas; un control con el procedimiento habitual estudia si una propuesta mejora esa práctica. Si interesa separar el efecto de una sustancia del efecto de manipular el material, puede requerirse un control sometido a manipulación semejante sin el componente estudiado. El control adecuado depende de la pregunta.
Un control negativo puede comprobar que un sistema no produzca una señal cuando falta aquello que debería provocarla. Un control positivo puede comprobar que el sistema detecte una respuesta conocida. Estas comprobaciones diagnostican aspectos del funcionamiento, pero no sustituyen al comparador de la intervención. Que un instrumento detecte el control positivo no demuestra que toda diferencia entre R y S provenga del tratamiento.
La aleatorización asigna intervenciones mediante un mecanismo de azar especificado. Busca evitar que la asignación dependa sistemáticamente de propiedades que influyen en el resultado y proporciona una base para la inferencia. El NIST presenta la asignación aleatoria de niveles a unidades experimentales y la aleatorización de la secuencia de ejecución. Son decisiones relacionadas, pero no idénticas: aleatorizar el tratamiento y ejecutar siempre todos los casos de R antes de S todavía permite confundir diferencias con el paso del tiempo.
La aleatorización no garantiza igualdad exacta de grupos en una realización finita. Puede producir desequilibrios por azar, sobre todo con pocas unidades. Tampoco compensa una medición distinta entre grupos ni una pérdida selectiva posterior. Su justificación se refiere al mecanismo de asignación y debe acompañarse de controles de ejecución y análisis.
Los bloques agrupan unidades comparables respecto de una influencia importante. En el ensayo, cada lote constituye un bloque: ambos tratamientos aparecen dentro de él. La comparación R−S puede realizarse dentro de cada lote y después combinarse, atendiendo al modelo. El diseño de bloques aleatorizados del NIST utiliza esta estructura para distinguir factores de interés de otras fuentes de variación. Bloquear no exige que las unidades sean idénticas; busca comparaciones más informativas dentro de grupos definidos.
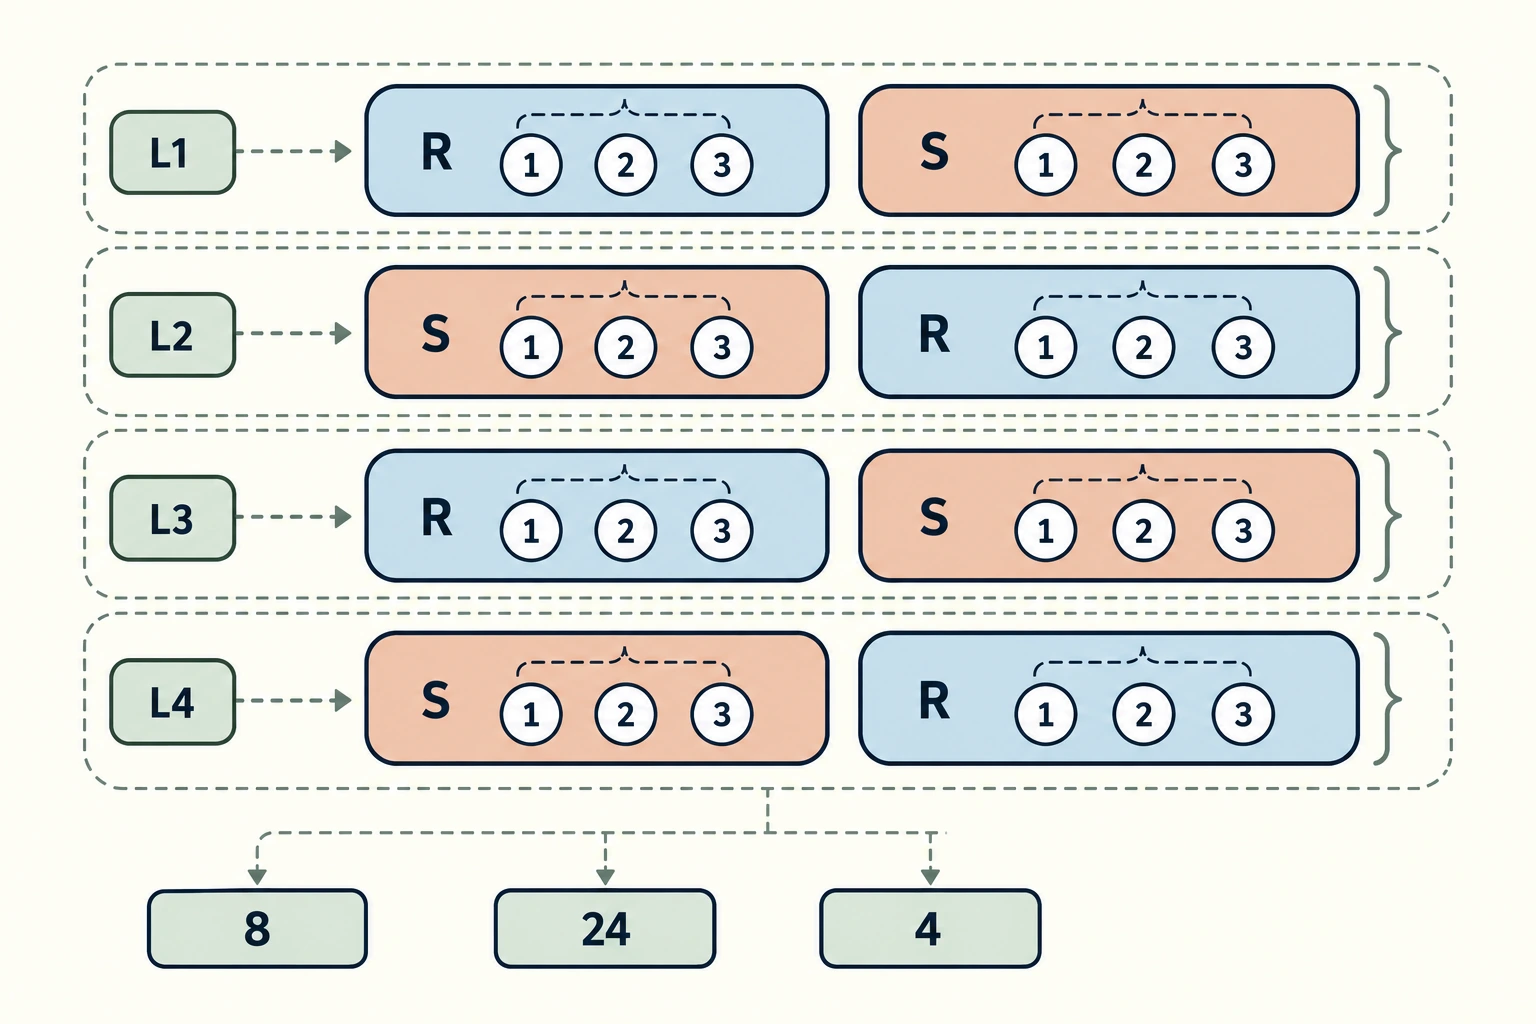
La intervención se asigna al tablero. Las probetas aportan observaciones dentro de él; el análisis conserva esa estructura y la comparación dentro de cada lote
En estudios con reclutamiento, conocer la próxima asignación puede influir en quién entra. La ocultación de la asignación protege la secuencia hasta que la incorporación y asignación estén realizadas. El apartado 18 de CONSORT 2025 distingue esta protección del cegamiento posterior. Una secuencia originalmente aleatoria puede perder su función si alguien modifica la inclusión en respuesta a asignaciones previstas.
El cegamiento, o enmascaramiento, limita información sobre tratamientos cuando conocerla podría alterar ejecución, medición o análisis. En el ensayo material, quien evalúa las probetas puede recibir códigos sin identificar R y S. Si el aspecto revela el tratamiento, esa protección puede ser incompleta; debe describirse. El apartado sobre quién estuvo cegado exige identificar funciones concretas en lugar de depender de expresiones ambiguas como «doble ciego».
Hay intervenciones cuyo ejecutor necesariamente conoce el tratamiento. Aun así, puede separarse la medición de la ejecución, automatizar criterios o mantener cegado el análisis inicial. El diseño registra quién tuvo acceso a qué información y cuándo. Estas medidas reducen oportunidades de influencia; no sustituyen la capacidad técnica ni eliminan toda fuente de sesgo.
133.3. Potencia, tamaño muestral y precisión#
Una pregunta experimental necesita suficiente información para distinguir diferencias relevantes de variación. El tamaño requerido depende de la respuesta, su variabilidad, el efecto que interesa, la estructura de dependencia y el análisis. Fijar una cantidad de observaciones sólo por costumbre deja sin justificar la capacidad del experimento.
La potencia es la probabilidad de que un procedimiento rechace la hipótesis nula cuando una alternativa especificada es verdadera. No es una probabilidad de que la hipótesis sea cierta después del ensayo. Una potencia del 80 % para cierta diferencia describe el comportamiento esperado del diseño bajo esa diferencia y sus supuestos. Puede ser menor para diferencias más pequeñas, para mayor variación o para pérdidas de información no previstas.
La planificación debe utilizar un efecto cuya magnitud tenga sentido para el propósito. Un cambio detectable pero irrelevante no justifica una mejora práctica. Tampoco conviene tomar como expectativa firme una estimación extrema obtenida en un estudio pequeño: si la diferencia real es menor, el nuevo diseño puede quedar insuficientemente informado. Las suposiciones deben mostrar su procedencia y explorarse mediante escenarios razonables.
El apartado de tamaño muestral de CONSORT 2025 relaciona respuesta principal, diferencia prevista, variación, prueba y potencia. Un diseño con grupos, emparejamiento o mediciones repetidas necesita un cálculo compatible con esa estructura. En el ensayo de tableros, aumentar probetas por tablero puede mejorar su caracterización y dejar prácticamente intacta la limitada repetición entre lotes y aplicaciones.
También puede planificarse a partir de la precisión de estimación. El NIST sobre tamaños muestrales distingue la anchura deseada de un intervalo de las probabilidades asociadas a una prueba. Para mostrar el mecanismo, se considera una situación simplificada distinta del ensayo bloqueado: dos grupos con
La media de cada grupo tiene varianza
Aquí
Ejemplo construido. Para una respuesta de absorción con
La fórmula permite ver por qué reducir a la mitad la semianchura requiere aproximadamente cuadruplicar el número de unidades. Si
Las pérdidas de datos reducen información y pueden introducir sesgo. Planificar más unidades puede amortiguar la pérdida de precisión, pero no corrige automáticamente que desaparezcan selectivamente ciertos resultados. En el ejemplo material, excluir las probetas que se desintegran podría omitir una consecuencia del tratamiento. La definición de respuesta y el plan deben prever cómo registrar e interpretar ese desenlace.
La suficiencia estadística convive con factibilidad, coste y límites éticos. Cuando participan personas o animales, no basta optimizar una fórmula: la intervención requiere justificación y las protecciones aplicables. Un estudio grande con una comparación inválida puede desperdiciar recursos y exposición; uno pequeño puede ser útil como piloto de factibilidad sin presentarse como prueba concluyente de eficacia.
133.4. Replicación, robustez y resultados nulos#
Repetir lecturas, volver a analizar un archivo y realizar un nuevo estudio son acciones distintas. En la terminología adoptada por las National Academies en 2019, la reproducibilidad computacional obtiene resultados consistentes con los mismos datos y pasos de análisis; la replicabilidad estudia consistencia mediante datos nuevos dirigidos a la misma pregunta. Los términos varían entre disciplinas. Estos usos no sustituyen las condiciones metrológicas de repetibilidad y reproducibilidad tratadas antes.
Un análisis que se ejecuta de nuevo y produce la misma cifra demuestra una propiedad del procesamiento. Puede repetir un error de medición, una exclusión injustificada o una comparación confundida. Una replicación con datos nuevos puede estudiar si el efecto reaparece, pero necesita conocer suficientemente la intervención y la respuesta original. El nombre de un tratamiento no describe su preparación, aplicación y condiciones.
Tratar como independientes observaciones que no representan repetición independiente de la intervención genera seudorreplicación. El resumen del trabajo de Hurlbert de 1984 define el problema por la ausencia de réplica de tratamientos o la falta de independencia estadística relevante. En el ejemplo construido, ignorar el tablero y contar cada probeta como ensayo independiente exagera la información para comparar tratamientos entre tableros.
Las observaciones subordinadas no son inútiles. Permiten estudiar variación dentro de unidades y mejorar su resumen. El análisis puede utilizar promedios por tablero o un modelo que conserve niveles, según la pregunta y los supuestos. El problema aparece cuando se atribuyen a esas observaciones capacidades que el diseño no creó.
La robustez examina cuánto depende una conclusión de decisiones y condiciones razonables. Puede comprobarse mediante otros resúmenes, modelos de variación, criterios justificados de inclusión o condiciones de aplicación. Si un efecto aparece únicamente después de una exclusión arbitraria, necesita una explicación. Si se modifica deliberadamente el entorno, el objetivo puede pasar de replicar una condición a investigar la extensión del efecto a otra.
Una interacción revela que el efecto de un factor depende de otro. Ejemplo construido. El tratamiento R podría reducir absorción frente a S después de un secado prolongado y aumentarla después de un secado breve. Promediar ambas condiciones puede producir una diferencia cercana a cero y esconder ese cambio. Un diseño factorial completo combina los niveles de los factores para estudiar tales relaciones. Las repeticiones y el análisis siguen siendo necesarios para distinguir el patrón de variación.
Un resultado no significativo tampoco demuestra igualdad. Puede corresponder a un efecto pequeño o a información insuficiente. Ejemplo construido. Una diferencia estimada R−S de −2 g/m², con intervalo del 95 % de −8 a 4 g/m², admite reducciones y aumentos relevantes para ciertos usos. Si el umbral práctico se fija en 2 g/m², ese intervalo no permite concluir que la diferencia carezca de importancia.
Otro resultado construido, −0,4 g/m² con intervalo también del 95 % de −1,0 a 0,2 g/m², restringe las magnitudes compatibles bajo el modelo a valores dentro de ±2 g/m². Aporta evidencia mucho más precisa respecto de ese umbral. Una demostración formal de equivalencia requiere formular márgenes y procedimiento de antemano; no se obtiene simplemente porque el intervalo contenga cero. Los intervalos conservan sus supuestos de muestreo, asignación y análisis.
La replicación se evalúa considerando magnitudes e incertidumbres, no sólo si dos valores p quedan a lados distintos de 0,05. Una diferencia de significación no constituye por sí sola una diferencia significativa entre efectos. Investigar una discrepancia exige examinar material, procedimiento, variación, cumplimiento y capacidad de medición. Una secuencia de estudios puede delimitar condiciones de un efecto sin que cada ensayo aislado proporcione una sentencia definitiva.
133.5. Del protocolo al registro auditable#
El protocolo conecta la pregunta con decisiones antes de conocer los resultados: unidades, asignación, intervenciones, mediciones, tamaño, análisis y criterios de inclusión. Los detalles pertinentes permiten repetir operaciones y reconocer desviaciones. El apartado sobre acceso al protocolo de CONSORT 2025 distingue el protocolo completo del plan estadístico y exige conservar modificaciones con razones y fechas. Publicar sólo una descripción reconstruida después puede ocultar cómo cambiaron las decisiones.
El prerregistro deja una versión fechada del plan antes de observar o analizar la información pertinente. La guía del Center for Open Science lo utiliza para distinguir análisis previstos de exploración posterior. No obliga a ignorar hallazgos nuevos ni certifica calidad. Un plan ambiguo o conceptualmente equivocado puede quedar registrado con toda precisión administrativa y seguir siendo inadecuado.
Durante la ejecución, cada unidad conserva identidad, asignación y operaciones realizadas. En el ejemplo, los registros relacionan lote, tablero, tratamiento y probeta. Deben poder distinguir una intervención prevista de la efectivamente aplicada. Un intercambio de etiquetas no se resuelve únicamente con un archivo de aleatorización correcto; requiere evidencia de lo ocurrido físicamente.
Los datos originales se preservan y las transformaciones se documentan. Un diccionario identifica variables, unidades, códigos de ausencia y criterios de cálculo. Las exclusiones tienen motivos verificables. Las versiones de programas y parámetros permiten reconstruir resultados. Compartir datos no exige divulgar identificadores personales: la disponibilidad debe organizarse según consentimiento, privacidad y restricciones aplicables, manteniendo vías adecuadas de revisión.
Las reglas de parada también afectan la inferencia. Examinar repetidamente resultados y detenerse cuando parecen favorables altera el comportamiento de un análisis diseñado para una muestra fija. El apartado sobre análisis intermedios de CONSORT 2025 exige informar momentos, motivos, métodos y reglas. Los diseños secuenciales pueden responder a esta necesidad si se planifican y analizan apropiadamente. No basta llamar «adaptativo» a una decisión improvisada.
Los cambios legítimos se registran con su momento y su relación con información ya conocida. Una avería puede exigir otro instrumento; una hipótesis nueva puede motivar un análisis exploratorio. La transparencia permite evaluar consecuencias y, cuando corresponda, confirmar hallazgos con nuevos datos. Presentar una decisión posterior como si hubiera sido prevista altera el significado de la evidencia.
El informe final conecta resultados con lo planeado y lo ejecutado. Describe magnitudes, incertidumbres, pérdidas, desviaciones y límites de generalización. Una persona que revise el estudio debe poder identificar qué comparación produjo cada conclusión. Esa posibilidad de auditoría transforma un resultado aislado en conocimiento que otros pueden contrastar, corregir y ampliar.
Preguntas de transferencia#
¿Cien mediciones de una sola unidad proporcionan cien réplicas del tratamiento?#
Mostrar respuesta razonada
No necesariamente. Pueden mejorar el conocimiento de esa unidad, pero la repetición relevante depende de dónde se asigna y aplica la intervención. Si toda ella recibió una única aplicación, las mediciones no multiplican aplicaciones independientes. El análisis debe conservar niveles y dependencias.
¿Por qué aleatorizar la asignación y también considerar el orden de ejecución?#
Mostrar respuesta razonada
Porque asignar grupos al azar no impide que un grupo se mida antes y otro después. Un cambio temporal puede entonces acompañar al tratamiento. Aleatorizar o bloquear adecuadamente la secuencia, además de registrar condiciones, ayuda a separar ambas influencias.
¿Un resultado no significativo justifica afirmar que dos métodos son intercambiables?#
Mostrar respuesta razonada
No. Puede reflejar baja precisión. La intercambiabilidad necesita criterios sustantivos y márgenes aceptables, además de una evaluación adecuada de otras propiedades. Una conclusión sobre equivalencia requiere un diseño y análisis que respondan a esa pregunta.
¿Qué aporta una replicación si las estimaciones difieren?#
Mostrar respuesta razonada
Aporta información nueva sobre magnitud, variación y posibles condiciones del efecto. Se evalúa si las diferencias exceden lo esperable dadas las incertidumbres y qué cambió entre estudios. La discrepancia puede revelar límites de generalización, problemas de procedimiento o incertidumbre insuficientemente evaluada; su origen requiere investigación.
Fuentes y lecturas del capítulo#
- NIST/SEMATECH. e-Handbook of Statistical Methods. Qué es diseño experimental, diseños completamente aleatorizados, bloques aleatorizados y factoriales completos. Sustentan relaciones entre objetivos, factores, asignación, bloques e interacción; los ejemplos de tableros son construidos.
- NC3Rs. Experimental Design Assistant: Experimental unit, actualizado en 2023. Consultado para distinguir unidades de intervención de observaciones repetidas y reconocer estructuras de aplicación. Su contexto original es investigación animal; el ejemplo material constituye una aplicación explicativa propia.
- Grupo SPIRIT–CONSORT (2025). Explicación y elaboración de CONSORT, versión web oficial. Resultado principal, ítem 14, ocultación de asignación, ítem 18, quién estuvo cegado, ítem 20a y tamaño muestral, ítem 16a. Se utilizan para precisar decisiones metodológicas y su comunicación, conservando el alcance clínico de la guía.
- Grupo SPIRIT–CONSORT (2025). Acceso al protocolo y plan estadístico, ítem 3 y análisis intermedios, ítem 16b. Base para registrar versiones, cambios, momentos de análisis y reglas de parada.
- NIST/SEMATECH. Sample sizes required, sección 7.2.2.2. Consultado para la relación entre precisión, variación y planificación bajo supuestos explícitos. El cálculo de dos grupos se deriva en el capítulo mediante suma de varianzas independientes.
- National Academies of Sciences, Engineering, and Medicine (2019). Reproducibility and Replicability in Science, capítulo 3: Understanding Reproducibility and Replicability. DOI del libro: 10.17226/25303. Consultado para distinguir reproducibilidad computacional, replicación con nuevos datos y variación terminológica entre disciplinas.
- Hurlbert, Stuart H. (1984). Pseudoreplication and the Design of Ecological Field Experiments, Ecological Monographs, 54(2), 187–211. DOI: 10.2307/1942661. Se consultaron la información bibliográfica y el resumen abierto del editor para la definición del problema; no se atribuyen al texto completo los ejemplos de este capítulo.
- Center for Open Science. Preregistration. Recurso institucional sobre planes fechados, distinción entre análisis previstos y exploratorios y comunicación de desviaciones. El prerregistro se presenta como una ayuda de transparencia, no como certificación de validez.