PARTE XXXIV · Manufactura, procesos, oficios y mantenimiento
389
Mantenimiento, reparación, lubricación y repuestos
Cómo conservar funciones, controlar riesgos y aprender de lo que se degrada
En este capítulo
Una bomba puede seguir girando y, sin embargo, haber dejado de cumplir su función. Puede entregar menos caudal, vibrar, calentar un rodamiento, contaminar el producto o perder estanqueidad. Si se espera a que se detenga por completo, quizá el equipo ya haya dañado otras piezas, detenido una línea o expuesto a alguien a energía peligrosa. Si se cambia todo por calendario, se puede introducir un error de montaje, desechar piezas todavía útiles y gastar recursos sin reducir el riesgo que realmente importa.
El mantenimiento conserva o restituye la capacidad de un activo para cumplir una función bajo condiciones definidas. La reparación es una intervención que devuelve una condición de servicio, pero no garantiza por sí sola que la causa de una falla desaparezca. La lubricación, la limpieza, la alineación y los ajustes son medios concretos que pueden evitar degradación o recuperar una relación geométrica; también pueden crear contaminación, atrapamiento o daño si se hacen sin identificar el equipo, la energía y el producto adecuados. Los repuestos son parte de la estrategia: una pieza ausente puede prolongar una parada, mientras un inventario indiscriminado inmoviliza dinero y envejece materiales.
La pregunta no es si conviene hacer mantenimiento «preventivo» o «correctivo» en abstracto. Hay que saber qué función se protege, cómo puede perderse, qué señales anticipan la pérdida, qué consecuencia tendría, qué tarea es técnicamente posible y cómo se ejecutará sin exponer a personas ni al sistema. El capítulo 388 explicó cómo inspección, ensayos y trazabilidad producen evidencia de calidad; aquí esa evidencia se convierte en decisiones de mantenimiento. El capítulo 390 tratará el pensamiento ingenieril y las restricciones de diseño; aquí se trabaja con activos en uso y con la memoria concreta de sus fallas.
389.1. Falla funcional, degradación y criticidad#
La falla depende de la función#
Una falla funcional es la incapacidad de un activo para cumplir una función requerida bajo condiciones especificadas. No exige que el equipo esté inmóvil. Un ventilador puede mantener movimiento y no alcanzar el flujo necesario; una válvula puede abrir y no cerrar cuando debe; un sensor puede emitir valores plausibles pero desviados; un sello puede permitir una fuga pequeña que vuelve inseguro el proceso. El mismo componente puede estar sano para una tarea y fallar para otra.
Definir la función obliga a nombrar capacidad, condiciones y límites. «La bomba funciona» es menos informativo que «transfiere el fluido previsto, al caudal y presión requeridos, sin fuga inaceptable, durante el régimen de operación definido». La función puede incluir contención, protección, medición, calidad del producto, seguridad, emisiones, ruido o disponibilidad. Si se omite una función, el plan de mantenimiento la tratará como si no existiera.
La degradación es un cambio que reduce margen o desempeño aunque todavía no haya pérdida funcional. Desgaste, corrosión, fatiga, erosión, incrustación, contaminación del lubricante, deriva de un sensor, holgura o envejecimiento de un sello son mecanismos distintos. Un modo de falla describe cómo se manifiesta la pérdida —por ejemplo, fuga, bloqueo, sobrecalentamiento o lectura sesgada—; una causa explica por qué ocurrió —material incompatible, carga, instalación, ambiente, error de diseño o mantenimiento inadecuado—. Separarlos evita que «se rompió» se convierta en una explicación.
La vida de una pieza no es una fecha universal. Depende de carga, ciclos, temperatura, humedad, contaminación, montaje, uso, calidad del material y mantenimiento. Dos rodamientos iguales pueden tener historias distintas si uno trabaja desalineado o con partículas. Cambiar ambos a la misma edad puede ser prudente cuando una consecuencia grave no admite inspección eficaz; puede ser innecesario cuando existe una señal fiable y margen de intervención. La decisión debe basarse en función y evidencia, no en la ilusión de que todo envejece con el mismo calendario.
Criticidad no es solo valor económico#
La criticidad prioriza qué activos o modos de falla merecen más atención y recursos. Puede considerar seguridad de personas, ambiente, continuidad del servicio, calidad, cumplimiento legal, pérdida de producto, tiempo de recuperación, detectabilidad, redundancia y posibilidad de reparación. Un motor barato que detiene la ventilación de un espacio peligroso puede ser más crítico que un equipo caro con respaldo inmediato. Una válvula de bajo costo puede tener consecuencias altas si pierde contención.
La criticidad es una propiedad del contexto, no una etiqueta eterna pegada al activo. Cambia con la carga de producción, la estación, la configuración de la red, el inventario de repuestos, el clima, el personal disponible y la presencia de equipos redundantes. Una máquina que opera normalmente en paralelo puede volverse crítica durante la parada de la otra. La clasificación debe tener una razón trazable y una fecha de revisión.
Conviene distinguir consecuencia, probabilidad y capacidad de detección. Una falla poco frecuente puede requerir controles intensos si la consecuencia es catastrófica; una falla frecuente puede ser tolerable si hay redundancia y reparación segura. Una señal fácil de detectar permite actuar antes; una degradación oculta exige diseño, prueba funcional o redundancia. Multiplicar categorías en una matriz no produce precisión automática: los criterios deben ser comprensibles y consistentes.
La confiabilidad tampoco es sinónimo de disponibilidad. La confiabilidad pregunta cuánto tiempo o cuántos ciclos cumple una función sin fallar bajo condiciones definidas. La mantenibilidad se refiere a la facilidad y rapidez con que puede conservarse o restaurarse. La disponibilidad combina estados de operación, espera, reparación, logística y, a veces, redundancia. Un equipo puede fallar rara vez y tardar meses en repararse; otro puede fallar más y recuperarse rápidamente. Elegir una sola cifra oculta los compromisos.
El riesgo de mantener y el riesgo de no mantener#
Mantenimiento reduce algunos riesgos y crea otros. Abrir un equipo puede liberar presión, calor, productos, electricidad, movimiento o contaminación. Limpiar un depósito puede movilizar un residuo; ajustar una protección puede alterar una distancia; cambiar un sensor puede dejar al sistema sin una función de alarma. No intervenir también tiene consecuencias: una grieta crece, una fuga se extiende, un lubricante pierde capacidad o un dispositivo de seguridad queda degradado.
El plan debe comparar ambos riesgos y especificar condiciones de trabajo. La guía de la HSE sobre mantenimiento de equipos recuerda que deben considerarse tanto quienes realizan la tarea como otras personas afectadas, y que las instrucciones del fabricante son una referencia especialmente importante para funciones críticas (HSE, mantenimiento de equipos de trabajo). La selección de una tarea no autoriza a ejecutarla sin competencia, aislamiento, herramientas, acceso y comunicación adecuados.
La criticidad orienta el esfuerzo, pero no reemplaza el juicio técnico. Si el activo contiene energía peligrosa, una tarea de bajo costo no es de bajo riesgo. Si el equipo protege una barrera de seguridad, probar su funcionamiento puede ser más importante que medir su aspecto. La primera sección deja una regla: mantener es preservar funciones dentro de un sistema, no rejuvenecer objetos por rutina.
389.2. Mantenimiento correctivo, preventivo y predictivo#
Tres familias, varias decisiones#
El mantenimiento correctivo se realiza después de detectar una falla o una condición que requiere acción. Puede ser una reparación inmediata, una corrección planificada o una sustitución tras una inspección. No equivale necesariamente a negligencia: dejar que un componente falle puede ser razonable si la función no es crítica, la falla es segura, el costo de prevención supera el beneficio y la recuperación está preparada. Se vuelve irresponsable cuando el modo de falla expone personas, contamina, destruye equipos vecinos o impide una respuesta ordenada.
El mantenimiento preventivo se programa antes de la falla funcional. Puede basarse en tiempo, ciclos, uso, temporada o tareas de restauración. Cambiar un elemento desgastable en un intervalo puede limitar consecuencias si la degradación sigue una trayectoria conocida. Pero el calendario no garantiza que todas las unidades tengan la misma vida; sustituir demasiado pronto genera costo y errores de intervención, mientras sustituir demasiado tarde deja poco margen. La periodicidad debe apoyarse en experiencia, fabricante, normativa, condiciones de servicio y evidencia local.
El mantenimiento predictivo o basado en condición decide a partir de señales de degradación: vibración, temperatura, corriente, presión, fugas, partículas, sonido, desempeño, análisis de aceite u otras variables. No es adivinación ni un sinónimo de inteligencia artificial. Una señal sirve solo si se relaciona con un modo de falla, puede medirse con suficiente calidad y deja tiempo para actuar. La tecnología puede detectar una anomalía sin decir su causa, severidad o acción segura. Un tablero lleno de alertas no es un plan de mantenimiento.
La NASA presenta el mantenimiento centrado en confiabilidad como una combinación de estrategias, desde acciones basadas en condición y tiempo hasta funcionamiento hasta falla, elegida según funciones y consecuencias (NASA, Reliability-Centered Maintenance Guide). La idea importante no es copiar una matriz espacial, sino evitar que una sola política domine todos los activos. Cada modo de falla necesita una tarea técnicamente eficaz o una decisión explícita de aceptar la consecuencia.
Intervalos, señales y márgenes#
Un intervalo preventivo debe responder a una pregunta: ¿qué cambia con el tiempo o los ciclos, y qué tarea devuelve margen antes de la falla? Si no existe relación demostrada entre edad y probabilidad de falla, aumentar la frecuencia no necesariamente mejora la confiabilidad. Puede incluso aumentar el riesgo por desmontajes, errores de montaje y exposición del personal. En otros casos, la degradación es progresiva y una tarea a intervalos razonables sí puede evitar el modo de falla.
La inspección basada en condición necesita un intervalo P-F conceptual: el tiempo entre que una degradación se vuelve detectable y que produce falla funcional. Si la inspección ocurre después del intervalo, la señal no sirve para planificar. Si ocurre con demasiada frecuencia, puede consumir recursos sin agregar información. El margen real depende de velocidad de degradación, incertidumbre de medición, acceso, consecuencias y tiempo de respuesta de repuestos y personal. No debe convertirse en un número universal.
El mantenimiento predictivo puede reducir paradas innecesarias cuando la señal es válida, pero también puede aumentar complejidad. Sensores mal instalados, datos incompletos, cambios de operación y umbrales heredados producen falsas alarmas o silencios. El sistema debe registrar qué se midió, dónde, con qué instrumento, en qué condición y qué decisión siguió. La primera alarma no es todavía un diagnóstico; es una razón para confirmar y actuar según procedimiento.
Seguridad durante la intervención#
Antes de reparar, ajustar, limpiar o lubricar hay que controlar energía eléctrica, mecánica, hidráulica, neumática, térmica, química, gravitatoria y cualquier energía almacenada o re-acumulable. La OSHA explica que el control de energía peligrosa mediante bloqueo y etiquetado protege frente a arranque inesperado o liberación durante servicio y mantenimiento, y que el programa requiere procedimientos, formación y verificación (OSHA, Control of Hazardous Energy). Esta referencia describe un marco regulatorio estadounidense; otros lugares tienen requisitos propios, pero la lógica de identificar, aislar y comprobar no se puede omitir.
Un equipo «apagado» no es necesariamente aislado. Puede quedar presión en una línea, carga en una estructura, inercia en un volante, calor en una superficie o tensión en un resorte. La autorización, el aislamiento, la disipación, la prueba de ausencia de energía, el control de llaves y la restitución ordenada forman parte de la tarea. No se deben convertir estas ideas en una secuencia genérica para cualquier instalación: los procedimientos deben ser específicos del equipo y ejecutados por personal competente.
El mantenimiento debe coordinarse con operación, producción, contratistas y usuarios. Una alarma inhibida, una guarda retirada o una válvula cerrada puede afectar a quienes no están en el área de trabajo. El permiso de trabajo, la comunicación de cambios y la prueba de retorno a servicio evitan que una reparación correcta en una pieza produzca una condición insegura en el sistema. La planificación también necesita tiempo realista: apresurar una tarea para cumplir una ventana puede cambiar el riesgo que se pretendía reducir.
389.3. Inspección, diagnóstico y análisis de causa#
De la señal al problema#
Diagnosticar es construir y contrastar explicaciones de una desviación. La señal inicial puede ser una vibración, un ruido, un olor, un aumento de temperatura, una fuga, un consumo anormal, una alarma, una pérdida de precisión o una queja de usuario. La señal no identifica por sí sola la causa. Un aumento de temperatura puede venir de fricción, mala lubricación, sobrecarga, desalineación, ambiente o sensor defectuoso. Una fuga puede originarse en sello, superficie, presión, montaje o daño de una junta.
El diagnóstico comienza describiendo qué función cambió, cuándo, bajo qué condiciones y respecto de qué referencia. Se conserva el estado antes de desmontar: fotografías, lecturas, muestras, posición, ruido, historial de cargas y relación con otros eventos. Cambiar piezas al azar puede eliminar la evidencia y producir una reparación aparente. Una hipótesis útil predice qué otra señal debería observarse y qué prueba la distinguiría de una explicación rival.
La inspección visual, la medición de vibración, la termografía, el análisis de aceite, la prueba eléctrica, el control de alineación o el examen de una superficie pueden aportar evidencia, pero cada método tiene alcance. El capítulo 388 explicó que una inspección detecta señales bajo condiciones concretas, no todos los defectos posibles. En mantenimiento, esto significa que una lectura normal no autoriza a declarar «sin falla» si el modo de falla no era detectable por esa técnica.
Causa inmediata, mecanismo y sistema#
Una causa inmediata describe el evento próximo: se rompió una correa, se quemó un fusible, se obstruyó un filtro. El mecanismo explica el proceso físico: fatiga, sobrecalentamiento, abrasión, corrosión, contaminación, sobrecarga o pérdida de aislamiento. La causa sistémica pregunta por qué el diseño, la instalación, la operación, la inspección o la gestión permitieron que el mecanismo avanzara. Las tres capas pueden ser necesarias. Sustituir la correa resuelve la consecuencia visible; corregir tensión, alineación y protección contra contaminación puede reducir recurrencia.
El análisis de causa debe evitar el lenguaje que termina en una persona. «No lubricó» puede ocultar un punto inaccesible, una etiqueta ilegible, un producto ambiguo, una frecuencia imposible, un trabajo sin tiempo o una instrucción incompatible con el equipo. Eso no elimina responsabilidad individual cuando existe una violación deliberada, pero la investigación debe comprobar primero qué barreras ofrecía el sistema. La seguridad mejora cuando los fallos se pueden reportar sin castigo automático y cuando los datos de casi fallas llegan a quien puede rediseñar la tarea.
Una causa plausible necesita evidencia. Se comparan equipos similares, fechas, materiales, cargas, ambiente, registros, piezas retiradas y cambios recientes. Un análisis de Pareto puede priorizar frecuencias; los cinco porqués pueden profundizar una cadena; un diagrama de causa puede organizar factores. Ninguna herramienta demuestra causalidad por el solo hecho de producir un gráfico. Si no se puede distinguir entre hipótesis, se debe declarar incertidumbre y elegir una prueba o una acción provisional que reduzca exposición sin fingir certeza.
Reparar no es solo reemplazar#
Una reparación restituye una función mediante limpieza, ajuste, unión, sustitución, restauración o modificación autorizada. La solución puede ser temporal o permanente, y esas categorías deben quedar claras. Un parche que permite seguir operando puede ser razonable como contención si se controla su duración y riesgo; se vuelve peligroso si se olvida como sustituto de una reparación definitiva. Cambiar un componente por otro de aspecto similar puede modificar capacidad, compatibilidad, sellado, disipación, certificación o modo de falla.
Antes del retorno a servicio se verifica la función relevante y las barreras de seguridad. La prueba puede incluir estanqueidad, giro, señal, carga, protección, calidad del producto o ausencia de contaminación, según el activo. No basta comprobar que el motor arranca. El desmontaje, las herramientas, los pares de apriete, los ajustes y las piezas sustituidas deben quedar registrados en la medida necesaria para reconstruir la condición final. La reparación termina cuando el sistema está autorizado para operar, no cuando el técnico abandona el área.
El mantenimiento basado en datos no elimina el trabajo cualitativo. Una tendencia puede señalar que algo cambia, pero el técnico necesita comprender acceso, ruido, olor, vibración, historial y contexto. A la inversa, una observación de campo puede orientar una hipótesis que un sensor no captura. Integrar conocimiento de operadores, mantenedores, diseñadores y usuarios evita que el sistema digital trate el activo como una serie sin historia.
389.4. Lubricación, alineación, limpieza y ajustes#
Lubricar es controlar una interfaz#
La lubricación reduce fricción y desgaste, evacua calor, protege frente a corrosión y puede sellar o transportar partículas en un sistema diseñado para ello. No es simplemente «añadir aceite». El lubricante debe ser compatible con materiales, temperatura, carga, velocidad, ambiente, sellos y alimento o producto cercano. Una cantidad insuficiente puede aumentar contacto; una cantidad excesiva puede elevar temperatura, agitarse, fugar o degradar el componente. Mezclar productos incompatibles puede cambiar viscosidad, aditivos o estabilidad.
El plan necesita identificar punto, producto, cantidad, método, frecuencia, condición y responsable. La referencia primaria es la documentación del fabricante y la evaluación del servicio; no una cifra memorizada para toda máquina. En equipos de uso alimentario, farmacéutico o ambientalmente sensible, la contaminación por lubricante exige barreras y productos autorizados para el uso concreto. Un lubricante «mejor» en una aplicación puede ser incorrecto en otra.
El estado del lubricante puede aportar información: partículas de desgaste, agua, oxidación o cambios de viscosidad sugieren mecanismos que deben confirmarse. Un análisis no justifica cambiar el aceite sin investigar la fuente de partículas o contaminación. La limpieza del punto de aplicación es parte de la tarea; introducir suciedad mientras se intenta proteger un rodamiento puede acelerar el fallo. El almacenamiento del lubricante también importa: envases abiertos, humedad, temperatura y etiquetado afectan identidad y condición.
Alinear, ajustar y limpiar sin crear otro fallo#
La alineación relaciona ejes, acoplamientos, poleas, guías o superficies según la geometría y el régimen de trabajo. Una desalineación puede aumentar vibración, cargas y desgaste, pero forzar una posición para «hacer coincidir» marcas puede introducir esfuerzos. La alineación debe considerar temperatura, carga, expansión, base, fijaciones y tolerancias del fabricante. La medición necesita instrumentos adecuados y una referencia estable; un valor exacto en una condición distinta de la operación puede engañar.
Un ajuste modifica holgura, tensión, presión, posición, caudal, sensibilidad o contacto. El ajuste correcto depende de una función y un límite, no de que la pieza «se sienta firme». Apretar una unión puede deformar una junta; reducir una holgura puede eliminar la expansión necesaria; aumentar una tensión puede alargar la vida de una correa y reducir la de un rodamiento. Después del ajuste se comprueba la función y se observa si cambió otra variable.
Limpiar retira polvo, residuos, incrustaciones, productos de degradación o contaminantes. Puede recuperar transferencia de calor y movimiento, pero también quitar una película protectora, dañar un acabado, movilizar una sustancia o introducir agua. El método depende del material, del contaminante, del drenaje, de la compatibilidad química y del destino de los residuos. Una superficie visible no demuestra que un conducto interno, un filtro, un intercambiador o una zona oculta esté limpio.
Las tareas de lubricación, limpieza y ajuste suelen parecer rutinarias, precisamente por eso pueden ejecutarse con controles débiles. La HSE incluye entre los riesgos del mantenimiento la energía almacenada, el arranque inesperado, los materiales normalmente encerrados y la necesidad de acceso seguro; también señala que los puntos de lubricación y ajuste deben diseñarse para evitar posturas y accesos peligrosos cuando sea posible (HSE, mantenimiento de equipos de trabajo). La comodidad de la tarea es una condición de calidad y seguridad, no un lujo.
Mantenimiento y contaminación cruzada#
Un mantenimiento puede reparar una máquina y dañar el producto. Restos de paños, virutas, grasa, disolvente, agua de lavado o partículas desprendidas pueden entrar en una corriente. En un equipo que procesa alimentos, fármacos o productos sensibles, la liberación después de la intervención debe considerarse en el procedimiento de limpieza, inspección y puesta en marcha. El capítulo 386 trató higiene y control de contaminación en alimentos; aquí se añade que la mantenibilidad debe permitir limpiar, inspeccionar y verificar sin improvisación.
La decisión de limpiar, purgar, desmontar o sustituir depende del contaminante y del proceso. No se debe usar una sustancia de limpieza porque «siempre se ha usado» si cambió el material, la formulación o el destino del residuo. La identificación de equipos, herramientas y recipientes evita que una pieza limpia vuelva a un área incorrecta. La liberación del equipo requiere autoridad y evidencia, no solo una firma.
389.5. Reparabilidad, inventario de repuestos y aprendizaje de fallas#
Diseñar y comprar pensando en reparar#
La reparabilidad es la facilidad con que un activo puede inspeccionarse, aislarse, desmontarse, reparar y devolver a servicio sin daño innecesario. Incluye acceso, identificación, espacio, herramientas, puntos de izaje, documentación, modularidad, intercambiabilidad, limpieza, pruebas y seguridad. Una máquina compacta puede ahorrar espacio y multiplicar horas de desmontaje; una cubierta que protege un componente puede impedir observarlo. La accesibilidad no es un detalle posterior de mantenimiento: es una propiedad del sistema.
La modularidad puede acortar una sustitución, pero también trasladar fallas a módulos caros o difíciles de diagnosticar. La estandarización facilita repuestos y formación, aunque una pieza común mal seleccionada puede compartir un modo de falla en muchos equipos. La documentación debe incluir identificación, revisiones, límites, materiales, procedimientos y criterios de aceptación. Una ilustración sin versión o una lista de repuestos sin compatibilidad puede ser peor que no tenerla, porque transmite una falsa seguridad.
La reparación también tiene límites. Reparar no siempre conserva certificación, integridad, limpieza o desempeño original. Una modificación puede requerir una nueva evaluación de riesgo, pruebas funcionales, autorización del fabricante o aprobación regulatoria. Sustituir una pieza por otra con dimensiones iguales no prueba equivalencia de material, tratamiento, sellado, resistencia o comportamiento dinámico. La decisión debe registrar qué se restauró y qué quedó fuera de la evidencia.
Inventario: disponibilidad, coste y envejecimiento#
Un repuesto crítico debe estar disponible cuando el tiempo de reposición supera el margen aceptable de la función que protege. Pero «tener uno de cada cosa» no es una política. El inventario debe considerar criticidad, tasa y modo de falla, tiempo de entrega, obsolescencia, vida de almacenamiento, condiciones ambientales, compatibilidad, posibilidad de reparación local, intercambio entre equipos y consecuencias de una falta. Un repuesto barato puede ser crítico por su plazo; uno caro puede no justificar existencias si existe una alternativa segura y rápida.
Las existencias tienen sus propios modos de falla: pieza equivocada, número de revisión antiguo, corrosión, elastómero envejecido, batería descargada, sellado deteriorado, contaminación, pérdida de identificación o ausencia de documentación. El almacén debe preservar estado e identidad y permitir que una pieza retirada no vuelva por error al circuito. La gestión de repuestos no es solo logística: es conservar capacidad técnica.
El intercambio temporal puede ser útil para recuperar servicio, pero debe preservar trazabilidad y no dejar un segundo activo sin una barrera crítica. Las piezas canibalizadas, reparadas o de origen alternativo requieren una decisión explícita sobre inspección, compatibilidad y destino. La presión por poner en marcha un equipo puede convertir un repuesto provisional en permanente; los sistemas de trabajo deben hacer visible esa deuda.
Registrar para aprender, no para llenar casillas#
Cada orden de trabajo puede aportar datos sobre activo, función afectada, modo de falla, causa, detección, acción, tiempo fuera de servicio, recursos, repuestos, riesgos y resultado. ISO 14224 ofrece un marco para recolectar e intercambiar datos de confiabilidad y mantenimiento en industrias de petróleo, gas y petroquímica; su alcance sectorial importa, pero sus categorías muestran por qué «se cambió una pieza» es un registro demasiado pobre (ISO 14224:2016). La taxonomía debe adaptarse al contexto sin inventar precisión.
Los datos tienen calidad desigual. Una fecha de reparación puede ser exacta y la causa seguir siendo una hipótesis. Un código de falla facilita análisis, pero puede ocultar detalles si no permite texto contextual. Una base de datos grande puede medir mejor la actividad de mantenimiento que la condición de los activos. Conviene separar observación, diagnóstico, acción y efecto posterior: qué se vio, qué se creyó, qué se hizo y qué cambió después.
El aprendizaje de fallas necesita cerrar el bucle. Se revisan recurrencia, eficacia de la acción, repuestos usados, tiempo de reparación, exposición, alarmas y consecuencias secundarias. Si la falla reaparece, no se debe cerrar el caso porque la pieza reemplazada funcionó un día. Puede requerirse rediseño, cambio de procedimiento, formación, condición de operación, proveedor, inspección o inventario. Una acción correctiva debe mostrar qué evidencia la apoya y cómo se comprobará.
Aprender no significa convertir cada evento en una gran reforma. Algunas fallas son aleatorias o de baja consecuencia; otras revelan un patrón compartido. La prioridad depende de criticidad, recurrencia, detectabilidad, barreras y recursos. Compartir una lección entre equipos similares puede evitar repetición, pero una transferencia debe comprobar que el diseño, carga, ambiente y uso realmente son comparables.
Cierre y síntesis#
El mantenimiento empieza con una función y termina cuando la función se verifica en condiciones de uso. Falla funcional y degradación no son lo mismo; criticidad combina consecuencias y contexto; correctivo, preventivo y predictivo son estrategias que deben elegirse por modo de falla, no etiquetas morales. Diagnosticar exige conservar evidencia y contrastar causas; lubricar, alinear, limpiar y ajustar protegen interfaces solo cuando se conocen materiales, energía, geometría y destino del producto. Reparabilidad y repuestos convierten una intención de disponibilidad en una capacidad real.
La seguridad atraviesa todas las decisiones. Ninguna mejora de disponibilidad justifica liberar energía sin control, puentear una protección, usar un repuesto no identificado o ocultar una reparación provisional. Un programa maduro no promete que los equipos nunca fallarán. Hace visibles funciones, modos de degradación, límites, señales, tiempos, personas competentes, repuestos y consecuencias; después usa cada falla como evidencia para mejorar el sistema sin confundir una cifra de actividad con confiabilidad.
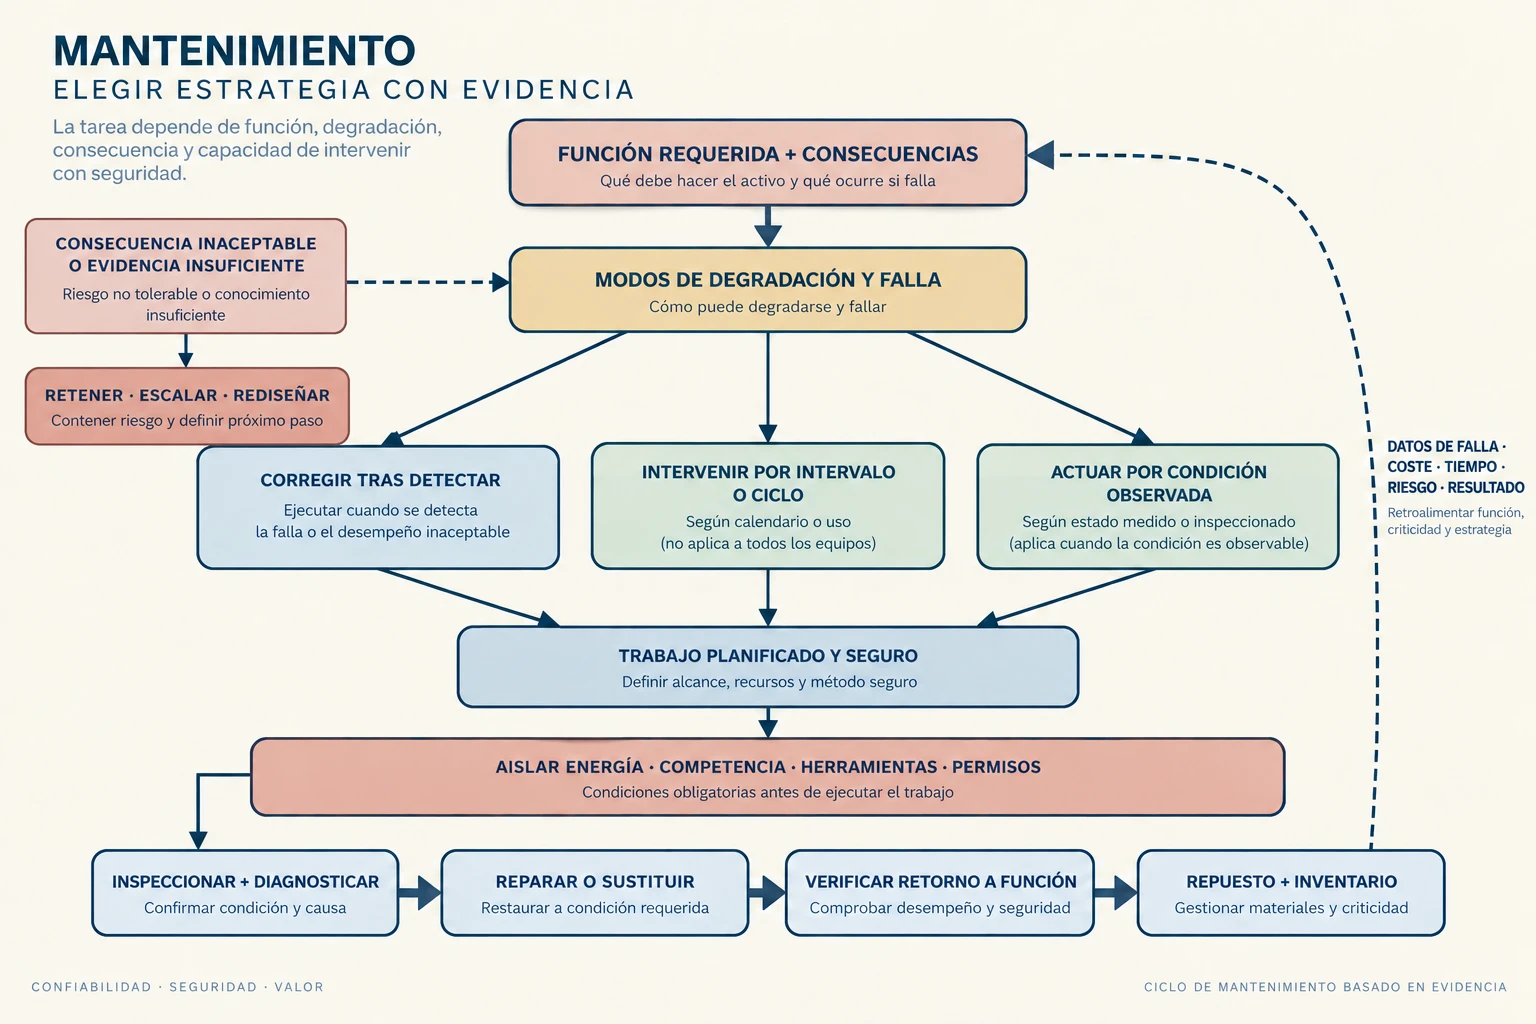
Clave de lectura. Las tres estrategias no forman una jerarquía universal. Cada una responde a un modo de falla y a una consecuencia; la seguridad y la evidencia condicionan la intervención, mientras los resultados devuelven información a la siguiente decisión.
Preguntas de transferencia#
La máquina que todavía funciona#
Ejemplo construido. Un ventilador mantiene giro, pero el caudal ha disminuido y la vibración aumenta. Producción propone esperar a que se detenga para evitar una parada. ¿Qué debería evaluarse?
Mostrar respuesta razonada
La función no es girar sino entregar el flujo requerido con seguridad. Hay que comparar la señal con una referencia, considerar carga, suciedad, desalineación, rodamientos, transmisión, sensor y consecuencias de una falla progresiva. Si el modo de falla puede dañar el equipo, liberar partes o comprometer ventilación crítica, esperar no es neutral. La decisión debe combinar diagnóstico, criticidad, margen de intervención y trabajo seguro, no solo el estado «encendido».
Cambiar piezas cada seis meses#
Ejemplo construido. Una planta reemplaza un sello cada seis meses, aunque muchos siguen intactos y algunos fallan antes. ¿Qué pregunta separa una rutina útil de un calendario arbitrario?
Mostrar respuesta razonada
Hay que comprobar si la probabilidad de falla depende realmente de la edad, qué condiciones aceleran el desgaste, si existe una señal detectable y qué consecuencia tendría esperar. Si el intervalo no se relaciona con el modo de falla, puede convenir inspección basada en condición, rediseño o una estrategia correctiva controlada. Cambiar más veces puede introducir errores y no corregir la causa de las fallas tempranas.
Lubricante correcto, punto equivocado#
Ejemplo construido. Tras una lubricación, un rodamiento se calienta y el producto presenta contaminación. El registro dice solo «lubricado». ¿Qué información falta?
Mostrar respuesta razonada
Hay que identificar componente, producto, compatibilidad, cantidad, método, condición previa, limpieza, temperatura, sellos y relación con el producto procesado. También revisar si se aplicó al punto correcto, si se mezclaron lubricantes o si la causa era desalineación o sobrecarga. La corrección no es añadir más lubricante: se aísla el equipo según el riesgo, se conserva evidencia, se verifica la condición y se investiga la contaminación y el sobrecalentamiento.
Repuesto no disponible#
Ejemplo construido. Un equipo crítico queda detenido porque el repuesto tarda meses, aunque la pieza cuesta poco. ¿Qué aprendizaje debe extraerse además de comprar más unidades?
Mostrar respuesta razonada
Hay que revisar criticidad, tiempo de reposición, obsolescencia, alternativas compatibles, reparabilidad, redundancia, condición del repuesto almacenado y posibilidad de detectar la degradación antes de la falla. Comprar stock puede ser parte de la solución, pero también pueden reducir el riesgo una modificación, un proveedor alternativo validado, una pieza reparable o una estrategia de inspección. La decisión debe dejar trazabilidad y no introducir un sustituto sin verificar función, materiales y seguridad.
Fuentes y lecturas del capítulo#
Occupational Safety and Health Administration. Control of Hazardous Energy (Lockout/Tagout). Marco oficial sobre aislamiento y control de energía durante servicio y mantenimiento. (OSHA).
Health and Safety Executive. Maintenance of work equipment. Orientación oficial sobre planificación, competencia, mantenimiento seguro, equipos críticos y protección de quienes trabajan y quienes pueden verse afectados. (HSE).
National Aeronautics and Space Administration. Reliability-Centered Maintenance Guide: For Facilities and Collateral Equipment. Guía institucional sobre selección combinada de estrategias de mantenimiento según funciones, consecuencias y condición. (NASA, RCM Guide).
U.S. Department of Energy, Federal Energy Management Program. Operations and Maintenance Best Practices: A Guide to Achieving Operational Efficiency. Orientación sobre operación, eficiencia energética, agua, planificación y mantenimiento de instalaciones. (DOE, guía de O&M).
International Organization for Standardization. ISO 14224:2016, Petroleum, petrochemical and natural gas industries — Collection and exchange of reliability and maintenance data for equipment. Marco sectorial para taxonomía y datos de fallas, mantenimiento y consecuencias; se indica su alcance para evitar generalizarlo como norma universal de toda instalación. (ISO 14224).
Occupational Safety and Health Administration. Lockout/Tagout: Control of Hazardous Energy. Folleto oficial para comprender prácticas de bloqueo, etiquetado, energía almacenada y responsabilidades de formación. (OSHA, OSHA 3120).