PARTE XXXV · Ingeniería, materiales y diseño de sistemas
401
Fiabilidad, mantenimiento y seguridad de sistemas
Cómo conservar funciones, limitar fallos y aprender sin confundir disponibilidad con seguridad
En este capítulo
Un sistema puede prestar su servicio casi siempre y, aun así, fallar de forma peligrosa cuando se le exige una protección excepcional. También puede detenerse con frecuencia, recuperarse en minutos y mantener una disponibilidad alta. En otro caso, dos equipos aparentemente redundantes pueden perderse juntos porque comparten alimentación, refrigeración o una misma instrucción equivocada. Estas situaciones no son variaciones de una sola pregunta: continuidad, recuperación y limitación del daño son propiedades relacionadas, pero no intercambiables.
La fiabilidad describe la capacidad de cumplir una función durante un tiempo y bajo unas condiciones especificadas. El mantenimiento reúne las acciones que conservan, restauran o comprueban esa capacidad. La seguridad se refiere a evitar o limitar daños intolerables, incluso cuando alguna función falla. La disponibilidad combina funcionamiento y posibilidad de recuperación: un equipo reparable puede estar disponible muchas horas aunque falle con frecuencia, mientras que un sistema muy fiable puede permanecer indisponible tras un fallo difícil de reparar.
El capítulo 389 estudió la conservación de activos concretos: función, degradación, diagnóstico, lubricación, reparación y repuestos. El capítulo 400 mostró cómo una planta coordina servicios, barreras, permisos y estados de operación. Aquí la escala es sistémica: cómo se comportan varias funciones y barreras cuando comparten dependencias, quedan temporalmente indisponibles o cambian de configuración. No se repite un manual de mantenimiento ni se ofrece un método para declarar seguro cualquier sistema; se estudian arquitectura, fallos ocultos, causas comunes, recuperación y aprendizaje. La energía aparece solo como dependencia o fuente de peligro; sus recursos y conversiones se desarrollarán en la Parte XXXVI.
401.1. Vida útil y modos de fallo#
Una función antes que una pieza#
Un sistema no «falla» en abstracto. Falla respecto de una función, un criterio y unas condiciones. Un sensor puede dejar de medir con exactitud, pero seguir entregando una señal plausible; una válvula puede no cerrar por completo, aunque todavía regule caudal; un soporte puede conservar su forma y perder capacidad frente a una carga. Antes de calcular una tasa de fallos hay que establecer qué debía hacer el sistema y cómo se detectaría la desviación.
Un modo de fallo es la manera observable en que una función se pierde o se degrada: no arrancar, abrir cuando debía cerrar, dar una lectura sesgada, perder estanqueidad, calentarse por encima del límite o degradar la comunicación. El mecanismo de fallo es el proceso físico, químico, eléctrico, lógico u organizativo que produce ese modo: desgaste, corrosión, fatiga, contaminación, sobrecarga, deriva, error de configuración o pérdida de una condición de operación. Separarlos importa porque el mismo modo puede tener causas distintas y porque una misma causa puede afectar muchas funciones.
La fiabilidad puede expresarse, de forma compacta, como
Vida de diseño y vida observada#
La vida útil no es una fecha mágica en la que todos los equipos dejan de funcionar. Es el intervalo en que una función puede prestarse dentro de límites, con un régimen de uso, inspección, mantenimiento y reemplazo especificados. La vida de diseño es una previsión basada en supuestos; la vida observada incorpora carga real, reparaciones, cambios ambientales, variación de fabricación y uso fuera de lo previsto. Confundir ambas lleva a dos errores opuestos: retirar equipos aún aptos solo por edad, o prolongar servicio porque «todavía no han fallado».
La conocida curva de bañera —fallos tempranos, una fase aproximadamente estable y un aumento por envejecimiento— puede ser una representación útil de algunas poblaciones, pero no una ley universal. Los fallos tempranos pueden deberse a defectos de fabricación, instalación o puesta en marcha; los aleatorios pueden incluir perturbaciones externas; los tardíos pueden resultar de desgaste, corrosión, fatiga o acumulación de daño. Un componente electrónico, una junta, una estructura y un procedimiento no comparten necesariamente la misma distribución. NIST señala que los modelos de vida deben vincularse al modo de fallo y a sus supuestos, no aplicarse indiscriminadamente al conjunto (NIST/SEMATECH Engineering Statistics Handbook).
La experiencia acumulada debe actualizar el modelo, no convertirse en superstición. Si una válvula rara vez falla en servicio normal pero sí después de cada desmontaje, el patrón apunta a instalación, sellado, alineación, procedimiento o formación, no necesariamente a un reemplazo más frecuente. Si la frecuencia aumenta con temperatura o vibración, conviene investigar el mecanismo y las condiciones de exposición. La ausencia de fallos puede significar que el evento es raro, que se detecta antes o que los registros son incompletos.
De la función al riesgo#
Un análisis inicial conecta función, modo de fallo, causa, efecto, detectabilidad, barreras y respuesta. En una FMEA —análisis de modos de fallo y sus efectos— se examinan componentes o funciones de abajo arriba. En un análisis de árbol de fallos se parte de un suceso superior, como pérdida de contención o de frenado, y se combinan condiciones que podrían producirlo. Ninguna técnica descubre por sí sola todos los escenarios: la FMEA puede omitir interacciones entre componentes; el árbol depende de una definición suficiente del suceso y de supuestos sobre independencia.
El resultado útil no es una puntuación que ordene automáticamente todos los peligros. Es un mapa de preguntas: ¿qué indicaría el deterioro?, ¿qué queda funcionando?, ¿qué barrera evita que el modo llegue al daño?, ¿qué ocurre si la detección también falla?, ¿qué condición hace inválido el análisis? La criticidad depende de consecuencia, probabilidad, exposición, detectabilidad, tiempo de respuesta y capacidad de recuperación. Un fallo frecuente y leve puede exigir otra estrategia que uno raro pero catastrófico.
El riesgo tampoco se reparte solo entre piezas. Una especificación ambigua, un repuesto incompatible, un turno sin acceso al historial, una alarma sin respuesta o un presupuesto que pospone inspecciones forman parte de la cadena causal. El objetivo no es convertir cada desviación en culpa individual, sino hacer visibles las condiciones que pueden convertir una degradación en pérdida de control.
401.2. Redundancia y fallos de causa común#
Dos caminos no siempre son dos barreras#
La redundancia proporciona más de un elemento, canal o procedimiento para cumplir una función. Conviene describirla en dos dimensiones distintas. Por estado de operación puede ser activa, cuando varios elementos trabajan simultáneamente, o estar en reserva, cuando uno entra tras el fallo de otro. Por semejanza de principio puede ser homogénea o diversa: esta última combina tecnologías, mecanismos o equipos humanos diferentes y puede coexistir tanto con operación activa como con reserva. Una bomba principal y otra de reserva parecen aumentar la continuidad, pero solo lo hacen si la reserva arranca, recibe servicio, tiene capacidad, se prueba y puede aislarse sin destruir la misma función que protege.
La redundancia debe analizarse como una arquitectura y no como un recuento. Importan las conexiones, los detectores, los actuadores, los suministros, la lógica de decisión, el mantenimiento, la configuración y la respuesta humana. Dos sensores pueden depender de la misma alimentación; dos servidores, del mismo armario o red; dos frenos, de la misma pieza; dos equipos de extinción, de una válvula común. Si esa dependencia falla, la aparente duplicación no añade la protección esperada.
Un elemento común puede fallar por una causa externa —inundación, temperatura, contaminación, incendio, vibración o pérdida de suministro—, por una decisión de diseño, por una instrucción o por una intervención de mantenimiento. Estos son fallos de causa común. Son especialmente importantes porque rompen el supuesto de independencia que permite multiplicar probabilidades. Si los fallos
Independencia, diversidad y separación#
La independencia se demuestra en varios planos. Hay independencia física cuando una perturbación no alcanza simultáneamente los elementos; independencia funcional cuando una misma instrucción o señal no los desactiva; independencia energética cuando no dependen de la misma fuente; independencia de mantenimiento cuando una tarea no retira todas las barreras a la vez; e independencia humana cuando la respuesta no exige que una sola persona diagnostique y actúe en condiciones incompatibles con el tiempo disponible.
La diversidad puede reducir algunos fallos sistemáticos. Un indicador mecánico y uno electrónico no comparten todos los defectos de diseño; una medición local y una inspección independiente pueden descubrir desviaciones distintas. Pero introduce interfaces, formación y procedimientos adicionales. Dos tecnologías diferentes que siguen el mismo requisito mal entendido pueden fallar de la misma manera. También es posible que una tecnología nueva tenga modos de fallo no observados. La diversidad es una estrategia, no una garantía.
La separación física no consiste solo en poner distancia: puede requerir barreras contra fuego, agua, impacto, contaminación, interferencia electromagnética o error de configuración. La separación lógica exige controlar permisos, versiones y rutas de señal. La separación de tareas requiere que una prueba, una autorización y una restitución no se reduzcan a una firma sin comprobación. El diseño debe especificar qué es independiente y cómo se verifica.
Degradación controlada#
Un sistema tolerante a fallos no mantiene todas sus prestaciones en cualquier circunstancia. Puede pasar a un estado degradado pero seguro, aislar el componente averiado, limitar velocidad o carga, avisar de la pérdida de redundancia y conservar una función mínima. Para que esa transición sea fiable debe estar definida antes del fallo: qué se detecta, qué umbral se usa, qué actuación ocurre, qué información recibe el operador y cuánto tiempo puede permanecer el estado.
La redundancia aumenta también la carga de pruebas. Una reserva que nunca se activa puede estar inservible; una prueba que conmuta toda la arquitectura puede crear el mismo peligro que pretendía descubrir. Las pruebas deben ser seguras, representativas y trazables, y deben distinguir el resultado «no falló durante la prueba» de «cumplirá la función en el escenario relevante». Cuando una barrera queda fuera de servicio, el sistema necesita compensaciones proporcionales y una autoridad clara para limitar operaciones o detenerlas.
401.3. Mantenimiento de funciones y barreras en una arquitectura#
Funciones de protección que pueden fallar en silencio#
Una función de producción suele revelar su pérdida porque el servicio se detiene o se desvía. Una función de protección puede permanecer fallada durante meses sin señal evidente: una válvula de alivio bloqueada, una reserva que no arranca, un canal de disparo inhibido o una alarma que llega a un puesto sin respuesta. El mantenimiento de sistemas debe buscar esos fallos ocultos mediante pruebas funcionales representativas, no inferir salud a partir de que nada malo ocurrió.
La prueba también crea un estado del sistema. Retirar un canal para comprobarlo puede reducir redundancia; forzar una señal puede accionar equipos no previstos; devolver un selector a la posición incorrecta puede dejar una barrera indisponible. Por eso el plan identifica qué función queda degradada durante la tarea, qué compensación existe, quién autoriza el estado y cómo se confirma la restitución. Una orden cerrada no demuestra por sí sola que la arquitectura recuperó su capacidad.
Seleccionar tareas sin duplicar el mantenimiento del activo#
Las estrategias correctiva, periódica y basada en condición se explicaron en el capítulo 389. En una arquitectura, la decisión adicional es cómo cada tarea afecta dependencias y barreras. La guía de NASA sobre mantenimiento centrado en la fiabilidad propone seleccionar acciones según función y consecuencia, en lugar de imponer una política única (NASA, Reliability-Centered Maintenance Guide). Aquí interesa sobre todo si una prueba cubre el escenario relevante, si descubre fallos ocultos y si deja simultáneamente fuera de servicio otros canales.
Una autocomprobación electrónica puede verificar lógica y no el actuador final; una prueba en vacío puede no representar la carga; una inspección local puede ignorar el suministro compartido. La cobertura debe expresarse con precisión: qué trayecto funcional se activó, qué interfaces quedaron excluidas y qué evidencia permite aceptar el resultado. Si el deterioro puede avanzar más rápido que el intervalo de observación, o la prueba introduce más riesgo que el que reduce, se reconsideran arquitectura, diversidad, detectabilidad o estado seguro.
El mantenimiento como causa común y cambio de configuración#
Una misma intervención puede inutilizar varios canales: una calibración con patrón equivocado, una actualización distribuida a todos los controladores, un lote común de repuestos o un procedimiento que ordena aislar ambas ramas. Separar equipos físicamente no protege frente a una acción común. Conviene escalonar tareas, comprobar independientemente la restitución y conservar trazabilidad de herramienta, software, repuesto, autoridad y versión.
El error durante mantenimiento puede dejar el sistema más peligroso que el fallo inicial. HSE recomienda diseñar para mantenibilidad y analizar las condiciones humanas de tareas críticas: acceso, tiempo, herramientas, información y comunicación entre turnos (HSE, Maintenance error). En sistemas redundantes importa además evitar que una sola persona, instrucción o interfaz pueda deshabilitar inadvertidamente todas las defensas.
Tras intervenir se verifica la función, se revisan las barreras y se actualiza la configuración as-maintained. Una reparación provisional necesita límites, responsable y vencimiento. Preservar evidencia del componente o registro retirado permite distinguir degradación propia, defecto repetido y error introducido por la tarea. El objetivo no es repetir la reparación del capítulo 389, sino demostrar que la intervención local no debilitó el comportamiento del conjunto.
401.4. Diseño tolerante a errores#
El error como condición esperable#
Una persona puede interpretar mal una indicación, omitir un paso, instalar una pieza semejante o reanudar una operación después de una interrupción. Un sistema seguro no supone que la formación elimina esas posibilidades. Reduce la probabilidad mediante una interfaz clara, impide consecuencias graves cuando es posible y detecta la desviación antes de que se propague. La meta no es excusar cualquier acción, sino distribuir la responsabilidad entre diseño, organización y actuación.
El diseño tolerante a errores usa barreras con funciones distintas. Una geometría puede impedir invertir una pieza; una llave de configuración puede impedir activar un modo incompatible; una comprobación independiente puede detectar una conexión errónea; un límite físico puede detener una carga; una alarma puede alertar sobre una desviación; un procedimiento puede ordenar la recuperación. La última barrera no debe ser siempre la atención de una persona, especialmente si el tiempo de respuesta es corto o el entorno es hostil.
Una barrera debe ser específica: qué peligro aborda, qué señal la activa, qué acción produce, qué fallos puede tolerar, cómo se prueba y quién responde. «Revisar con cuidado» no es una barrera verificable. Una alarma sin prioridad, sin significado o sin capacidad de ser atendida añade ruido. Un interbloqueo que se puentea con frecuencia señala un conflicto entre producción y seguridad, una mala configuración o un requisito que no se ajusta al trabajo real.
Recuperación, no solo prevención#
La tolerancia incluye detectar, aislar, recuperar y aprender. Si una medición se vuelve implausible, el sistema puede marcarla como inválida y usar una estrategia degradada; si una puerta queda abierta, puede impedir un movimiento peligroso; si una red pierde un enlace, puede conservar un estado seguro; si una persona se equivoca, una comprobación puede pedir confirmación antes de una acción irreversible. Estas respuestas dependen de supuestos y deben probarse con fallos plausibles, no solo en condiciones normales.
La recuperación también necesita que el sistema conserve información. Un registro de eventos con hora incorrecta, una alarma que se borra al reiniciar o un diagnóstico que no distingue causa de síntoma dificultan el aprendizaje. La observabilidad debe ser proporcional a la función y a la consecuencia: no se trata de registrar todo indefinidamente, sino de retener los datos necesarios para reconstruir estados, decisiones y barreras.
El diseño para el error tiene límites. Una barrera puede ser vencida por una combinación no prevista, una modificación temporal, una presión de tiempo o una causa común. Añadir capas puede aumentar complejidad, falsas alarmas y oportunidades de configuración errónea. La revisión debe comparar no solo el beneficio esperado, sino también nuevos modos de fallo, necesidades de prueba, formación, mantenimiento y dependencia de proveedores.
Personas, organización y condiciones reales#
La tolerancia no se diseña para una persona ideal. Turnos, fatiga, ruido, iluminación, acceso, temperatura, interrupciones, idioma, experiencia y coordinación afectan la posibilidad de detectar y corregir una desviación. HSE trata la fatiga, el trabajo por turnos, el diseño, los procedimientos, la cultura y el mantenimiento como factores humanos conectados con el riesgo (HSE, Human factors and ergonomics). Una instrucción que solo funciona en el escritorio del ingeniero no es robusta en la estación real.
Los procedimientos de tareas críticas deben ser utilizables: identificar el equipo correcto, mostrar el estado que se espera, separar pasos de verificación y acción, indicar criterios de parada y registrar cambios. Las listas de comprobación ayudan cuando reducen memoria y hacen visible una confirmación; se vuelven peligrosas si se marcan sin observar o si mezclan tareas que no tienen la misma condición. La persona que detecta una anomalía debe tener autoridad y apoyo para parar, aislar y escalar.
La organización puede anular un diseño cuidadoso si premia reiniciar rápido, oculta paradas o asigna mantenimiento sin recursos. La competencia se demuestra en la tarea y se conserva mediante práctica, supervisión, comunicación y aprendizaje. Contratar una empresa externa no transfiere la responsabilidad de integrar sus herramientas, formación, permisos, interfaces y hallazgos al sistema anfitrión.
401.5. Análisis de incidentes y aprendizaje#
Del suceso a la secuencia#
Un incidente es un suceso que produjo o pudo producir una pérdida de función, daño, exposición o liberación. Un casi incidente no es «nada»: es una oportunidad en la que una barrera evitó el resultado, aunque la barrera puede haber actuado por azar o quedar degradada. Analizar ambos permite estudiar la secuencia antes de que la consecuencia sea mayor. La investigación debe distinguir hechos observados, inferencias, hipótesis y decisiones.
El primer paso es preservar el estado y la información: configuración, alarmas, registros, muestras, fotografías, partes, órdenes de trabajo, permisos, conversaciones y cambios recientes. Después se reconstruye la línea temporal: qué función se esperaba, qué ocurrió, qué señales aparecieron, qué supo cada participante, qué decisiones se tomaron y qué barreras actuaron o no. Una cronología no es una causa; evita que la explicación empiece por el último gesto visible.
NIST advierte que los datos de fiabilidad deben clasificarse por modo de fallo y relacionarse con mecanismos antes de modelar o proyectar (NIST, failure mode analysis). Un registro que solo dice «bomba falló» no permite distinguir cavitación, sello, motor, alimentación, obstrucción, error de montaje o medición. La clasificación mejora el mantenimiento y evita que se agreguen eventos distintos como si fueran uno.
Causalidad sin culpable automático#
Una investigación útil pregunta por qué la acción tenía sentido en ese contexto y qué condiciones la hicieron probable. Puede descubrir una etiqueta ambigua, una alarma inhibida, un repuesto no disponible, una secuencia de permisos incompatible, presión por devolver el equipo, una modificación no registrada o una interfaz que ocultaba la pérdida de redundancia. Esto no borra la responsabilidad profesional; la sitúa junto a las decisiones de diseño, supervisión, recursos y gobernanza que hicieron posible el resultado.
Las expresiones «error humano», «falta de atención» o «no siguió el procedimiento» son puntos de partida, no explicaciones finales. Si el procedimiento no correspondía al equipo, si el procedimiento era imposible en el tiempo asignado o si la configuración real no coincidía con el documento, corregir únicamente la conducta deja intacta la condición de fallo. También hay que evitar el extremo opuesto: no toda desviación de diseño explica una decisión imprudente. La investigación debe contrastar evidencias, considerar alternativas y conservar la incertidumbre cuando no puede resolverse.
Acciones que cambian el sistema#
Una recomendación fuerte modifica la probabilidad, la detectabilidad o la consecuencia del modo de fallo y especifica cómo se comprobará. Puede rediseñar una interfaz, separar suministros, cambiar el repuesto, añadir una prueba válida, mejorar una barrera, actualizar un procedimiento, retirar una condición peligrosa o cambiar una asignación de autoridad. Repetir formación o pedir «más atención» puede ser necesario, pero rara vez basta si no cambia la exposición al error.
Cada acción necesita propietario, plazo, condición de cierre y evidencia. Cerrar una recomendación porque se publicó un documento no prueba que el trabajo cambió ni que la barrera funciona. La verificación posterior debe buscar efectos no deseados: una nueva alarma puede saturar al operador; un acceso adicional puede debilitar contención; una inspección más frecuente puede aumentar exposición; un repuesto alternativo puede introducir otra incompatibilidad.
Aprender no es acumular informes. Es cambiar decisiones y comprobar que el cambio se conserva. Los incidentes de proveedores, instalaciones vecinas o sistemas anteriores pueden aportar señales, pero la transferencia requiere comparar funciones, modos de fallo y condiciones; una lección copiada sin ese trabajo se convierte en consigna.
401.6. Diferenciar fiabilidad, seguridad y disponibilidad#
Tres preguntas, tres indicadores#
La fiabilidad pregunta: ¿con qué probabilidad cumple la función durante el intervalo y condiciones definidos? La disponibilidad pregunta: ¿qué proporción del tiempo puede cumplirla, considerando fallos y reparación? La seguridad pregunta: ¿qué probabilidad y magnitud de daño resultan de los estados del sistema, incluidos los fallos y las recuperaciones? Un mismo sistema puede puntuar bien en una dimensión y mal en otra.
Un equipo que falla con frecuencia pero se repara en minutos puede mostrar alta disponibilidad para una función no crítica y baja fiabilidad. Una barrera que rara vez se solicita puede parecer fiable porque no registra fallos, aunque nadie sabe si funcionaría cuando se necesitara; requiere pruebas y evidencia de demanda. Un sistema que permanece apagado puede ser seguro respecto de un peligro activo, pero no estar disponible para prestar su servicio. «No se ha producido un accidente» no demuestra por sí solo seguridad: puede haber ausencia de exposición, barreras eficaces, suerte o falta de datos.
Los indicadores deben conservar denominadores y contexto. Tiempo medio entre fallos, tiempo medio de reparación, disponibilidad, demandas de una función de seguridad, fallos descubiertos en prueba, retrasos de mantenimiento, alarmas falsas y casi incidentes responden a preguntas distintas. Agregarlos en una sola puntuación puede ocultar una barrera degradada. La métrica que se premia también modifica el comportamiento: perseguir disponibilidad puede incentivar puentes temporales; reducir el número de órdenes abiertas puede retrasar una inspección necesaria.
La función de seguridad no es una garantía#
Una función de seguridad actúa para prevenir un suceso peligroso o limitar sus consecuencias. Su fiabilidad incluye sensores, lógica, actuadores, alimentación, configuración, pruebas, mantenimiento y respuesta. Un equipo puede ser muy fiable para producir y poco fiable para detener; una alarma puede funcionar técnicamente y fracasar como barrera si llega tarde o nadie puede responder. La seguridad se evalúa en relación con escenarios, barreras y consecuencias, no con la disponibilidad general de la instalación.
Los estándares de seguridad funcional, como la serie IEC 61508, ofrecen un marco para gestionar funciones instrumentadas, ciclo de vida, análisis y pruebas; no convierten una arquitectura en segura sin especificación y evidencia (IEC 61508). En sistemas concretos pueden aplicar normas sectoriales y requisitos jurisdiccionales distintos. La decisión responsable declara el alcance, las hipótesis de independencia, los modos de degradación, la frecuencia de prueba y lo que queda fuera.
Cierre de la Parte XXXV#
La ingeniería de la Parte XXXV ha recorrido materiales, estructuras, máquinas, fluidos, control, electrónica, producción, biotecnología, plantas y sistemas que deben seguir funcionando en condiciones reales. Su cierre no es una lista de técnicas, sino una relación: una función depende de materiales, geometría, energía, información, personas, proveedores, mantenimiento y decisiones de seguridad. Cada capa puede conservar capacidad o abrir un modo de fallo; ninguna etiqueta resume por sí sola el comportamiento del conjunto.
La fiabilidad se construye especificando funciones, observando modos de fallo y tratando los datos con sus límites. El mantenimiento conserva o restaura funciones cuando sus tareas están vinculadas a mecanismos y consecuencias. La redundancia ayuda solo si sus elementos son suficientemente independientes y se prueban. El diseño tolerante a errores limita el daño sin imaginar usuarios perfectos. El análisis de incidentes convierte una pérdida o casi pérdida en aprendizaje cuando modifica el sistema y verifica el resultado.
Una decisión madura puede concluir que un equipo no debe seguir operando, que un intervalo no está justificado, que una reparación es provisional o que la evidencia no permite afirmar seguridad. La capacidad de detener, investigar y corregir forma parte del sistema, no un obstáculo externo a su rendimiento. La siguiente parte estudiará la energía como recurso, conversión y servicio; aquí basta conservar la pregunta que los conecta: qué funciones dependen de qué condiciones, cómo se detecta su degradación y qué responsabilidad existe antes de pedirles que sostengan la vida cotidiana.
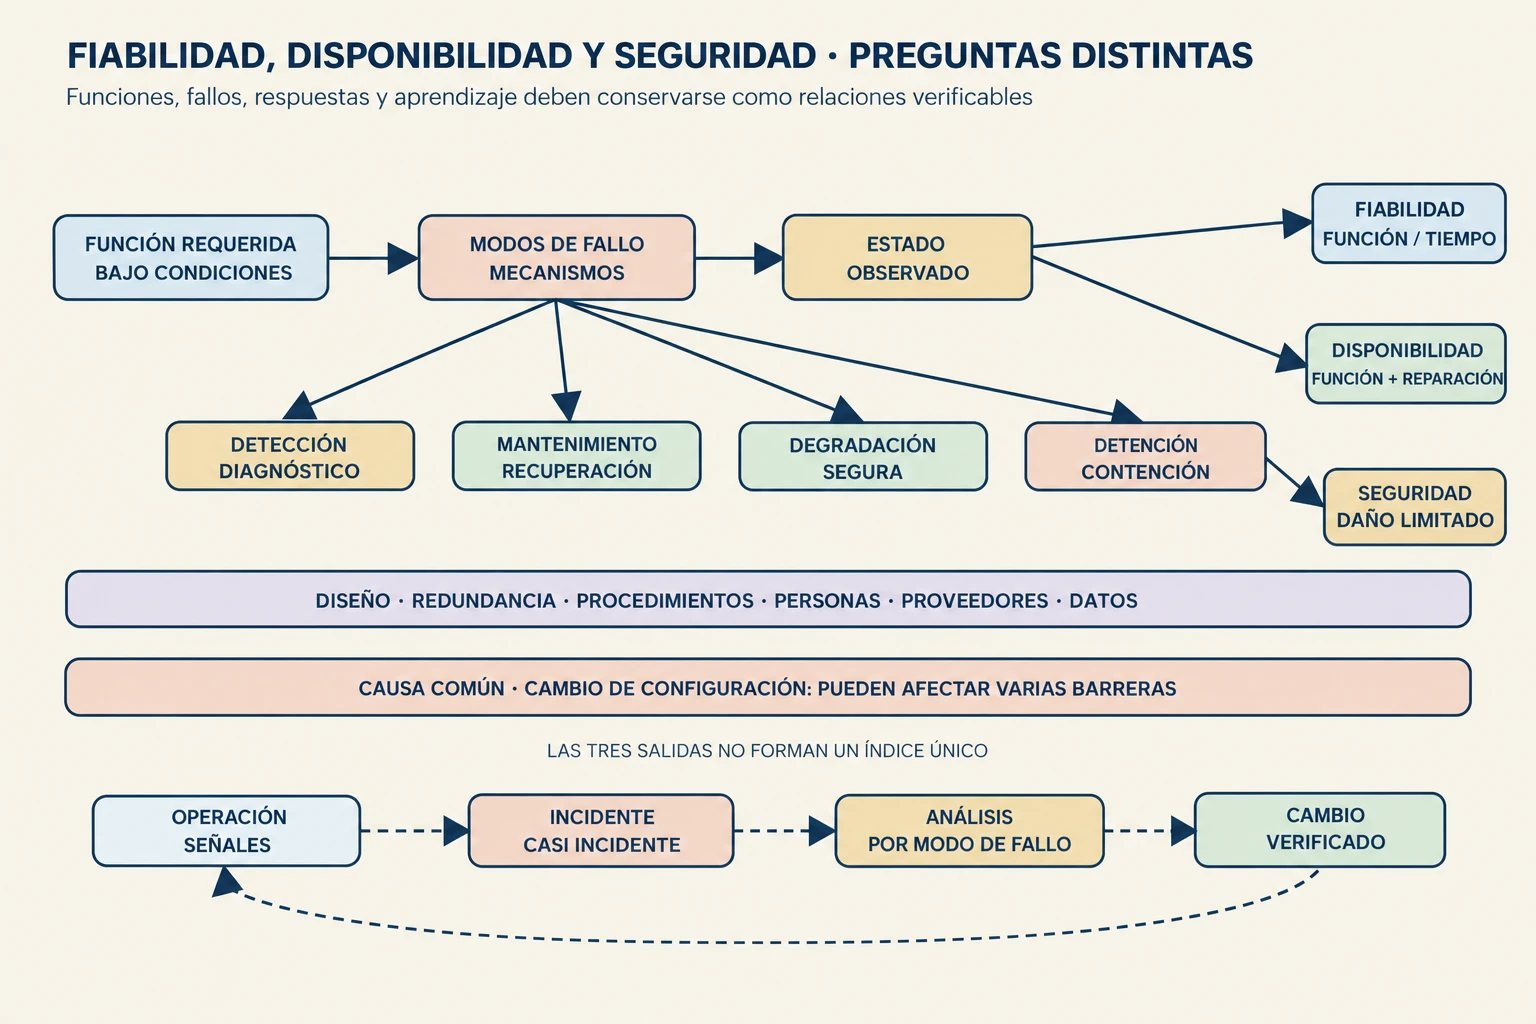
Clave de lectura. El ciclo no empieza en el mantenimiento ni termina en una cifra. Parte de una función y sus condiciones, hace visibles modos de fallo y barreras, y devuelve los incidentes y las observaciones a decisiones de diseño, operación y mantenimiento. Fiabilidad, disponibilidad y seguridad se leen por separado.
Preguntas de transferencia#
Una reserva que nunca se prueba#
Ejemplo construido. Un sistema tiene dos bombas en paralelo y la dirección afirma que la función está duplicada. ¿Qué habría que comprobar antes de aceptar esa conclusión?
Mostrar respuesta razonada
Hay que examinar si cada bomba tiene capacidad suficiente, alimentación y controles independientes, válvulas configuradas, rutas separadas, pruebas periódicas y mantenimiento compatible con la operación. También se revisan succión, descarga, sensores, lógica de conmutación y causas comunes como inundación o contaminación. Dos equipos no son dos barreras si comparten el componente que inicia, detecta o permite el fallo.
Reemplazar por calendario#
Ejemplo construido. Una organización cambia una junta cada seis meses porque una tabla antigua recomienda ese intervalo, aunque las unidades retiradas aparecen intactas y las fugas se concentran después del montaje. ¿Es más preventivo cambiarla aún más a menudo?
Mostrar respuesta razonada
No necesariamente. El patrón puede señalar un error de instalación, una especificación incompatible, una superficie dañada o un procedimiento que introduce el defecto. El intervalo debe relacionarse con el mecanismo de degradación y con la evidencia de campo. Antes de acortarlo conviene preservar juntas retiradas, revisar condiciones, comparar lotes, observar el montaje y evaluar si la intervención preventiva crea más riesgo que el envejecimiento que pretende evitar.
Una alarma que siempre funciona#
Ejemplo construido. Una alarma de alta temperatura nunca ha fallado en las pruebas, pero durante una perturbación real el equipo se dañó antes de que alguien actuara. ¿La alarma era una barrera fiable?
Mostrar respuesta razonada
La prueba demostró quizá continuidad o activación, no necesariamente tiempo de respuesta, prioridad, interpretación, disponibilidad del operador, capacidad de enfriamiento ni comportamiento ante la perturbación. Hay que reconstruir el escenario, verificar sensores, lógica, interfaz, procedimiento y margen temporal. Una alarma puede ser técnicamente funcional y no cumplir la función de seguridad si la acción requerida no es posible a tiempo.
Investigar al técnico#
Ejemplo construido. Tras una puesta en marcha incorrecta, el informe concluye que el técnico «no siguió el procedimiento». ¿Qué información falta para que el análisis sea útil?
Mostrar respuesta razonada
Hay que comprobar qué configuración encontró, qué documento estaba vigente, si las etiquetas y herramientas correspondían, qué interrupciones y presión temporal existían, cómo se verificaba cada paso, quién autorizó la restitución y qué barreras independientes quedaban. Si el procedimiento era ambiguo o imposible en la situación real, capacitar de nuevo no corrige el diseño. Si la desviación fue deliberada y sin justificación, esa responsabilidad también debe documentarse, pero no debe cerrar prematuramente la investigación sistémica.
Fuentes y lecturas del capítulo#
National Institute of Standards and Technology. NIST/SEMATECH Engineering Statistics Handbook, capítulo sobre fiabilidad y análisis por modos de fallo. Recursos para modelos de vida, clasificación de fallos y límites de los supuestos estadísticos. (NIST).
National Aeronautics and Space Administration. Reliability-Centered Maintenance Guide for Facilities and Collateral Equipment. Orientación sobre selección de tareas basadas en condición, tiempo/ciclos o funcionamiento hasta fallo, junto con mantenibilidad y coste de ciclo de vida. (NASA RCM Guide).
National Aeronautics and Space Administration. NASA-STD-8729.1A, NASA Reliability and Maintainability (R&M) Standard for Spaceflight and Support Systems. Objetivos y estrategias de fiabilidad y mantenibilidad a lo largo del ciclo de vida. (NASA Technical Standards).
Health and Safety Executive. Maintenance error. Orientación sobre diseño mantenible, análisis de error humano, procedimientos, herramientas, tiempo y comunicación en tareas de mantenimiento. (HSE).
Health and Safety Executive. Maintenance, Inspection and Testing (MIT): Overview. Marco para evaluar tanto resultados de mantenimiento como el proceso de gestión, recursos, auditoría y revisión. (HSE MIT).
International Electrotechnical Commission. IEC 61508, Functional safety of electrical/electronic/programmable electronic safety-related systems. Serie de referencia para ciclo de vida, funciones instrumentadas, análisis y pruebas de seguridad funcional; su aplicación concreta depende del sector y la jurisdicción. (IEC 61508).