PARTE XLII · Inteligencia artificial y automatización
466
Modelos de lenguaje: aprender regularidades y producir texto
Predecir continuaciones puede producir lenguaje flexible; no convierte la probabilidad de una secuencia en garantía de verdad
En este capítulo
Una frase puede continuar de muchas maneras gramaticales. Un modelo asigna probabilidades a esas continuaciones y elige una. Al repetir el proceso produce párrafos que parecen planificados, aunque cada paso se apoye en representaciones del contexto y regularidades aprendidas.
Un modelo de lenguaje estima distribuciones sobre unidades de texto. Los modelos contemporáneos pueden resumir, traducir, programar y conversar porque una tarea puede describirse dentro del contexto y resolverse como generación condicionada. Esa versatilidad no garantiza que sus afirmaciones correspondan al mundo.
La pregunta guía es: ¿cómo se transforma texto en probabilidades de continuación, y qué trabajo adicional convierte una respuesta plausible en una respuesta justificable?
466.1. Segmentación, representaciones y contexto#
El texto se divide en tokens: palabras, fragmentos, signos o bytes según el vocabulario. Un token no coincide siempre con una palabra. Idiomas y escrituras pueden requerir números distintos de tokens para expresar la misma idea, lo que afecta coste y longitud efectiva.
Cada token se convierte en un vector o embedding. La posición añade información de orden. Al atravesar capas, la representación de un token incorpora relaciones con otros tokens del contexto. No hay una entrada de diccionario fija: el vector contextual de «banco» cambia entre dinero y asiento.
La ventana de contexto limita la información disponible durante una generación. Incluir un documento no asegura que cada detalle influya; posición, extensión y distracciones afectan recuperación interna. Una ventana grande es capacidad de entrada, no memoria perfecta.
El modelo también lleva información distribuida en parámetros por el entrenamiento. Esa memoria paramétrica comprime regularidades y hechos sin conservar una base consultable exacta. No ofrece por sí sola fecha, procedencia ni mecanismo fiable de actualización puntual.
Instrucciones, ejemplos y datos comparten el contexto. El sistema necesita distinguir autoridad: contenido recuperado puede incluir frases que parecen órdenes. Mezclar datos no confiables con instrucciones sin frontera permite inyección de prompt.
466.2. Objetivos de entrenamiento y generación#
El objetivo autoregresivo predice el siguiente token a partir de los anteriores:
Entrenar reduce la sorpresa asignada al token observado en grandes colecciones. Para hacerlo bien, el modelo aprende sintaxis, estilos, asociaciones y parte de la estructura descrita en los textos. El objetivo no etiqueta por separado verdad, ironía, rumor o ficción.
Durante generación, el modelo produce puntuaciones, las convierte en probabilidades y selecciona un token. Elegir siempre el máximo puede volver el texto repetitivo; muestrear aumenta variedad y riesgo. Temperatura y filtros modifican distribución, no incorporan evidencia.
La salida elegida vuelve al contexto y condiciona el siguiente paso. Un error temprano puede construir una continuación coherente alrededor de una premisa falsa. La coherencia local ayuda a la lectura y puede ocultar el origen del desvío.
La longitud también cambia comportamiento. Una respuesta más extensa ofrece espacio para razonar o citar y más oportunidades de contradicción. Pedir «pensar paso a paso» puede mejorar ciertas tareas, pero una explicación generada no prueba que el mecanismo descrito causó la respuesta.
466.3. Atención y arquitectura de transformadores a nivel conceptual#
La atención transforma cada posición en una consulta y compara esa consulta con claves de otras posiciones. Los pesos resultantes combinan sus valores. Así, una palabra puede incorporar información de antecedentes relevantes sin recorrer secuencialmente toda la cadena.
La autoatención aplica este mecanismo dentro de la misma secuencia. En generación causal, una posición no puede usar tokens futuros. Varias cabezas calculan relaciones diferentes; después una red por posición transforma la mezcla. Conexiones residuales y normalización estabilizan capas.
El coste directo de atención completa crece aproximadamente con el cuadrado de la longitud, porque compara pares de posiciones. Variantes usan ventanas, bloques, compresión o memoria externa. Reducir coste cambia qué relaciones pueden modelarse.
La atención no es una base de hechos ni un buscador. Opera sobre el contexto ya presente. Tampoco sus pesos constituyen necesariamente una explicación causal completa: otras capas y rutas contribuyen a la salida.
Un transformador es una arquitectura diferenciable. Su capacidad emerge de parámetros, datos, objetivo y cómputo; atribuirla sólo a «atención» borra el sistema de entrenamiento.
466.4. Ajuste posterior e interacción con instrucciones#
El preentrenamiento enseña continuación general. El ajuste supervisado usa ejemplos de instrucción y respuesta para volver útil la interacción. El aprendizaje con preferencias compara salidas y modifica el modelo para favorecer respuestas valoradas.
Las preferencias son datos producidos bajo guías y contextos. Pueden mejorar ayuda y seguridad, y reflejar sesgos o desacuerdos de quienes evalúan. «Alineado» siempre significa respecto de ciertos objetivos y actores, no una propiedad moral universal.
Un mensaje de sistema, instrucciones del usuario y herramientas tienen prioridades distintas. El modelo no ejecuta autoridad por magia; el entorno debe separar canales, validar argumentos y restringir acciones. Texto generado no debe convertirse directamente en comando privilegiado.
Las herramientas amplían capacidad: calculadora, buscador, base de datos o intérprete. También introducen permisos, resultados maliciosos y errores de interfaz. El sistema debe mostrar qué acción propone, qué autoridad usa y cómo se confirma una consecuencia irreversible.
La recuperación añade pasajes al contexto. Puede actualizar información y ofrecer procedencia, pero depende de consulta, índice, permisos y selección. Si recupera una fuente irrelevante o la generación la contradice, la presencia de citas no corrige el resultado.
466.5. Fluidez, exactitud y errores de atribución#
La fluidez evalúa compatibilidad lingüística. La factualidad pregunta si afirmaciones corresponden a evidencia; la atribución, si una fuente las respalda. Son propiedades distintas. Un texto torpe puede ser correcto y uno elegante, falso.
NIST usa confabulación para salidas falsas o erróneas expresadas con confianza. No requiere intención de engañar. Surge porque completar texto plausible y verificar hechos no son el mismo objetivo.
El modelo puede inventar nombres, fechas y citas con forma verosímil. También puede mezclar entidades o atribuir a una fuente algo que no dice. Verificar sólo que el enlace existe es insuficiente: hay que localizar el pasaje y comprobar que sostiene la afirmación con el alcance indicado.
La incertidumbre verbal no está bien calibrada por defecto. «Estoy seguro» es texto generado. Pedir abstención y medir calibración puede ayudar, pero los umbrales deben probarse por dominio.
La factualidad varía con tema, idioma, fecha y formulación. Un promedio de benchmark no estima automáticamente una pregunta concreta. Materias clínicas, legales o financieras requieren fuentes actuales y revisión competente.
466.6. Diferencias entre generar una respuesta y verificar una afirmación#
Generar busca una continuación que satisfaga contexto e instrucciones. Verificar descompone la salida en afirmaciones comprobables, obtiene evidencia independiente, evalúa correspondencia y conserva incertidumbre. Son procesos distintos aunque el mismo modelo participe.
Una ruta robusta identifica qué frases son opiniones, cálculos, hechos temporales o inferencias. Luego busca fuentes apropiadas: un estándar para una especificación, un registro para una fecha, datos originales para una cifra. Una fuente secundaria puede orientar, no sustituir evidencia primaria cuando importa precisión.
La recuperación no es verificación. El buscador puede devolver contenido desactualizado; el pasaje puede hablar de otra población; la fuente puede repetir un error. La verificación necesita criterio sobre autoridad, actualidad y aplicabilidad.
Un modelo que juzga su propia salida comparte sesgos y puede preferir respuestas de estilo familiar. Evaluadores automáticos deben validarse contra personas y casos del dominio. En decisiones de alto impacto, revisión humana necesita tiempo, acceso a evidencia y poder de corregir, no sólo un botón simbólico.
La mejor respuesta puede ser abstenerse, formular una pregunta o declarar qué dato falta. Diseñar esa salida es parte de la capacidad. La incertidumbre bien comunicada conserva confianza mejor que precisión fingida.
Síntesis#
Los modelos de lenguaje convierten tokens en representaciones contextuales y predicen continuaciones. Los transformadores usan atención para mezclar información disponible, no para consultar automáticamente la realidad. El ajuste posterior orienta interacción bajo preferencias específicas. Recuperación y herramientas amplían el sistema, pero añaden interfaces y riesgos. Fluidez, factualidad y atribución deben evaluarse por separado. Verificar requiere afirmar menos, buscar evidencia adecuada y comprobar que cada fuente sostiene lo dicho.
Preguntas de transferencia#
1. Una respuesta incluye cinco enlaces reales. ¿Está verificada?#
No. Cada enlace debe sostener la afirmación asociada y ser pertinente, actual y autorizado.
2. Bajar la temperatura, ¿elimina confabulaciones?#
No. Reduce variedad; puede elegir de forma consistente la continuación falsa con mayor probabilidad.
3. Recuperar documentos internos, ¿garantiza respuestas fieles?#
No. Consulta, permisos, selección y uso del pasaje pueden fallar. Hace falta evaluar atribución.
4. ¿Por qué un modelo puede resolver un problema y explicar mal cómo lo hizo?#
Porque la explicación también es una generación. Puede ser útil sin reflejar fielmente el mecanismo causal interno.
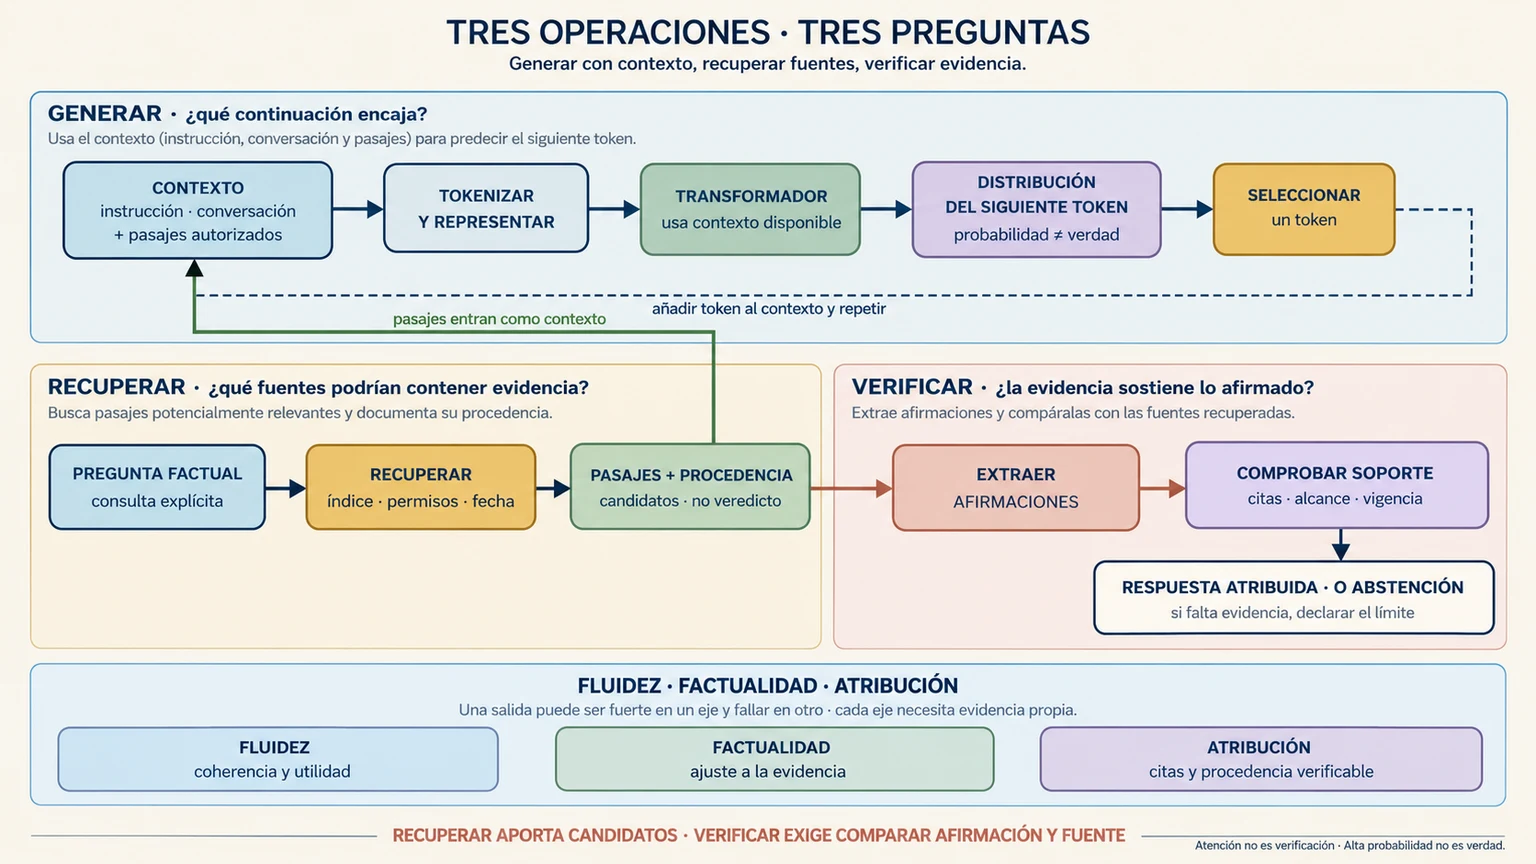
Clave de lectura. Los pasajes recuperados condicionan la generación. Sólo la comparación explícita entre afirmaciones y evidencia produce atribución evaluable.
Fuentes y lecturas del capítulo#
- Ashish Vaswani et al. Attention Is All You Need. 2017.
- Tom B. Brown et al. Language Models Are Few-Shot Learners. 2020.
- Patrick Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. 2020.
- NIST. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. 2024.
- Dor Muhlgay et al. Generating Benchmarks for Factuality Evaluation of Language Models. 2024.