PARTE XLII · Inteligencia artificial y automatización
467
IA generativa y modelos multimodales
Relacionar modalidades permite describir y sintetizar señales; no garantiza correspondencia física, autoría legítima ni verdad
En este capítulo
Una descripción puede guiar la creación de una imagen; una fotografía puede producir un texto; una voz puede transcribirse o sintetizarse. Lo común no es que todas esas señales sean iguales, sino que un sistema aprende representaciones que permiten relacionarlas.
La IA generativa modela distribuciones y produce nuevas muestras condicionadas por instrucciones u otras señales. Un sistema multimodal procesa más de una modalidad —texto, imagen, audio, video, mediciones— y construye correspondencias entre ellas.
La pregunta guía es: ¿cómo se conectan señales de naturaleza distinta, qué controla una generación y qué evidencia permite juzgar su fidelidad y procedencia?
467.1. Representar texto, imágenes, audio y otras señales#
Cada modalidad necesita una representación. El texto se segmenta; una imagen se divide en píxeles o parches; el audio se muestrea en el tiempo o se transforma en espectro. Estas decisiones conservan unas propiedades y descartan otras.
Un codificador convierte la señal en vectores. Para relacionar modalidades, el entrenamiento puede acercar representaciones de pares correspondientes —una imagen y su descripción— y separar pares no relacionados. El espacio compartido facilita búsqueda y clasificación sin que un vector sea una traducción exhaustiva.
Las correspondencias de datos son imperfectas. Un pie describe sólo una parte visible; una grabación no revela intención; un texto alternativo puede omitir fondo. El modelo aprende la relación documentada, con sus ausencias y convenciones.
Fusionar modalidades puede ocurrir temprano, combinando representaciones, o tarde, integrando decisiones. La primera permite interacción rica y aumenta coste; la segunda conserva módulos y puede perder relaciones finas.
Más modalidades no implican percepción completa. Una imagen carece de profundidad exacta, un micrófono mezcla fuentes y un sensor tiene calibración. El modelo recibe mediciones, no el mundo sin mediación.
467.2. Generación condicionada y control#
Un generador aprende a producir muestras compatibles con una distribución. En modelos autoregresivos genera unidades sucesivas. En modelos de difusión aprende a revertir gradualmente un proceso de ruido y obtiene una muestra condicionada por texto u otra señal.
La condición modifica probabilidades; no especifica cada detalle. Una instrucción como «dos manos sostienen una taza» deja abiertas posición, anatomía, luz y fondo. Escalas de guía pueden aumentar obediencia textual y reducir diversidad o naturalidad.
Semillas controlan la aleatoriedad inicial y ayudan a reproducir un resultado bajo misma versión y entorno. No identifican autoría ni garantizan igualdad entre implementaciones.
Controles espaciales, bocetos, máscaras y referencias restringen composición. Cuantas más restricciones interactúan, más fácil es que una se cumpla a costa de otra. La interfaz debe mostrar qué controla y qué queda probabilístico.
Editar una región exige coherencia con el resto. Un modelo puede alterar detalles no solicitados, texto incrustado o identidad. La comparación antes/después debe revisar toda la señal, no sólo el área indicada.
467.3. Correspondencias entre modalidades#
Describir una imagen requiere reconocer elementos, relaciones y contexto. Un modelo puede nombrar objetos y fallar en conteo, orientación o causalidad. Las relaciones espaciales pequeñas se pierden al comprimir y redimensionar.
El reconocimiento óptico de caracteres convierte patrones visuales en texto, pero tipografía, oclusión e idioma alteran precisión. Una transcripción plausible puede cambiar cifras o negaciones. Documentos críticos necesitan cotejo con la región original.
Texto y audio se conectan mediante fonemas, prosodia y contexto. La transcripción usa lenguaje para resolver sonidos ambiguos y puede sustituir nombres raros por palabras frecuentes. La síntesis reproduce timbre y ritmo sin demostrar consentimiento de la voz representada.
Video añade tiempo. Muestrear pocos fotogramas puede omitir una acción breve; razonar sobre antes y después exige conservar orden. Audio e imagen desincronizados producen interpretaciones falsas aunque cada canal parezca válido.
Una representación alineada captura asociaciones suficientes para tareas de entrenamiento. No demuestra una semántica común perfecta ni experiencia sensorial.
467.4. Procedencia, autoría y datos de entrenamiento#
La procedencia registra cómo se creó y transformó un activo. Una credencial puede vincular declaraciones firmadas a un archivo y hacer detectables ciertas alteraciones. C2PA aclara que validar esa asociación no juzga si el contenido es bueno, verdadero o legítimo.
La ausencia de credencial no prueba generación sintética: cámaras y editores antiguos pueden no emitirla, y metadatos pueden perderse. Su presencia tampoco prueba que la escena representada ocurrió; acredita una cadena declarada bajo identidades y controles concretos.
Las marcas de agua insertan señales detectables. Pueden degradarse al recortar, comprimir o transformar y producir falsos positivos. Sirven como una señal dentro de una estrategia, no como detector universal.
Los detectores de contenido sintético estiman patrones de modelos conocidos. Cambian con nuevas versiones y posprocesamiento. Una puntuación no debe convertirse en acusación sin umbral validado, procedencia y revisión.
Los datos de entrenamiento plantean derechos, consentimiento, privacidad y compensación. Un modelo no guarda necesariamente copias literales de todo, pero puede memorizar fragmentos. Evaluar requiere políticas, pruebas de extracción y mecanismos de exclusión donde correspondan.
La autoría abarca decisiones de concepto, selección, instrucciones, edición y responsabilidad. Etiquetar «hecho con IA» informa una herramienta, pero no resuelve qué contribución merece reconocimiento ni qué derechos aplican.
467.5. Evaluar calidad, fidelidad y errores#
La calidad perceptual pregunta si una muestra parece coherente; la fidelidad, si respeta la condición o fuente; la diversidad, si cubre variaciones. Optimizar una puede empeorar otra. Una imagen nítida puede contradecir el texto.
Métricas automáticas comparan embeddings, distribuciones o referencias. Son aproximaciones sensibles al conjunto y pueden premiar semejanza superficial. La evaluación humana necesita criterios, capacitación y análisis de desacuerdo.
En transformación —resumir audio, editar imagen, traducir video— hay que conservar hechos, identidades y relaciones. Las pruebas deben incluir texto pequeño, conteos, negaciones, manos, sincronía y casos fuera de distribución según el uso.
Los daños no se reducen a artefactos visuales. Una representación convincente puede suplantar, difamar, sexualizar sin consentimiento o engañar sobre evidencia. El riesgo depende de accesibilidad, audiencia, contexto y capacidad de reparación.
Un sistema desplegado incluye filtros, interfaz, registro, procedencia y políticas. Evaluar sólo el modelo omite cómo se solicita, entrega y difunde el contenido. La trazabilidad debe sobrevivir exportación y edición razonable.
Síntesis#
Los sistemas multimodales codifican señales distintas y aprenden correspondencias parciales. La generación condicionada restringe una distribución sin determinar cada detalle. Difusión, autoregresión y edición producen muestras mediante mecanismos diferentes. Procedencia verificable describe historia y asociaciones, no verdad. Marcas y detectores son señales falibles. Calidad, fidelidad, diversidad y daño requieren pruebas separadas en el sistema completo.
Preguntas de transferencia#
1. Una imagen tiene credencial válida de cámara. ¿Prueba que no fue escenificada?#
No. La credencial puede acreditar captura e historial; no demuestra la verdad de la escena.
2. El texto de una imagen coincide con el prompt. ¿La generación es fiel?#
No necesariamente. Puede fallar en relaciones, conteos o detalles no mencionados pero relevantes.
3. Un detector marca 90 % de probabilidad sintética. ¿Basta para sancionar?#
No. Requiere calibración en ese dominio, otras evidencias y un procedimiento de recurso.
4. ¿Por qué alinear imagen y texto no equivale a comprender físicamente la escena?#
Porque aprende asociaciones presentes en pares de datos; propiedades no observadas o no descritas pueden quedar fuera.
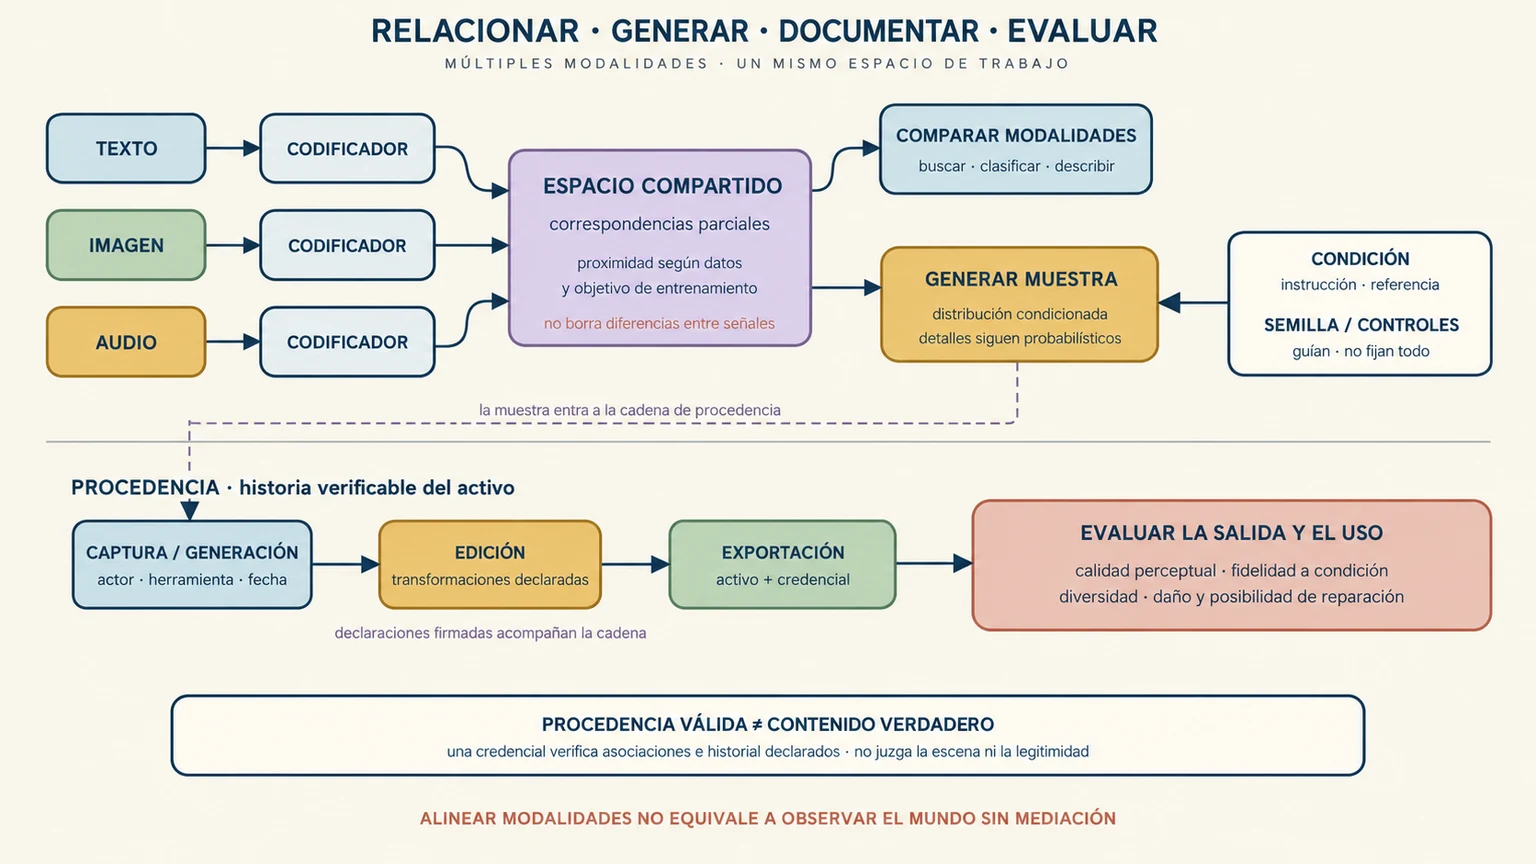
Clave de lectura. El espacio compartido conecta señales; la condición restringe la muestra; las declaraciones firmadas documentan una cadena sin certificar la verdad de la escena.
Fuentes y lecturas del capítulo#
- Alec Radford et al. Learning Transferable Visual Models From Natural Language Supervision. ICML, 2021.
- Jonathan Ho, Ajay Jain y Pieter Abbeel. Denoising Diffusion Probabilistic Models. 2020.
- NIST. Reducing Risks Posed by Synthetic Content. 2024.
- C2PA. Content Credentials Technical Specification. Versión 2.4, consulta: 7 de octubre de 2026.
- NIST. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. 2024.