PARTE XLII · Inteligencia artificial y automatización
465
Redes neuronales y aprendizaje profundo
La profundidad permite componer transformaciones y aprender representaciones; no convierte automáticamente patrones estadísticos en comprensión
En este capítulo
Un clasificador lineal sólo puede separar datos mediante una frontera simple. Si antes transforma la entrada —bordes en una imagen, combinaciones de sonidos, relaciones entre palabras— la separación puede volverse posible. Las redes profundas aprenden también esas transformaciones.
Una red neuronal artificial es una función compuesta por unidades parametrizadas. El nombre conserva una inspiración histórica, pero sus unidades no reproducen neuronas biológicas completas ni demuestran mente. El aprendizaje profundo emplea muchas capas para construir representaciones sucesivas a partir de datos.
La pregunta guía es: ¿cómo se ajustan millones de parámetros como un sistema coordinado, qué aporta la profundidad y qué no puede inferirse de una buena predicción?
465.1. Capas, parámetros y representaciones#
Una unidad recibe valores
Una capa produce un vector de activaciones que sirve de entrada a la siguiente. Las capas tempranas no contienen necesariamente conceptos legibles; codifican direcciones útiles para reducir la pérdida. En visión pueden aparecer detectores de bordes y texturas, pero esa descripción es una interpretación aproximada, no una regla universal.
La representación determina qué relaciones quedan próximas. Un embedding sitúa elementos en un espacio continuo donde ciertas regularidades pueden expresarse por distancias o direcciones. Proximidad significa semejanza según el objetivo y los datos, no igualdad de significado en todo contexto.
Profundidad permite reutilizar transformaciones y formar composiciones. Anchura aporta capacidad dentro de una capa. Más parámetros aumentan las funciones representables y también exigencias de datos, cómputo, regularización y evaluación.
La salida depende de la arquitectura. Clasificación suele normalizar puntuaciones en probabilidades relativas; regresión produce cantidades; modelos secuenciales generan distribuciones sobre el siguiente elemento. Una cifra con forma de probabilidad no está necesariamente calibrada.
465.2. Funciones de pérdida y optimización#
El paso hacia delante calcula activaciones y predicción. La pérdida compara esa predicción con el objetivo. Para saber cómo cambiar cada parámetro, la retropropagación aplica la regla de la cadena y propaga derivadas desde la pérdida hacia capas anteriores.
Si
donde
En conjuntos grandes se estima el gradiente con minibatches. La estimación introduce ruido que puede ayudar a explorar y también inestabilidad. Optimizadores adaptativos ajustan escalas por parámetro; calendarios reducen la tasa; normalización y conexiones residuales facilitan que la señal atraviese redes profundas.
Gradientes pueden desvanecerse o crecer al multiplicarse a través de capas. La inicialización, arquitectura y normalización mitigan el problema. El entrenamiento sigue siendo una búsqueda no convexa: distintas semillas pueden llegar a soluciones diferentes con desempeño parecido.
Reducir pérdida de entrenamiento no basta. Regularización, aumento de datos y parada temprana intentan favorecer soluciones que generalicen. La pérdida debe corresponder a la tarea: optimizar semejanza promedio puede borrar casos raros decisivos.
465.3. Arquitecturas y tipos de datos#
Las redes convolucionales comparten filtros a lo largo de una señal y aprovechan estructura local. Fueron especialmente eficaces en imágenes porque una característica puede aparecer en distintas posiciones. Compartir pesos reduce parámetros y expresa una simetría aproximada.
Las redes recurrentes mantienen estado al procesar secuencias. Capturan orden, pero el camino serial dificulta paralelismo y dependencias largas. Mecanismos de atención permiten que una posición combine información de otras mediante pesos calculados según el contenido.
Los transformadores organizan atención, transformaciones por posición y conexiones residuales. Se aplican a texto, visión, audio y combinaciones. Atención no equivale a explicación humana: un peso alto indica participación en un cálculo, no necesariamente causa suficiente de una decisión.
Las redes de grafos agregan información de vecinos y expresan relaciones entre entidades. Son útiles cuando enlaces importan, pero varias capas pueden mezclar tanto que nodos pierdan distinción, y el grafo observado puede omitir relaciones reales.
Una arquitectura incorpora supuestos inductivos: localidad, orden, invariancia o conectividad. Elegirla no es neutral. Cuando coincide con el problema, aprende con menos datos; cuando no, puede impedir relaciones necesarias.
465.4. Escala, cómputo y límites materiales#
El rendimiento de algunos modelos mejora de forma regular al aumentar parámetros, datos y cómputo dentro de ciertos regímenes. Una ley de escalamiento es una regularidad empírica, no una garantía ilimitada. El cuello puede desplazarse hacia calidad de datos, memoria, comunicación o evaluación.
Entrenar requiere multiplicaciones, memoria para activaciones y transferencia entre procesadores. Distribuir trabajo reduce tiempo, pero añade sincronización y fallos. Inferir también consume energía y capacidad; respuestas más largas y contextos mayores elevan coste.
El hardware especializado acelera operaciones matriciales mediante paralelismo y menor precisión numérica. Menos bits reducen memoria y energía, pero pueden degradar estabilidad. La eficiencia debe medirse por tarea útil, no sólo operaciones por segundo.
La huella material incluye fabricación de equipos, centros de datos, electricidad, refrigeración y renovación. Una mejora por consulta puede coexistir con mayor consumo total si aumenta el uso. Las cifras dependen de hardware, ubicación, carga y frontera de análisis.
Escalar también concentra recursos: datos, chips, capital y talento. Modelos abiertos pueden ampliar acceso, mientras su entrenamiento y operación siguen dependiendo de infraestructuras concentradas. La capacidad técnica y el control institucional no son la misma variable.
465.5. Interpretabilidad y evaluación de mecanismos#
Interpretar puede significar cosas distintas: explicar una predicción a una persona afectada, depurar una característica, verificar un mecanismo o describir comportamiento global. Una explicación útil para un objetivo puede ser insuficiente para otro.
Métodos de atribución estiman qué entradas influyeron en una salida. Pueden ser inestables, depender de una referencia y describir sensibilidad local sin revelar el algoritmo interno. Una visualización plausible no garantiza fidelidad.
Las sondas entrenan clasificadores sobre activaciones para comprobar si cierta información está disponible. Encontrarla no demuestra que la red la use causalmente. Intervenir —modificar activaciones y observar cambios— ofrece evidencia más fuerte, aunque una intervención artificial puede sacar al modelo de estados normales.
La interpretabilidad mecanicista intenta identificar circuitos y operaciones dentro de redes. El comportamiento puede estar distribuido entre componentes y cambiar con contexto; nombrar una unidad como «detector» suele comprimir demasiados casos.
NIST distingue que una explicación debe existir, ser significativa para su audiencia, reflejar con fidelidad el proceso y respetar límites de conocimiento. Explicar no vuelve correcto un resultado. La validación requiere comparar la explicación con el mecanismo y comprobar decisiones en el sistema real.
Síntesis#
Una red profunda compone transformaciones no lineales y aprende sus parámetros. Retropropagación calcula gradientes; optimización usa esas señales para reducir una pérdida. Arquitecturas expresan supuestos sobre localidad, secuencia o relaciones. Aumentar escala puede mejorar desempeño y eleva costes materiales y concentración. Las representaciones aprendidas no son conceptos humanos por definición, y las explicaciones deben evaluarse por propósito y fidelidad, no por apariencia convincente.
Preguntas de transferencia#
1. Una red tiene cien capas. ¿Comprende cien niveles de abstracción humana?#
No. Las capas son transformaciones sucesivas; que correspondan a conceptos interpretables debe demostrarse.
2. La pérdida baja en cada iteración. ¿El sistema mejora en producción?#
Sólo mejora ese objetivo en los datos observados. Generalización y utilidad requieren evaluación independiente.
3. Un mapa de atención resalta una palabra. ¿Es la explicación causal de la respuesta?#
No necesariamente. Muestra un componente del cálculo; deben probarse fidelidad e intervenciones.
4. ¿Más parámetros siempre producen mejor modelo?#
No. Depende de datos, cómputo, optimización, arquitectura y tarea; además importan coste y condiciones de uso.
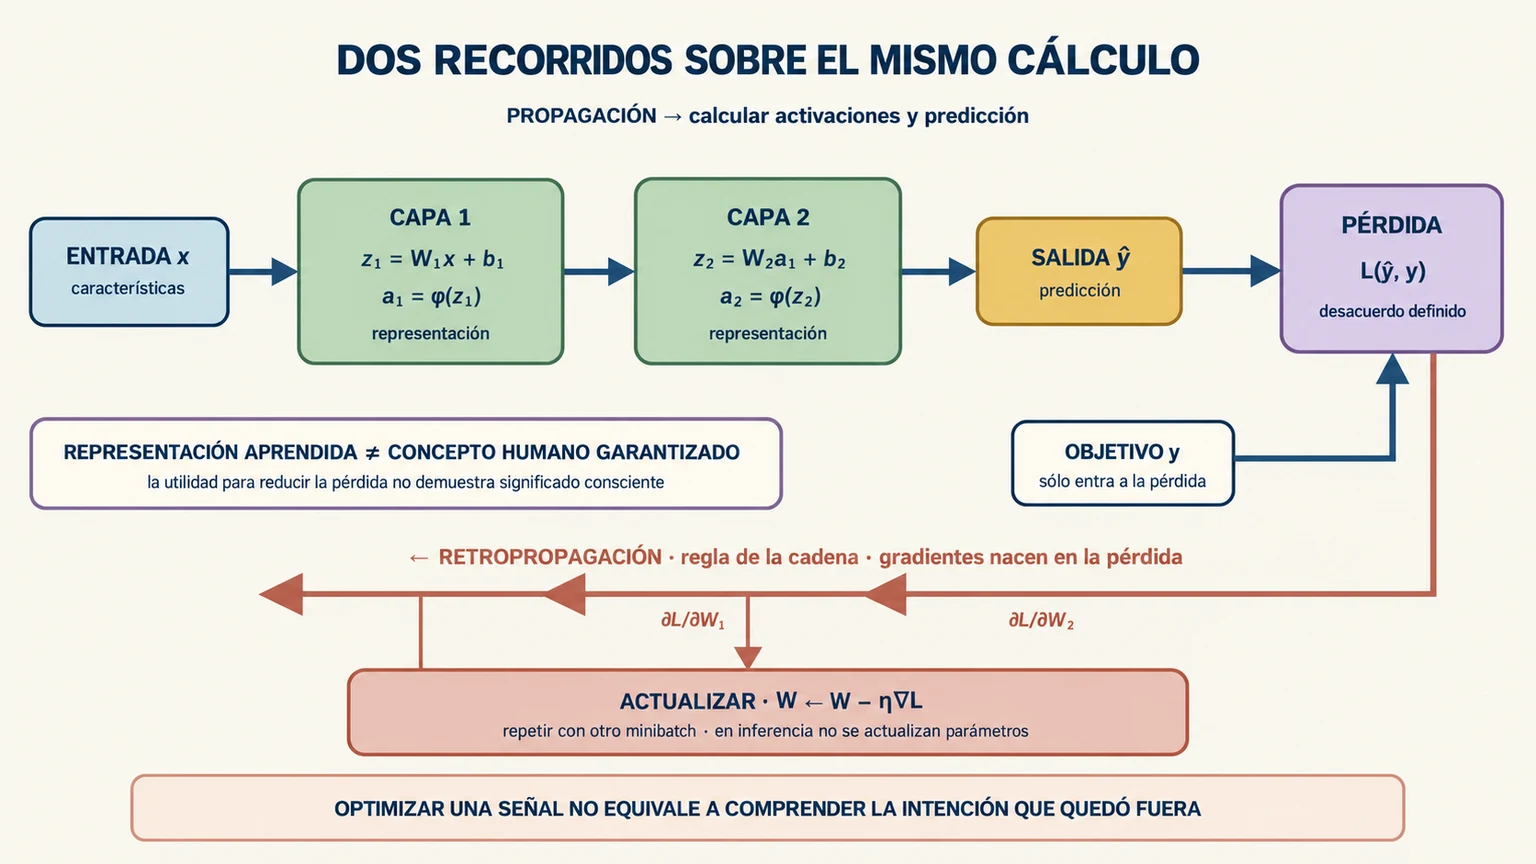
Clave de lectura. Las flechas azules calculan la salida; las terracota llevan derivadas. Durante inferencia sólo se ejecuta la propagación.
Fuentes y lecturas del capítulo#
- David E. Rumelhart, Geoffrey E. Hinton y Ronald J. Williams. Learning Representations by Back-propagating Errors. Nature, 1986.
- Ian Goodfellow, Yoshua Bengio y Aaron Courville. Deep Learning. MIT Press, 2016.
- Ashish Vaswani et al. Attention Is All You Need. 2017.
- NIST. Four Principles of Explainable Artificial Intelligence. 2021.
- Richard S. Sutton. The Bitter Lesson. 2019.