PARTE XLI · Computación, datos e Internet
457
Datos y bases de datos
Guardar datos no basta: hay que preservar qué significan, qué cambios son válidos y qué evidencia permite confiar en ellos
En este capítulo
Una tabla contiene una fila con estado = activo. ¿Activo a qué hora, según qué regla y respecto de qué entidad? Si dos operadores actualizan a la vez, ¿cuál cambio prevalece? Si una consulta responde en milisegundos, ¿la respuesta es correcta? La facilidad para guardar valores puede ocultar la dificultad de conservar significado.
Los datos son representaciones registradas de observaciones, decisiones o estados. Una base de datos organiza datos y operaciones para consultarlos y modificarlos bajo reglas. El sistema de gestión coordina almacenamiento, acceso concurrente, recuperación y control; no puede garantizar por sí solo que una medición corresponda a la realidad.
Este capítulo pregunta: ¿cómo se diseñan datos que puedan consultarse y cambiar sin perder identidad, coherencia, procedencia ni contexto?
457.1. Esquemas, registros y relaciones#
Un esquema declara estructura y significado operativo: entidades, atributos, tipos, identificadores, relaciones y restricciones. No es sólo formato. Decidir que una persona tiene una dirección única, que una medición posee unidad o que una reserva no solapa otra modela el dominio.
En el modelo relacional, una relación es un conjunto de tuplas definido por atributos. Una tabla implementa esa idea, aunque los sistemas incorporan orden físico, valores nulos y extensiones. Las filas no adquieren identidad por su posición; una clave identifica la entidad o hecho representado.
Una clave primaria debe ser única y no nula dentro de su relación. Una clave externa exige que una referencia apunte a una fila válida, salvo las excepciones declaradas. Estas restricciones impiden estados imposibles localmente, pero no prueban que el registro corresponda a una persona real ni que dos bases usen el mismo identificador.
Normalizar separa hechos para reducir duplicación y anomalías. Si la dirección de un proveedor se repite en cada pedido, corregirla exige múltiples cambios. Sin embargo, desnormalizar puede acelerar lectura o conservar una fotografía histórica. La elección debe distinguir dato actual, dato derivado y hecho válido en un momento.
El valor nulo representa ausencia de un valor definido, no necesariamente cero, vacío o falso. Puede significar desconocido, no aplicable o aún no observado; mezclar esos casos impide interpretar. En SQL, las comparaciones con nulo usan lógica de tres valores, por lo que una condición puede ser desconocida además de verdadera o falsa.
Los esquemas evolucionan. Añadir un campo es sencillo si hay un valor razonable para registros antiguos; cambiar significado bajo el mismo nombre es peligroso. Una migración necesita transformar datos, coordinar lectores y escritores, verificar invariantes y permitir recuperación.
457.2. Consultas, índices y representación#
Una consulta expresa qué resultado se desea; el motor elige cómo obtenerlo. En SQL, selección, proyección, unión, agregación y orden permiten combinar relaciones. La separación entre intención y plan hace posible optimizar sin cambiar la respuesta observable.
El planificador estima tamaños y costes para escoger orden de uniones, métodos de acceso y operaciones. Sus estimaciones dependen de estadísticas. Si la distribución cambió o atributos están correlacionados de forma no modelada, puede elegir un plan malo aunque la consulta sea lógicamente correcta.
Un índice mantiene una representación auxiliar que permite localizar valores sin recorrer todo el conjunto. Un árbol ordenado favorece rangos; una estructura hash, igualdades bajo ciertas condiciones; índices especializados sirven texto, geometría u otros dominios. El índice acelera algunas lecturas a cambio de espacio y trabajo en cada escritura.
La selectividad importa: si una condición devuelve casi todas las filas, recorrer el índice y luego la tabla puede costar más que leer secuencialmente. «Tiene índice» no implica «lo usará» ni «será rápido». El coste depende de distribución, almacenamiento, caché y consulta completa.
La representación física incluye páginas, registros, compresión y orden. El modelo lógico no obliga a una disposición única. Esta independencia permite reorganizar sin cambiar consultas, pero ciertas garantías de rendimiento dependen inevitablemente de la implementación.
Una consulta puede ser exacta respecto de los datos y aún inducir a error: contar registros duplicados, agrupar zonas con distinta población o seleccionar sólo casos observados cambia la interpretación. Validar una consulta incluye semántica del dominio, no sólo sintaxis y tiempo.
457.3. Transacciones y consistencia#
Una transacción agrupa operaciones como una unidad con reglas de finalización. Transferir saldo exige restar y sumar sin exponer un estado intermedio aceptado. Si algo falla, la transacción puede abortar y deshacer sus cambios visibles.
Las propiedades resumidas como ACID son objetivos relacionados: atomicidad, consistencia, aislamiento y durabilidad. «Consistencia» aquí significa que una transacción correcta lleva la base de un estado que satisface sus restricciones a otro; no que los datos sean verdaderos ni idénticos en todas las réplicas.
La concurrencia crea anomalías. Dos lectores pueden observar versiones diferentes; dos escrituras pueden perderse; una decisión basada en varias filas puede dejar de ser válida antes de escribir. Bloqueos, marcas temporales y control multiversión ordenan conflictos con distintas compensaciones.
Con MVCC, una transacción lee una instantánea mientras otras producen nuevas versiones. Así lectores y escritores se bloquean menos. Las versiones antiguas requieren limpieza y una instantánea coherente no necesariamente incluye el cambio más reciente ocurrido fuera de ella.
Los niveles de aislamiento permiten o impiden clases de observaciones. Un nivel más fuerte simplifica razonamiento y puede aumentar abortos o coordinación. Incluso un nivel llamado serializable garantiza equivalencia con algún orden serial de transacciones, no que el orden coincida con la intuición del usuario o con tiempo externo.
Durabilidad depende de registro, almacenamiento y política de confirmación. Confirmar puede significar que la información necesaria para recuperar alcanzó el medio exigido, no que todas las réplicas la hayan aplicado. Si se responde antes para reducir latencia, el contrato debe declarar qué pérdida es posible.
457.4. Calidad, procedencia y ciclo de vida de los datos#
La calidad es adecuación al propósito. Un conjunto puede ser completo para facturación y sesgado para estimar salud pública; preciso en ubicación y obsoleto en tiempo. Exactitud, completitud, consistencia, oportunidad, unicidad y cobertura deben relacionarse con un uso.
La procedencia registra origen, responsables, métodos, transformaciones y versiones. Permite reconstruir cómo un dato llegó a su forma actual y evaluar si puede reutilizarse. Una fecha sin zona horaria, una cifra sin unidad o un promedio sin población de referencia pierde contexto aunque el valor se conserve intacto.
Los metadatos describen nombres, tipos, unidades, condiciones de captura, restricciones y relaciones. No son decoración posterior. Si se separan del dato y evolucionan sin coordinación, una columna puede conservar valores técnicamente válidos con significado distinto.
La validación en entrada detecta formatos y rangos, pero no siempre plausibilidad. Una temperatura de 25 puede ser válida como Celsius e imposible si se interpretó como kelvin. Reglas de dominio, comparaciones cruzadas, muestras auditadas y seguimiento de sensores aportan evidencias diferentes.
El ciclo de vida incluye planear, adquirir, procesar, usar, compartir, preservar y descartar. Conservar todo indefinidamente cuesta, aumenta exposición y puede violar obligaciones. Descartar demasiado pronto elimina evidencia y reproducibilidad. La retención debe vincular propósito, ley, valor y riesgo.
Corregir datos no debería borrar su historia sin rastro. Versiones, eventos o registros de auditoría permiten distinguir valor original, corrección y autoridad. La trazabilidad tampoco legitima automáticamente el origen: documentar un proceso sesgado lo hace evaluable, no imparcial.
457.5. Modelos relacionales y otras formas de almacenamiento#
El modelo relacional destaca por su base lógica, consultas composables y restricciones declarativas. Es adecuado cuando relaciones y consistencia entre hechos importan. No obliga a almacenar físicamente cada tabla como archivo independiente ni excluye tipos complejos.
Los almacenes de documentos agrupan campos jerárquicos; clave–valor prioriza acceso por clave; grafos hacen explícitas entidades y aristas; series temporales optimizan datos ordenados por tiempo; columnas analíticas favorecen agregaciones sobre muchos registros. Son familias de modelos, no garantías automáticas de rendimiento o escala.
La misma aplicación puede necesitar más de una representación. Un registro transaccional puede alimentar un índice de búsqueda y un almacén analítico. Entonces aparecen copias con retraso, fallos parciales y diferentes autoridades. Hay que declarar cuál es la fuente de verdad para cada decisión y cómo se reconcilian derivados.
Distribuir datos entre máquinas mejora capacidad y disponibilidad potencial, pero introduce comunicación imperfecta. Particionar decide dónde vive cada clave; replicar crea copias; consenso coordina ciertas decisiones. Ninguno elimina latencia, fallos o conflictos semánticos. El capítulo 460 tratará esas compensaciones a escala distribuida.
Elegir un modelo por moda confunde herramienta y problema. Las preguntas útiles son: qué relaciones deben preservarse, qué consultas dominan, qué tasa de cambio existe, qué consistencia se necesita, qué fallos se toleran y quién operará el sistema.
La migración entre modelos rara vez es copia mecánica. Cambian identidad, restricciones, consultas y comportamiento ante concurrencia. Antes de mover datos hay que especificar equivalencias y decidir qué información no puede representarse sin pérdida.
Síntesis#
El esquema convierte valores en hechos interpretables mediante tipos, claves y restricciones. Las consultas expresan resultados y los índices cambian el coste de encontrarlos. Las transacciones delimitan cambios y el aislamiento controla qué puede observar la concurrencia. La calidad depende del propósito y la procedencia permite evaluar transformaciones. Distintos modelos favorecen relaciones y accesos distintos; multiplicarlos crea obligaciones de sincronización y autoridad.
Preguntas de transferencia#
1. Una base satisface todas sus restricciones. ¿Sus datos son verdaderos?#
No. Las restricciones prueban coherencia con reglas declaradas. La correspondencia con la realidad necesita captura, procedencia y validación externas.
2. ¿Por qué añadir un índice puede empeorar el sistema?#
Consume espacio y cada inserción o actualización debe mantenerlo. Si la consulta devuelve gran parte de la tabla, quizá ni siquiera acelere la lectura.
3. Dos transacciones confirmaron correctamente y el resultado sorprendió al usuario. ¿ACID falló?#
No necesariamente. El nivel de aislamiento puede permitir esa observación o el contrato de negocio estar incompleto. Hay que identificar la anomalía y la garantía solicitada.
4. Dos almacenes contienen el mismo identificador con valores distintos. ¿Cuál es correcto?#
No puede saberse sólo por el identificador. Hay que conocer autoridad, versión, momento, procedencia y reglas de reconciliación.
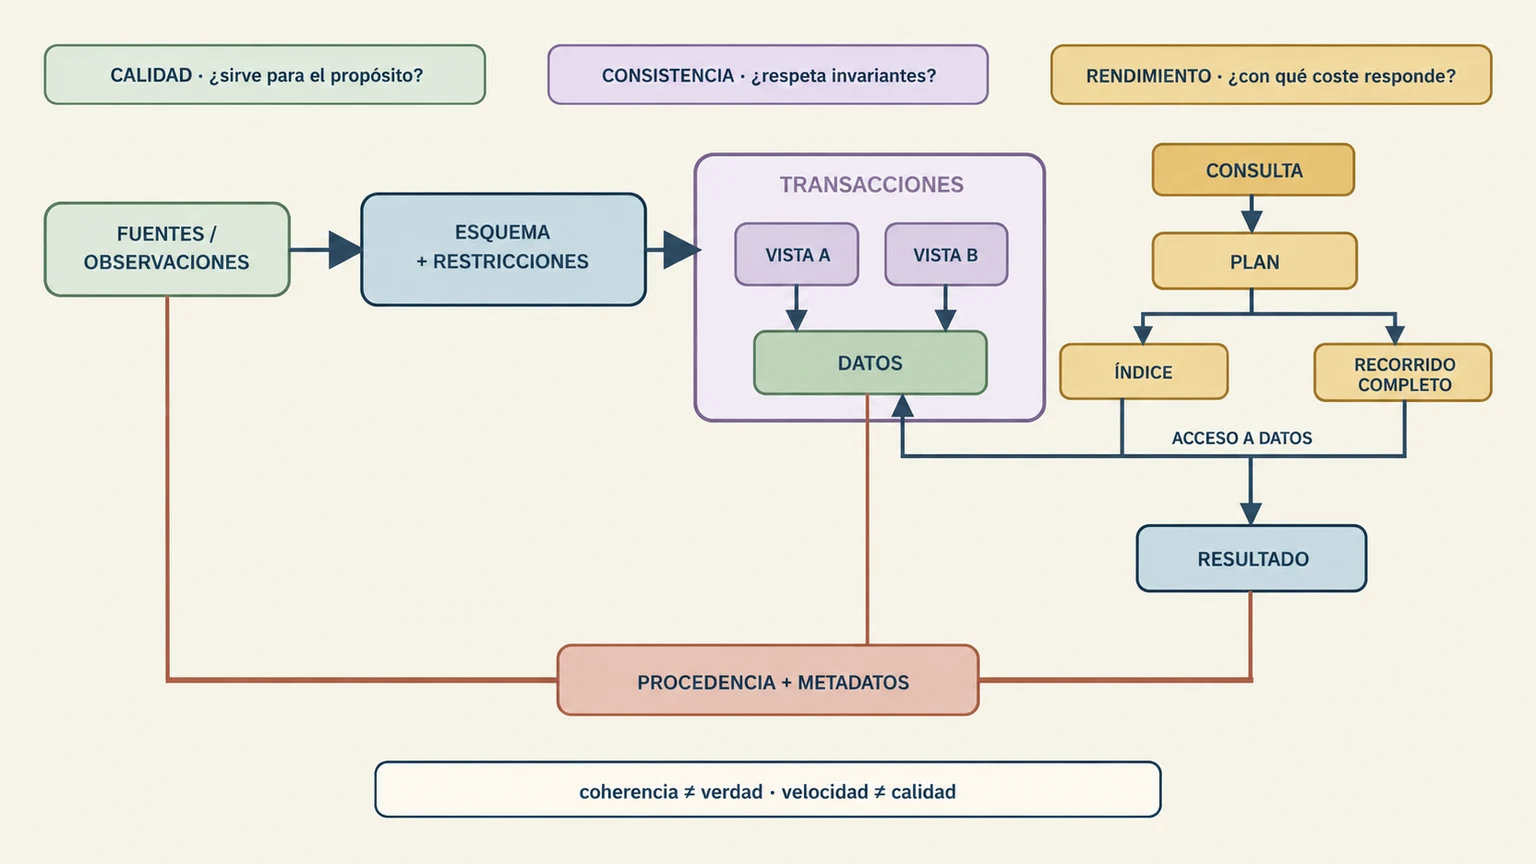
Clave de lectura. Las instantáneas A y B representan vistas coherentes que pueden corresponder a momentos lógicos distintos.
Fuentes y lecturas del capítulo#
- ISO e IEC. ISO/IEC 9075-1:2023 — Database languages SQL — Framework. 2023.
- PostgreSQL Global Development Group. Concurrency Control. Documentación oficial de PostgreSQL 18, consultada en 2026.
- PostgreSQL Global Development Group. CREATE INDEX. Documentación oficial de PostgreSQL 18.
- National Institute of Standards and Technology. NIST Research Data Framework, Version 2.0. 2024.
- World Wide Web Consortium. PROV-Overview: An Overview of the PROV Family of Documents. W3C Note, 2013.
- C. J. Date. An Introduction to Database Systems. Addison-Wesley, 8.ª edición, 2003.