PARTE XLI · Computación, datos e Internet
460
Nube y sistemas distribuidos
Distribuir recursos permite crecer y sobrevivir a ciertos fallos, pero convierte comunicación, tiempo y coordinación en parte del problema
En este capítulo
Un servicio continúa atendiendo aunque falle una máquina. Parece que la distribución eliminó el fallo; en realidad lo transformó. Una réplica puede estar viva pero incomunicada, dos copias pueden discrepar y una respuesta tardía puede llegar después de que el cliente haya reintentado. Ya no basta preguntar «¿funciona el ordenador?».
Un sistema distribuido coordina componentes que se comunican por una red y pueden fallar de forma independiente. La computación en nube ofrece por red un conjunto compartido y configurable de recursos que puede aprovisionarse y liberarse bajo demanda. La nube es un modelo operativo construido sobre centros de datos físicos, no una sustancia sin ubicación.
Este capítulo pregunta: ¿cómo se obtiene capacidad y continuidad distribuyendo cómputo y datos, y qué nuevas incertidumbres aparecen cuando ningún componente observa todo al mismo tiempo?
460.1. Centros de datos y recursos compartidos#
Un centro de datos reúne servidores, almacenamiento, redes, energía, refrigeración y operación. La infraestructura física se organiza en dominios de fallo: dispositivo, bastidor, sala, edificio, zona o región. Colocar dos copias en máquinas diferentes no protege si comparten el mismo interruptor o enlace.
La virtualización y los orquestadores convierten capacidad física en recursos lógicos: máquinas, contenedores, volúmenes, redes y servicios administrados. El usuario solicita una configuración; el proveedor decide ubicación y realiza operaciones. La abstracción acelera aprovisionamiento y oculta detalles que aún condicionan rendimiento y riesgo.
NIST caracteriza la nube mediante autoservicio bajo demanda, acceso por red, agrupación de recursos, elasticidad rápida y servicio medido. Estas propiedades describen un modelo, no una garantía automática de seguridad, bajo coste o disponibilidad.
La multitenencia comparte infraestructura entre clientes. El aislamiento reduce interferencia y acceso indebido, pero persisten recursos comunes: cachés, redes, límites de potencia y planos de control. Un vecino puede causar contención sin leer directamente los datos.
Los modelos de servicio reparten responsabilidades. En infraestructura como servicio, el cliente administra más del sistema; en plataforma o software como servicio, el proveedor asume más capas. Delegar operación no delega automáticamente definición de acceso, clasificación de datos o verificación de recuperación.
Una región cercana reduce latencia para ciertos usuarios; varias regiones aumentan tolerancia a desastres y coste de coordinación. La geografía también determina jurisdicción, energía, agua y exposición ambiental. «Global» no significa ubicuo ni uniforme.
460.2. Distribución, replicación y fallos parciales#
Particionar reparte datos o trabajo entre nodos; replicar mantiene copias. El particionado aumenta capacidad pero hace que una clave dependa de su ubicación. La replicación permite lectura cercana o reemplazo, pero introduce la obligación de ordenar cambios.
Un fallo parcial ocurre cuando sólo parte del sistema deja de responder o comunicarse. Desde otro nodo, silencio puede significar máquina caída, paquete perdido, congestión o respuesta lenta. Un tiempo límite permite dejar de esperar, no revela la causa.
Los reintentos recuperan fallos transitorios y pueden duplicar efectos. Si el servidor procesó una operación pero la respuesta se perdió, el cliente no sabe si repetir. Identificadores de operación e idempotencia permiten reconocer repeticiones; sumar un pago dos veces no se arregla sólo con TCP.
Una réplica primaria puede ordenar escrituras y enviarlas a secundarias. Si cae antes de replicar, hay que decidir qué estado aceptar. Elegir nueva primaria requiere impedir que la antigua continúe aceptando cambios aislada: dos líderes crean historias divergentes.
El consenso permite que nodos acuerden una secuencia o valor mientras se cumplen supuestos sobre participantes y comunicación. Necesita una mayoría u otro quórum apropiado; no hace que una partición desaparezca. Si no hay suficientes nodos comunicados, el progreso se detiene para proteger la decisión.
Las copias de seguridad cumplen otra función. Una réplica aplica rápidamente borrados y corrupción; una copia histórica permite volver. La recuperación exige probar restauración, dependencias y objetivos de pérdida y tiempo, no sólo contar archivos.
460.3. Consistencia, disponibilidad y latencia#
La consistencia tiene varios significados. Linealizabilidad hace que operaciones parezcan ocurrir en un orden único compatible con tiempo real. Consistencia eventual promete convergencia si cesan actualizaciones, sin fijar qué valor se observa mientras tanto. Una sesión puede exigir «leer tus propias escrituras» sin ofrecer un orden global.
La disponibilidad también debe definirse: porcentaje de solicitudes respondidas, región accesible, operación degradada o capacidad de aceptar escrituras. Responder un error rápido cuenta de forma distinta según la métrica. Un número sin ventana, población y exclusiones es ambiguo.
Durante una partición de red, réplicas que no pueden comunicarse deben decidir si continúan respondiendo. Mantener una única historia puede exigir rechazar operaciones en un lado; aceptar en ambos puede producir divergencia que habrá que resolver. Éste es el contexto del resultado CAP, no una elección permanente y simple de «dos de tres» en todo momento.
Sin partición, todavía hay compensaciones entre latencia y coordinación. Confirmar después de una réplica local es rápido y arriesga pérdida regional; esperar quórums distantes aumenta durabilidad y demora. Diferentes operaciones pueden elegir contratos distintos.
Los relojes físicos no coinciden exactamente. Marcas temporales de máquinas distintas pueden invertirse; ajustar un reloj puede saltar. Los sistemas usan relojes lógicos, límites de incertidumbre o protocolos de orden para propiedades concretas. Una fecha legible no sustituye causalidad.
La cola de espera es parte del comportamiento. Cuando la demanda se acerca a capacidad, pequeñas variaciones disparan latencia. Rechazar, limitar o degradar puede preservar el sistema mejor que aceptar trabajo infinito. La disponibilidad útil incluye estabilidad bajo sobrecarga.
460.4. Escalabilidad, costes y consumo material#
Escalar verticalmente aumenta recursos de un nodo; horizontalmente añade nodos. La segunda opción reduce ciertos límites individuales y añade partición, coordinación y balanceo. Ninguna aplicación se vuelve distribuida de forma eficiente sólo cambiando el número de instancias.
Un balanceador reparte solicitudes según salud y carga estimada. Si todas dependen de una base saturada, multiplicar frontales no ayuda. La escalabilidad exige localizar el cuello: CPU, memoria, almacenamiento, red, bloqueo, tercero o proceso humano.
La elasticidad adapta capacidad a demanda. Aprovisionar tarde produce cola; retirar demasiado pronto interrumpe trabajo; mantener margen cuesta. Eventos repentinos pueden crecer más rápido que el control. Las métricas deben anticipar y no sólo describir el agotamiento.
El cobro medido transforma capacidad en gasto variable. Reduce inversión inicial y puede ocultar costes de transferencia, almacenamiento, registros, soporte y salida de datos. Optimizar precio unitario sin medir operación y riesgo de migración produce economía aparente.
Los centros de datos consumen electricidad, agua, materiales, suelo y equipos. La eficiencia por operación puede mejorar mientras el consumo total crece por más demanda. La ubicación y la hora cambian mezcla eléctrica y refrigeración; una etiqueta genérica de nube no permite inferir impacto.
El coste ambiental debe atribuir infraestructura compartida con supuestos explícitos. Potencia instalada no es energía consumida; emisiones operativas no incluyen necesariamente fabricación; usar capacidad ociosa no vuelve marginalmente nulo todo servicio. La comparación necesita frontera y unidad funcional.
460.5. Dependencias y concentración de servicios#
Un servicio puede distribuirse en muchas máquinas y depender de un único proveedor, plano de identidad o configuración. Redundancia de instancias no equivale a diversidad de control. Una credencial revocada o una política errónea puede afectar todas las regiones simultáneamente.
Los servicios administrados aceleran desarrollo mediante interfaces propietarias y operación especializada. Cuanto más se usan sus semánticas particulares, más costosa es la salida. El lock-in no es sólo formato: incluye habilidades, automatización, contratos, volumen y dependencias organizativas.
La portabilidad necesita probarse. Tener una plantilla para otro proveedor no demuestra que datos puedan exportarse a tiempo, que el rendimiento sea equivalente ni que el equipo pueda operar allí. Una estrategia de salida nombra orden, duración, costes y período de convivencia.
Las dependencias ocultas crean fallos correlacionados. Dos proveedores pueden compartir DNS, certificados, fibra, software o subcontratista. Un mapa de arquitectura debe incluir identidad, observabilidad, despliegue y comunicación, no sólo la ruta de producción.
Los acuerdos de nivel de servicio definen compromisos y compensaciones, no eliminan daños. Un crédito económico puede ser irrelevante frente a pérdida clínica o interrupción pública. El objetivo interno debe partir de necesidades y presupuesto de error, no copiar la cifra comercial.
La concentración también afecta poder de negociación, jurisdicción y conocimiento operativo. Centralizar puede elevar eficiencia y controles; también amplía el alcance de una decisión o caída. La pregunta no es nube o no nube, sino qué capacidades se delegan, bajo qué evidencia y con qué salida.
Síntesis#
La nube ofrece recursos compartidos y elásticos sobre infraestructura física. Distribuir trabajo aumenta capacidad y tolera algunos fallos, mientras crea incertidumbre sobre comunicación, orden y duplicación. Replicación, consenso y quórums ofrecen garantías concretas, no continuidad universal. Consistencia, disponibilidad y latencia dependen del contrato y de la presencia de particiones. Escalar consume recursos materiales y económicos. Muchas copias pueden seguir compartiendo un único plano de control o proveedor.
Preguntas de transferencia#
1. Hay tres réplicas en la misma región. ¿Tolera un desastre regional?#
No. Tolera ciertos fallos de nodo, pero las tres comparten el dominio regional. La garantía depende de colocación y dependencias.
2. Un cliente agotó el tiempo y reintenta. ¿La primera operación no ocurrió?#
No se sabe. Puede haberse procesado y perderse la respuesta. Hace falta identidad de operación e idempotencia o consulta de estado.
3. Un sistema elige consistencia en CAP. ¿Siempre será lento o no disponible?#
No. La tensión específica aparece durante particiones; latencia y disponibilidad ordinarias dependen además de diseño, geografía y carga.
4. Dos proveedores alojan copias. ¿Ya no existe dependencia común?#
No necesariamente. Pueden compartir identidad, DNS, despliegue, biblioteca o enlace físico. Hay que trazar el árbol completo.
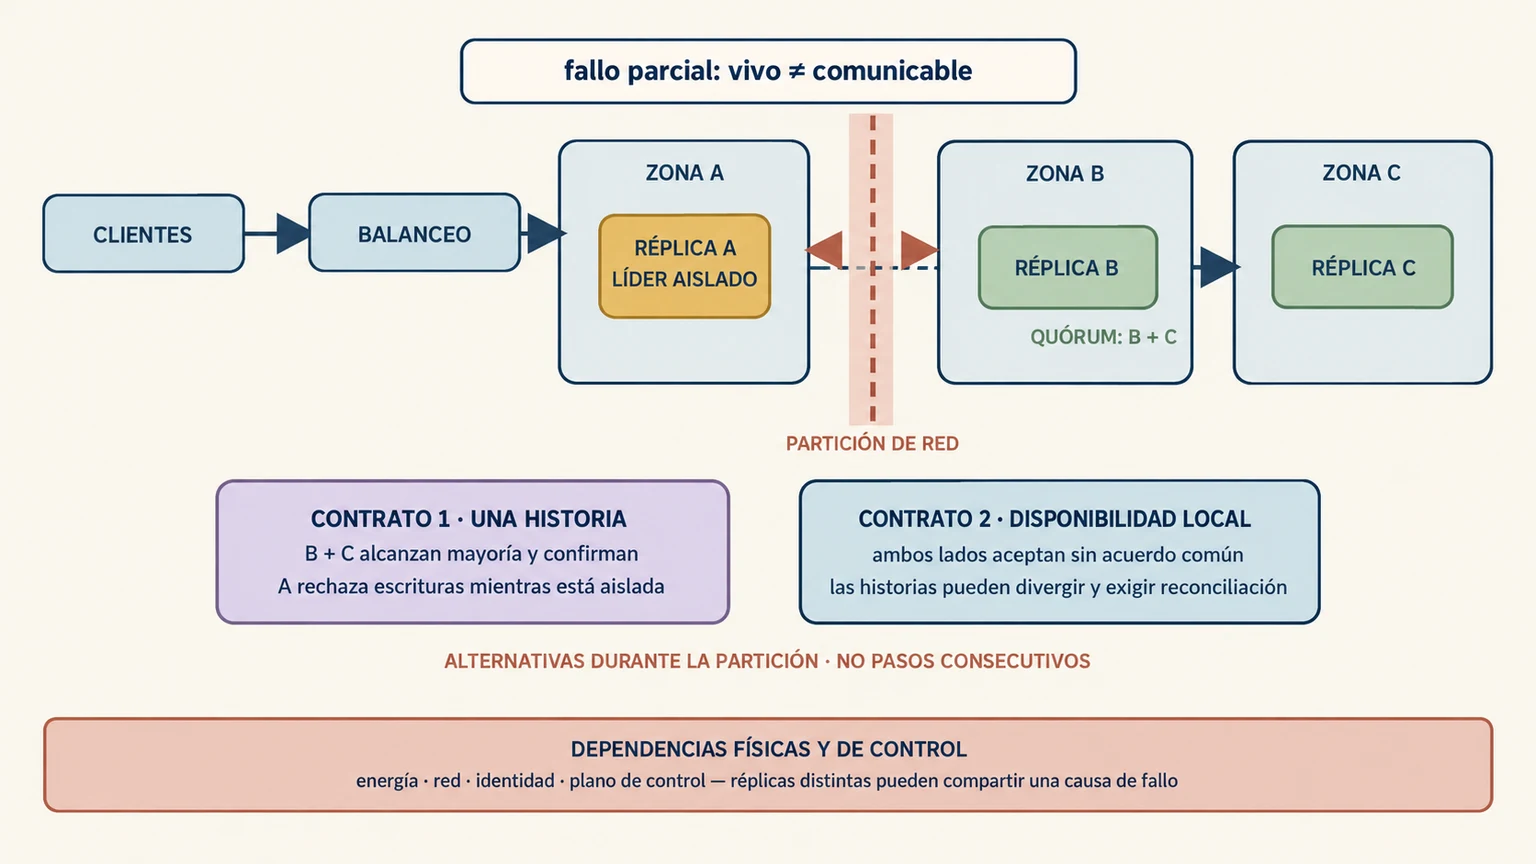
Clave de lectura. Las dos respuestas bajo la partición son alternativas de política. Un sistema concreto puede escoger contratos diferentes para operaciones diferentes.
Fuentes y lecturas del capítulo#
- Peter Mell y Timothy Grance. NIST SP 800-145: The NIST Definition of Cloud Computing. 2011.
- Seth Gilbert y Nancy Lynch. Brewer’s Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services. SIGACT News, 2002.
- James C. Corbett et al. Spanner: Google’s Globally-Distributed Database. OSDI, 2012.
- Leslie Lamport. Paxos Made Simple. ACM SIGACT News, 2001.
- International Energy Agency. Electricity 2026. IEA, 2026.
- Martin Kleppmann. Designing Data-Intensive Applications. O’Reilly, 2017.