PARTE XLII · Inteligencia artificial y automatización
468
Evaluar sistemas de inteligencia artificial
Una puntuación describe comportamiento bajo un protocolo; la confianza exige demostrar que ese protocolo representa el uso y sus consecuencias
En este capítulo
Dos modelos obtienen la misma puntuación. Uno responde con lentitud pero permite revisar; otro actúa automáticamente y falla sobre un grupo poco representado. La cifra común no describe el sistema que experimentarán las personas.
Evaluar IA es reunir evidencia sobre capacidades, límites y consecuencias bajo condiciones declaradas. Una prueba no certifica inteligencia general: muestrea comportamientos. La pregunta guía es: ¿qué debe medirse para decidir si un sistema es adecuado, para quién y bajo qué condiciones de uso?
468.1. Capacidades, tareas y condiciones de prueba#
Una capacidad debe expresarse como comportamiento observable. «Razonar» es demasiado amplio; «resolver problemas nuevos de cierta estructura y justificar pasos verificables» permite diseñar casos y criterios. El nombre de la tarea no sustituye su contrato.
El protocolo fija entradas, herramientas, tiempo, número de intentos, versión, muestreo y forma de puntuar. Cambiar el prompt, permitir búsqueda o seleccionar la mejor de varias respuestas cambia el objeto evaluado. Comparaciones válidas mantienen condiciones o reportan diferencias.
Hay que probar el modelo, la aplicación y el proceso completo. Un modelo puede clasificar bien y una interfaz inducir uso erróneo; una recuperación puede aportar evidencia incorrecta; una persona puede ignorar una alerta. El sistema es la unidad relevante cuando hay consecuencias.
Los casos deben representar dificultad y frecuencia, pero también eventos raros de alto impacto. Una muestra proporcional puede contener pocos. Se añaden pruebas dirigidas, sin confundir su tasa de fallos con prevalencia real.
Una evaluación previa al despliegue apoya una decisión provisional. El uso real genera poblaciones, incentivos y ataques no presentes en laboratorio. Por eso se definen límites, monitorización y criterios de retirada antes de lanzar.
468.2. Métricas, conjuntos de evaluación y contaminación#
Cada métrica comprime una distribución de resultados. Exactitud trata por igual errores que quizá tengan costes distintos. Precisión responde qué proporción de positivos predichos es correcta; exhaustividad, qué proporción de positivos reales se encontró. El umbral mueve esa relación.
Promedios ocultan dispersión. Se reportan intervalos, subgrupos, clases, severidad y peores casos relevantes. Comparar muchas variantes aumenta probabilidad de una mejora casual; la prueba final debe permanecer independiente.
Un benchmark facilita comparación mediante tareas estables. Puede convertirse en objetivo: equipos adaptan prompts, datos y decisiones a sus peculiaridades. La puntuación sube sin que mejore el uso externo.
Hay contaminación cuando ejemplos de evaluación, soluciones o equivalentes aparecen en entrenamiento o desarrollo. Coincidencia literal es sólo una forma; paráfrasis, repositorios y soluciones comentadas también filtran. Detectarla requiere procedencia y pruebas, no sólo buscar cadenas idénticas.
Un conjunto se vuelve obsoleto si ya no refleja tecnología o población. Evaluaciones dinámicas reducen memorización y dificultan reproducibilidad; las estáticas favorecen comparación y se desgastan. Se necesitan ambas, con versiones y fechas.
468.3. Robustez, sesgos y validez externa#
Robustez es mantener propiedades ante variaciones pertinentes: ruido, reformulación, sensor, idioma o acción adversarial. No significa ser inmutable a todo cambio. Las perturbaciones deben conservar la tarea; cambiar la respuesta correcta no prueba fragilidad.
Las pruebas adversariales buscan fallos de forma deliberada. Un equipo interno conoce diseño; evaluadores independientes aportan supuestos distintos. Hallar un caso demuestra posibilidad, no frecuencia; no hallarlo no demuestra ausencia.
El sesgo puede aparecer en datos, etiquetas, representación, umbral e interacción. Medir paridad de una métrica no garantiza igualdad de daño. Algunas métricas de equidad son incompatibles cuando prevalencias difieren; elegir requiere un objetivo normativo explícito.
La validez externa pregunta si resultados se transfieren a poblaciones y contextos no idénticos. Un modelo clínico probado en un hospital puede depender de equipos, códigos y prácticas locales. La replicación necesita describir esas condiciones.
Los efectos cambian por adopción. Usuarios se adaptan, actores explotan reglas y organizaciones redistribuyen recursos. Evaluar antes de uso no captura todos los bucles; se comparan resultados longitudinales y alternativas.
468.4. Incertidumbre, calibración y supervisión humana#
Un sistema está calibrado si, entre predicciones con probabilidad cercana a 0,8, aproximadamente 80 % resultan correctas bajo condiciones comparables. Calibración no asegura discriminación: un modelo que siempre predice prevalencia puede estar calibrado y ser poco útil.
La incertidumbre proviene de ruido, falta de datos, ambigüedad y desconocimiento fuera de distribución. Una sola puntuación puede mezclar fuentes. Abstenerse o derivar casos difíciles puede ser mejor que forzar respuesta.
La supervisión humana funciona si la persona comprende papel, dispone de información y tiempo, puede contradecir y recibe retroalimentación. Mostrar una recomendación primero puede anclar el juicio. Un humano que aprueba cientos de casos no es una barrera independiente.
Hay que medir el equipo, no sólo cada integrante: precisión conjunta, tiempo, desacuerdo, carga y capacidad de detectar errores del otro. Automatizar casos fáciles puede dejar a personas sólo casos raros y deteriorar aprendizaje.
La confianza comunicada debe corresponder a evidencia. Lenguaje seguro no es calibración. Interfaces pueden mostrar rangos, fuentes y razones de abstención, evitando falsa precisión.
468.5. Seguridad, documentación y seguimiento de cambios#
La evaluación de seguridad considera abuso, fuga de información, manipulación de entradas, uso de herramientas y acciones encadenadas. El alcance depende de capacidades y permisos; un modelo textual sin herramientas y un agente con acceso a pagos requieren pruebas distintas.
La documentación registra propósito, versiones, datos, métricas, subgrupos, limitaciones y responsables. Una tarjeta no reemplaza evidencia, pero impide que una puntuación viaje sin contexto.
Cambiar modelo, prompt, índice, política o interfaz puede alterar comportamiento. Versionar sólo pesos omite gran parte del sistema. Cada despliegue debe vincular configuración con resultados reproducibles.
Monitorizar observa entradas, salidas, incidentes y consecuencias con límites de privacidad. Las etiquetas reales pueden tardar; se usan señales intermedias sin confundirlas con resultados. Alarmas necesitan propietario y acción.
NIST organiza la gestión en gobernar, mapear, medir y gestionar. La secuencia no es lineal: nueva evidencia cambia el mapa y las decisiones. La evaluación útil termina en aceptar, limitar, rediseñar o retirar, no en publicar un número.
Síntesis#
Evaluar exige definir conducta, protocolo y contexto. Métricas y benchmarks son muestras susceptibles a contaminación y desgaste. Robustez, equidad y validez externa responden preguntas distintas. Calibración vincula confianza y frecuencia, pero no garantiza utilidad. Supervisión humana debe evaluarse como sistema de trabajo. Documentar versiones y vigilar resultados permite revisar una autorización que siempre es condicional.
Preguntas de transferencia#
1. Un modelo supera un benchmark público muy usado. ¿Generaliza mejor?#
No necesariamente. Puede existir contaminación o adaptación al benchmark. Hace falta evidencia independiente y representativa.
2. ¿Un humano en el circuito vuelve segura cualquier decisión?#
No. Debe tener competencia, tiempo, información, independencia y autoridad efectiva.
3. Un modelo está calibrado. ¿Distingue bien casos positivos y negativos?#
No necesariamente. Calibración y discriminación son propiedades diferentes.
4. ¿Por qué evaluar el sistema y no sólo el modelo?#
Porque datos, interfaz, herramientas, umbrales y organización determinan acciones y daños reales.
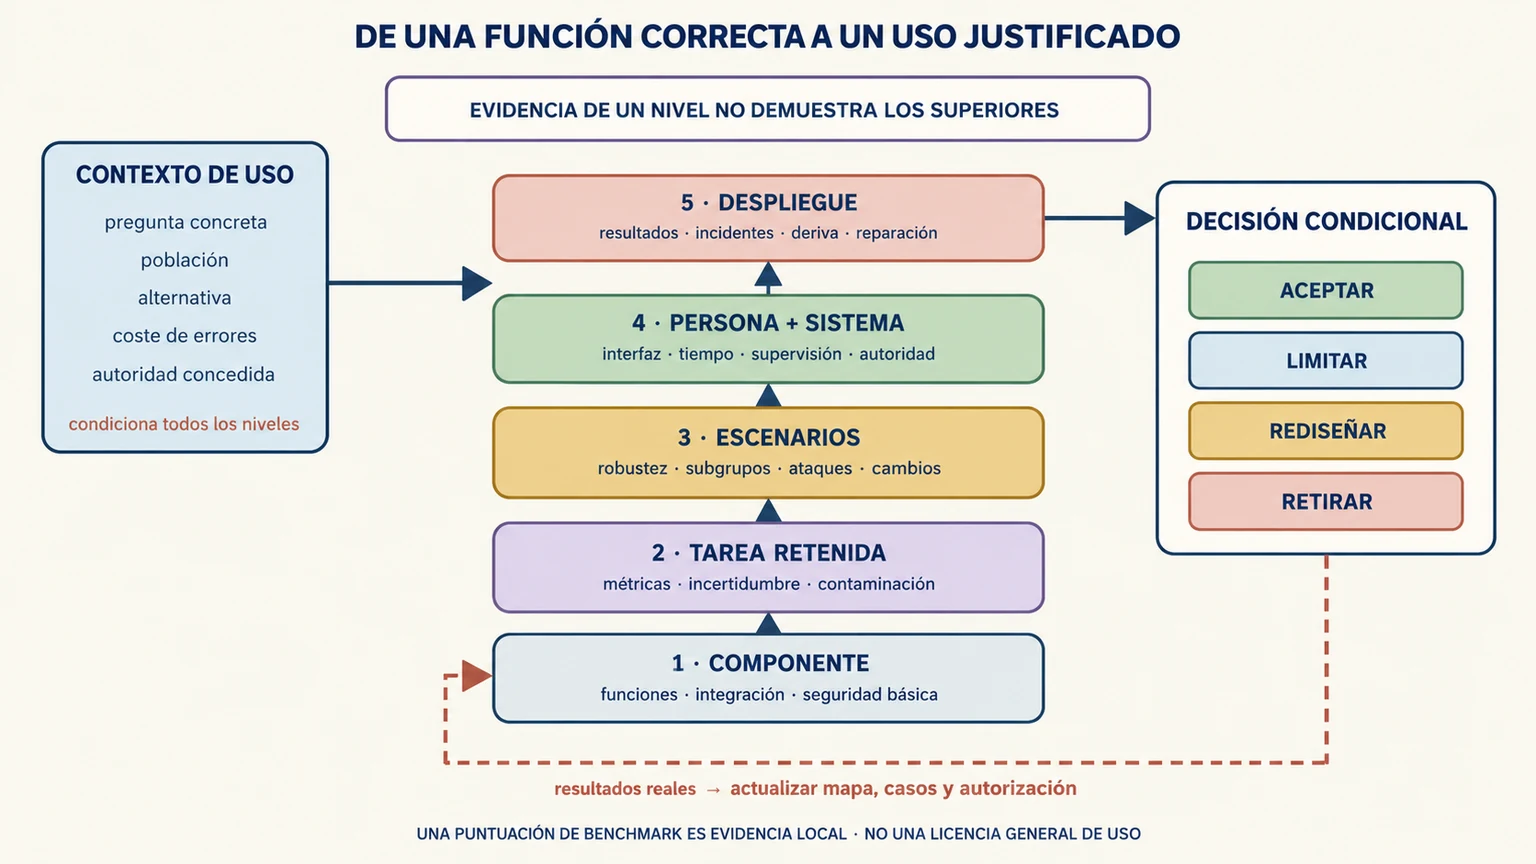
Clave de lectura. Los niveles no son una certificación automática. Una falla superior puede invalidar el uso aunque el componente puntúe bien.
Fuentes y lecturas del capítulo#
- NIST. Artificial Intelligence Risk Management Framework 1.0. 2023.
- NIST. AI Resource Center: Testing, Evaluation, Verification and Validation. Consulta: 7 de octubre de 2026.
- Margaret Mitchell et al. Model Cards for Model Reporting. 2019.
- Inioluwa Deborah Raji et al. Closing the AI Accountability Gap. 2020.
- Chuan Guo et al. On Calibration of Modern Neural Networks. ICML, 2017.
- Percy Liang et al. Holistic Evaluation of Language Models. 2022.