PARTE XLI · Computación, datos e Internet
459
La Web: qué ocurre al abrir una página
Abrir una página coordina identificación, transporte, documentos, código, estado y políticas de seguridad dentro del navegador
En este capítulo
Escribir una dirección y ver una página parece inmediato. Entre ambos actos, el navegador interpreta una URL, resuelve un nombre, establece comunicación, solicita una representación, analiza HTML, descubre recursos adicionales, aplica estilos, ejecuta código y compone píxeles. Algunas respuestas llegan de la red; otras, de una caché local.
La World Wide Web es un sistema de recursos identificados y enlazados que se intercambian principalmente mediante HTTP y se presentan mediante agentes de usuario como navegadores. Se apoya en Internet, pero no lo agota: correo, sincronización horaria y muchos servicios de red pueden funcionar sin ser Web.
Este capítulo pregunta: ¿qué contratos y estados convierten una dirección en una experiencia interactiva, y dónde pueden diferir lo mostrado, lo solicitado y lo que realmente ocurrió?
459.1. Direcciones, nombres y solicitudes#
Una URL identifica cómo acceder a un recurso. En https://ejemplo.org/ruta?tema=redes#seccion, el esquema es https, el anfitrión ejemplo.org, la ruta /ruta, la consulta tema=redes y el fragmento seccion. No todos los componentes se envían del mismo modo: el fragmento suele interpretarse en el cliente y no forma parte de la solicitud HTTP.
El anfitrión se resuelve mediante DNS a una o más direcciones. Luego el cliente establece transporte y, para HTTPS, negocia una protección criptográfica y comprueba la identidad presentada para el nombre. DNS, conexión y HTTP son pasos relacionados pero distintos; cada uno puede fallar por separado.
Una URL no es una ruta de archivo local ni garantiza contenido estable. Identifica un recurso dentro de un espacio administrado por una autoridad. La representación obtenida puede variar con tiempo, idioma, permisos, negociación de contenido o estado del servidor.
El origen combina esquema, anfitrión y puerto. Los navegadores lo usan como frontera de seguridad: documentos de orígenes distintos no reciben acceso mutuo irrestricto. Dos rutas del mismo origen comparten esa autoridad básica; http y https son orígenes diferentes.
Antes de enviar, el navegador puede consultar cachés, reglas de redirección, políticas de seguridad y trabajadores de servicio. Una navegación visible no siempre provoca una nueva transferencia completa. Herramientas de diagnóstico deben distinguir intención del usuario y solicitudes efectivas.
La URL puede incluir datos sensibles en la consulta, que terminan en historiales, registros o referencias. La identificación del recurso y la autorización del usuario deben mantenerse separadas: conocer una dirección no debería otorgar por sí solo capacidades no destinadas a compartirse.
459.2. HTTP, documentos y recursos#
HTTP es un protocolo de aplicación basado en solicitudes y respuestas. Una solicitud declara método, objetivo, campos y quizá contenido. La respuesta incluye estado, campos y posiblemente una representación. El protocolo define semántica común a sus versiones aunque la codificación sobre la conexión cambie.
Un recurso no es igual a los bytes transferidos. Es aquello identificado por la URL; una representación describe su estado en un formato comunicable. El mismo recurso puede ofrecer HTML, JSON o imagen según negociación y contexto.
Los métodos expresan intención. GET solicita una representación y se define como seguro respecto de cambios solicitados; POST entrega contenido para que el servidor lo procese; PUT y DELETE tienen otras semánticas. Un servidor puede estar mal implementado, pero los intermediarios y clientes toman decisiones según el contrato declarado.
Los códigos de estado resumen el resultado: éxito, redirección, error del cliente o del servidor. 404 significa que el servidor no encontró una representación del objetivo, no que DNS o la red fallaron. 500 no prueba cuál componente interno falló.
Una página HTML suele referir recursos: hojas de estilo, imágenes, fuentes, módulos y datos. Cada referencia puede originar otra solicitud, quizá a otro origen. La «página» visible es una composición de respuestas y estado, no un único archivo obligatorio.
HTTPS protege el intercambio frente a observación y modificación en el trayecto bajo sus supuestos; no certifica que la información sea verdadera ni que el servidor esté libre de abuso. También quedan metadatos observables según protocolo y entorno. La criptografía se desarrollará en el capítulo 461.
459.3. Navegadores, HTML y representación#
El navegador es cliente HTTP, intérprete de formatos, entorno de ejecución y límite de seguridad. Tras recibir HTML, lo analiza conforme a reglas precisas y construye un árbol de documento. HTML tolera ciertos errores de autor mediante recuperación estandarizada; no se interpreta simplemente «línea por línea».
HTML describe estructura y significado: encabezado, enlace, formulario, tabla, imagen. CSS selecciona elementos y calcula presentación. El navegador combina documento, reglas del autor, preferencias del usuario y valores predeterminados para obtener estilos.
Después calcula geometría, dibuja y compone capas. Un cambio puede repetir sólo parte del trabajo o provocar nueva disposición. Lo que aparece en pantalla depende también de fuentes, tamaño, capacidades, accesibilidad y momento de carga; no existe una captura universal idéntica.
JavaScript puede modificar el documento, solicitar datos y responder a eventos. La ejecución comparte un hilo principal en muchos contextos con tareas de interacción y representación, aunque existan trabajadores y procesos auxiliares. Un cálculo largo puede volver la interfaz inerte sin que la red esté caída.
El navegador aplica políticas: origen, permisos, aislamiento de procesos, tipos de contenido y restricciones a mezclas inseguras. Estas defensas reducen interacción indebida entre sitios; no corrigen una aplicación que autoriza mal en el servidor.
La accesibilidad depende de semántica, orden, nombres y alternativas, no sólo de aspecto. Un botón dibujado como rectángulo puede ser invisible para tecnología asistiva si no expone función y estado. La representación visual es una salida entre varias.
459.4. Contenido estático y aplicaciones#
Un sitio estático sirve representaciones construidas antes de cada solicitud o almacenadas como archivos. Puede incluir navegación y código en el cliente; «estático» describe cómo se produce o entrega el contenido, no que sea visualmente inmóvil.
Una aplicación generada en servidor produce HTML a partir de datos y contexto. Una aplicación de cliente puede recibir un documento inicial y construir vistas mediante código y solicitudes adicionales. Los enfoques se combinan: prerenderizado, hidratación, navegación parcial y componentes de servidor.
La decisión afecta tiempo de primera lectura, accesibilidad, indexación, caché, complejidad y operación. Enviar una aplicación grande para una página principalmente textual desplaza coste al dispositivo; generar cada respuesta en servidor añade cómputo y dependencias.
Una API web expone operaciones y representaciones para otros programas. No tiene que ser visible como página ni usar JSON obligatoriamente. Su contrato incluye esquema, autenticación, errores, límites y evolución.
El navegador no es autoridad sobre reglas de negocio. Validar un formulario en cliente mejora experiencia, pero el servidor debe volver a validar porque un solicitante puede omitir la interfaz. Ocultar un botón no revoca permiso.
Las plataformas agregan identidad, alojamiento, distribución, pagos o descubrimiento. Reducen fricción y concentran decisiones sobre acceso, datos y compatibilidad. Un sitio puede parecer independiente y depender operativamente de numerosos servicios externos.
459.5. Cachés, sesiones y datos del usuario#
Una caché reutiliza una respuesta para evitar transferencia o generación. Puede vivir en navegador, intermediario o servidor. HTTP define frescura, validadores y directivas para decidir cuándo reutilizar o revalidar. «Recargar» puede conservar partes según la acción y política.
Una respuesta desactualizada no siempre es error: puede aceptarse para disponibilidad o rendimiento. En datos críticos, la política debe limitar antigüedad. Invalidar es difícil porque existen múltiples copias y claves; cambiar contenido sin cambiar identificador puede dejar versiones incompatibles.
HTTP es semánticamente sin estado: cada solicitud puede entenderse por sí misma. Las aplicaciones crean sesiones mediante identificadores, tokens o parámetros que relacionan solicitudes. La conexión de transporte no debe confundirse con la identidad del usuario.
Una cookie es un par nombre–valor y metadatos que el servidor entrega al agente; éste decide en qué solicitudes posteriores incluirla según dominio, ruta, esquema y otros atributos. Puede mantener sesión, preferencias o seguimiento. No es necesariamente la sesión completa: a menudo contiene sólo un identificador.
El almacenamiento local, cachés, historial y trabajadores de servicio conservan otros estados. Borrar cookies no elimina necesariamente todas las copias; cerrar una pestaña no siempre termina una sesión remota. El ciclo de vida debe declararse.
Los datos del usuario pueden viajar a terceros mediante recursos incrustados, solicitudes o identificadores. Consentimiento visible no vuelve necesaria toda recopilación. Minimización, propósito, retención y control siguen siendo preguntas de diseño, tratadas con más amplitud en el capítulo 463.
459.6. Diferencias entre Internet, Web y servicios digitales#
Internet aporta interconexión y protocolos de red. La Web aporta URLs, HTTP, documentos enlazados y agentes de usuario. Un servicio digital es una función ofrecida mediante sistemas informáticos; puede usar Web, aplicaciones nativas, correo, telefonía o redes privadas.
Una aplicación móvil puede mostrar contenido sin ser un navegador y comunicarse por HTTP. Un servidor web puede estar en una red privada sin acceso público. Una página guardada puede abrirse sin Internet. Estos casos separan categorías que en el uso cotidiano se mezclan.
El «sitio» tampoco coincide necesariamente con un servidor. Un dominio puede distribuirse entre centros de datos, cachés y proveedores; un servidor puede alojar miles de dominios. La URL expresa autoridad lógica, no ubicación física única.
La Web abierta permite enlazar recursos sin acuerdo previo con cada autor y usar estándares implementables por múltiples agentes. Las plataformas cerradas pueden usar tecnologías web mientras restringen identidad, distribución o interoperabilidad. Usar HTML no garantiza apertura institucional.
Una caída puede localizarse por capa: DNS no resuelve, la ruta falla, TLS rechaza identidad, HTTP devuelve error, el documento carga pero una API no responde, o el navegador bloquea una política. Decir «Internet no funciona» borra evidencia útil.
Comprender las capas también ubica responsabilidad. El proveedor de red no controla el código de la página; el navegador no determina la verdad del contenido; el servidor no puede asumir que el cliente ejecutó su interfaz. Cada contrato tiene alcance.
Síntesis#
La URL identifica un recurso y establece un origen; DNS resuelve el nombre y HTTP intercambia solicitudes y representaciones. El navegador analiza HTML, aplica CSS, ejecuta código y compone una salida bajo políticas de seguridad. Una página puede ser estática o una aplicación distribuida. Cachés reutilizan respuestas y las sesiones añaden continuidad sobre HTTP sin estado. Internet, Web y servicio digital se superponen, pero no son equivalentes.
Preguntas de transferencia#
1. La barra muestra HTTPS. ¿El contenido es verdadero?#
No. Indica una conexión protegida y una identidad autenticada para el nombre bajo el sistema de confianza; no valida las afirmaciones publicadas.
2. Una página se ve igual después de desconectar la red. ¿Qué pudo ocurrir?#
El navegador pudo usar caché, un trabajador de servicio o contenido ya cargado. Eso no prueba que el servidor siga disponible.
3. El navegador impide enviar un formulario inválido. ¿El servidor puede confiar?#
No. Otro cliente puede construir la solicitud directamente. El servidor debe validar reglas y autorización.
4. DNS funciona y el servidor responde a ping, pero la página falla. ¿Qué falta aislar?#
Transporte y TLS, respuesta HTTP, recursos secundarios, aplicación del servidor, políticas del navegador y código del cliente.
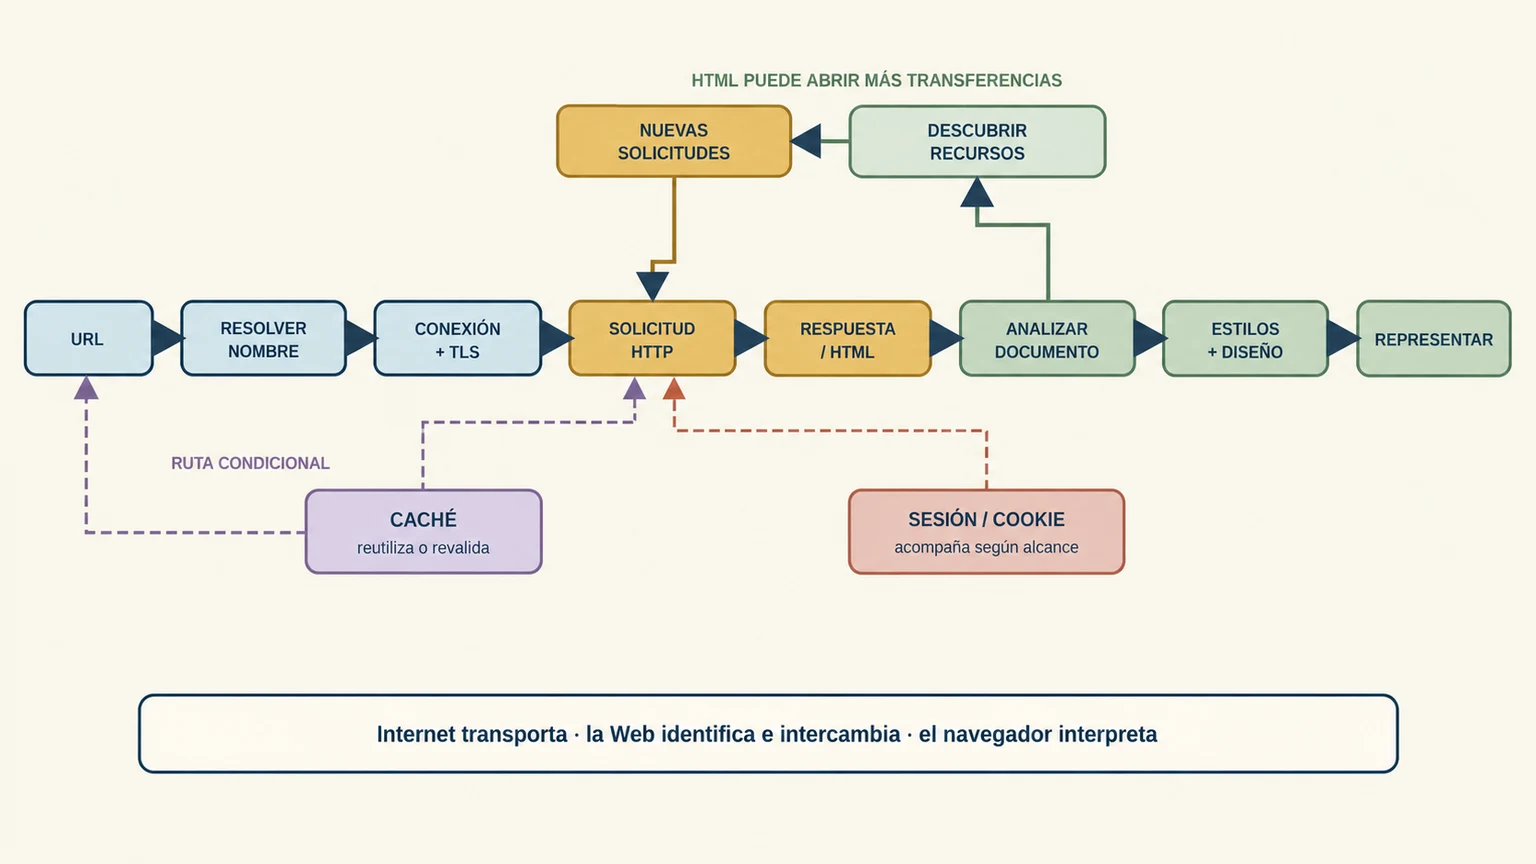
Clave de lectura. La secuencia resume contratos conceptuales; navegadores pueden solapar trabajo, reutilizar conexiones y ejecutar varias solicitudes en paralelo.
Fuentes y lecturas del capítulo#
- R. Fielding, M. Nottingham y J. Reschke, editores. RFC 9110: HTTP Semantics. IETF, 2022.
- WHATWG. URL Standard. Living Standard, consultado en 2026.
- WHATWG. HTML Standard. Living Standard, consultado en 2026.
- A. Barth. RFC 6265: HTTP State Management Mechanism. IETF, 2011.
- R. Fielding. Architectural Styles and the Design of Network-based Software Architectures. Tesis doctoral, University of California, Irvine, 2000.