PARTE XLI · Computación, datos e Internet
463
Privacidad digital: datos, inferencias y control
La privacidad no consiste sólo en ocultar secretos: regula cómo la información sobre personas altera sus opciones, relaciones y poder
En este capítulo
Una aplicación no pregunta por la rutina de una persona. Registra horas de conexión, ubicación aproximada y contactos; de esos rastros puede inferir trabajo, hogar o relaciones. El dato más sensible quizá nunca fue declarado.
La privacidad trata los efectos que el procesamiento de información produce sobre personas y grupos: pérdida de autonomía, vigilancia, exclusión, exposición o incapacidad de cuestionar una decisión. Se relaciona con seguridad, pero no se reduce a ella. Un sistema sin intrusiones puede recopilar demasiado y usarlo de forma dañina.
La pregunta guía es: ¿cómo nacen, se combinan y se convierten en decisiones los datos sobre una persona, y dónde puede limitarse ese poder?
463.1. Datos observados, declarados e inferidos#
Los datos declarados son los que alguien entrega: nombre, respuesta o preferencia. Los observados registran conducta o entorno: clics, posición, consumo o dispositivo. Los inferidos se calculan a partir de otros datos: probabilidad de abandono, afinidad o riesgo.
La frontera no determina sensibilidad. Una inferencia puede revelar más que su insumo; un dato público puede causar daño al agregarse. «No lo preguntamos» no significa «no lo sabemos».
El contexto importa. Compartir una dirección con un repartidor no implica permitir que se use para publicidad o se venda. La privacidad contextual pregunta qué flujo es apropiado entre actores, para qué propósito y bajo qué expectativa.
Las categorías también afectan colectivos. Un modelo puede no identificar a una persona por nombre y asignarle consecuencias por barrio, idioma o patrón. El riesgo no desaparece al retirar identificadores directos.
La exactitud es una dimensión de justicia y privacidad. Una inferencia errónea puede cerrar oportunidades; una inferencia correcta puede ser intrusiva. Corregir errores no legitima cualquier uso.
463.2. Identificadores, metadatos y vinculación#
Un identificador señala una entidad dentro de un contexto: correo, número, cookie o clave interna. Puede ser persistente o rotatorio. Incluso sin nombre, un patrón singular puede permitir volver a reconocer a la misma persona.
Los metadatos describen una comunicación o registro: tiempo, tamaño, origen, destino y dispositivo. Su análisis revela rutinas y redes. Cifrar contenido no oculta necesariamente estas relaciones.
La vinculación une registros mediante identificadores compartidos o rasgos coincidentes. Fecha, zona y trayectoria pueden bastar cuando su combinación es rara. Cada conjunto aislado parece inocuo; juntos forman un perfil.
Seudonimizar sustituye identificadores por códigos y reduce exposición en ciertos flujos. Si existe una tabla reversible o rasgos enlazables, no es anonimización irreversible. La separación de claves, funciones y acceso sigue siendo necesaria.
La procedencia permite saber de dónde salió un atributo, quién lo transformó y con qué incertidumbre. Sin ella, una inferencia puede circular como hecho y ser imposible de impugnar.
463.3. Teléfonos, aplicaciones y flujos de información#
Un teléfono combina sensores, cuentas, aplicaciones, redes y servicios remotos. Dar permiso a una aplicación no describe todo el flujo: bibliotecas integradas, sistema operativo, tienda, proveedor de nube y socios pueden recibir señales.
Los permisos controlan capacidades del dispositivo, pero no siempre el uso posterior. Acceder a ubicación para navegación no impide conservarla o inferir visitas. El propósito necesita límites técnicos, contractuales y organizativos.
Los identificadores publicitarios y huellas de dispositivo permiten reconocer sesiones. Bloquear una técnica desplaza incentivos hacia otras. La protección sostenible reduce datos disponibles y restringe enlaces, no sólo cambia el identificador.
La sincronización aporta continuidad y multiplica copias. Borrar localmente puede no borrar respaldos, derivados ni datos compartidos. Un mapa de flujos debe incluir retención, transferencias y eliminación verificable.
Las notificaciones y pantallas también filtran: un mensaje visible revela información a quien observa el dispositivo. La privacidad se diseña desde interfaz hasta infraestructura.
463.4. Minimización, permisos y controles#
Minimizar significa recoger, conservar y compartir sólo lo necesario para un propósito definido. No es almacenar todo «por si acaso» y limitar consultas. Menos datos reducen daño, coste y tentación de reutilización.
La necesidad debe probarse campo por campo. Si basta verificar mayoría de edad, quizá no haga falta conservar fecha completa. Si un cálculo puede ejecutarse localmente, transmitir el dato requiere justificación adicional.
Los controles de acceso limitan quién puede actuar, pero el personal autorizado también puede usar datos fuera de propósito. Registro, separación de funciones, revisión y sanción hacen exigible la regla. La interfaz debe permitir decisiones comprensibles, no inducir aceptación mediante fatiga.
El consentimiento sólo es válido cuando hay información, libertad y alternativa real. En relaciones asimétricas puede no bastar. Algunas obligaciones y prohibiciones deben existir aunque alguien pulse «aceptar».
La retención define cuándo los datos dejan de ser necesarios. Borrar incluye índices, copias operativas y procesos futuros; respaldos pueden requerir caducidad y exclusión al restaurar. Una política sin mecanismo no produce eliminación.
463.5. Anonimización, reidentificación y límites#
Anonimizar busca impedir que datos se asocien razonablemente con personas. Quitar nombres rara vez basta. Cuasiidentificadores —edad, zona, fechas— pueden combinarse con fuentes externas.
Generalizar o suprimir reduce detalle y utilidad. Técnicas como privacidad diferencial añaden ruido calibrado a resultados agregados y ofrecen un límite formal sobre cuánto cambia la salida por una persona. Exigen un presupuesto de privacidad y no corrigen muestras sesgadas ni usos injustos.
El riesgo depende del adversario y datos auxiliares disponibles, que cambian con el tiempo. Por eso «anonimizado» no es una propiedad eterna. Publicar microdatos hace difícil retirar acceso posterior.
Los entornos controlados permiten análisis con contratos, auditoría y límites de exportación. Reducen riesgo frente a publicación abierta, pero no eliminan abuso interno ni inferencias.
La agregación protege cuando grupos son suficientemente amplios y consultas no permiten aislar individuos. Muchas preguntas superpuestas pueden reconstruir aportes; controlar composición es parte del diseño.
463.6. Derechos, diseño y responsabilidades#
Los marcos jurídicos varían, pero suelen reconocer información, acceso, corrección, oposición o eliminación bajo condiciones. Un derecho útil necesita identidad segura, plazos, explicación y recurso. Verificar al solicitante no debe exigir más datos de los necesarios.
La privacidad desde el diseño incorpora objetivos antes de recopilar: mapa de flujos, necesidad, amenazas, retención, opciones y pruebas. Añadir un aviso al final no cambia una arquitectura extractiva.
La responsabilidad se distribuye. Quien determina propósito y medios tiene deberes distintos de quien procesa instrucciones; desarrolladores y proveedores aún toman decisiones materiales. Contratar a un tercero no borra impacto.
Las evaluaciones de impacto describen personas afectadas, flujos, beneficios, daños, alternativas y controles. Deben poder detener o rediseñar un proyecto; si sólo justifican una decisión tomada, son ceremonia.
La transparencia no exige publicar secretos de seguridad ni código completo. Exige información suficiente para comprender qué ocurre, cuestionar resultados y atribuir responsabilidades. Explicar una decisión no compensa que sea ilegítima.
Síntesis#
Los datos pueden ser declarados, observados o inferidos; todos pueden afectar a personas. Identificadores y metadatos permiten vincular contextos. Permisos del dispositivo no controlan por sí solos usos posteriores. Minimización, límites de propósito, retención y rendición de cuentas reducen exposición. Seudonimización no equivale a anonimización, y la reidentificación depende de datos auxiliares. La privacidad requiere derechos operables y diseño que limite poder informacional.
Preguntas de transferencia#
1. Una base no contiene nombres. ¿Es anónima?#
No necesariamente. Combinaciones raras o fuentes externas pueden volver a identificar registros.
2. Una persona aceptó todos los permisos. ¿Cualquier uso posterior es legítimo?#
No. El consentimiento puede ser insuficiente o no cubrir nuevos propósitos, y existen límites que no dependen de aceptar.
3. El contenido está cifrado de extremo a extremo. ¿Ya no hay riesgo de privacidad?#
Persisten metadatos, extremos, copias, inferencias y usos por participantes legítimos.
4. ¿Por qué recopilar menos puede ser un control más fuerte que cifrar más?#
Porque un dato no recopilado no puede filtrarse, reutilizarse ni exigirse después. El cifrado protege acceso, no elimina la existencia ni el uso autorizado.
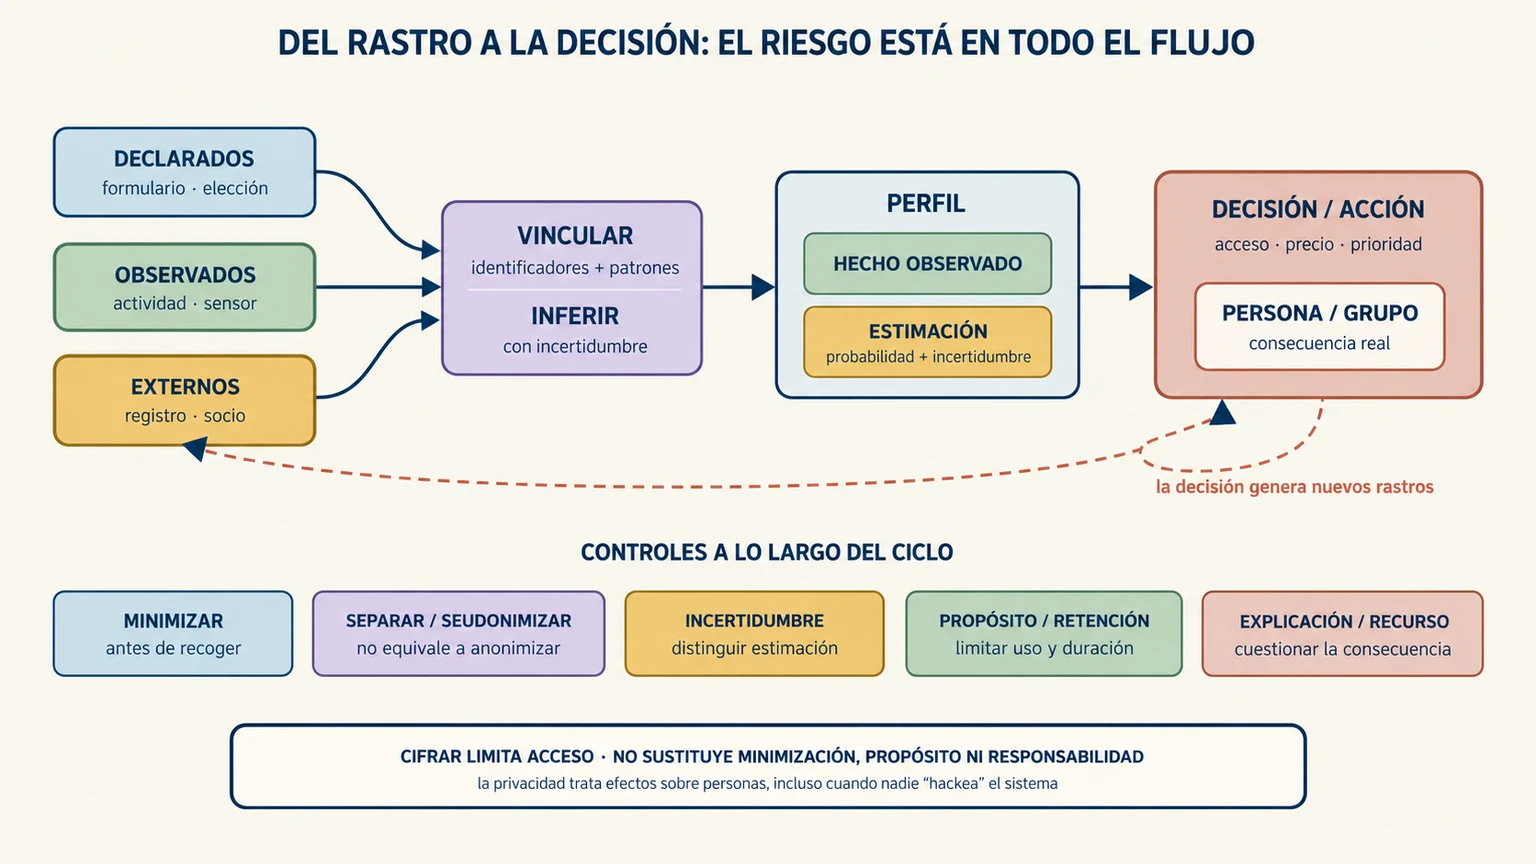
Clave de lectura. El perfil distingue hechos de estimaciones. La retroalimentación recuerda que una decisión cambia la conducta que el sistema observará después.
Fuentes y lecturas del capítulo#
- NIST. Privacy Framework 1.0. 2020.
- NIST. Privacy Engineering Program: De-Identification. Consulta: 7 de octubre de 2026.
- European Union Agency for Cybersecurity. Data Pseudonymisation: Advanced Techniques and Use Cases. 2021.
- Cynthia Dwork y Aaron Roth. The Algorithmic Foundations of Differential Privacy. 2014.
- Helen Nissenbaum. Privacy in Context. Stanford University Press, 2010.
- Solon Barocas y Helen Nissenbaum. Big Data’s End Run around Anonymity and Consent. 2014.