PARTE XLII · Inteligencia artificial y automatización
464
Aprendizaje automático: ajustar modelos a partir de datos
Aprender de datos no es descubrir automáticamente la verdad: es ajustar una regla para un objetivo bajo supuestos que deben sobrevivir fuera de la muestra
En este capítulo
Un sistema aprende a distinguir mensajes no deseados a partir de ejemplos marcados. En el conjunto con el que se construyó acierta casi siempre; meses después falla con nuevas campañas. El algoritmo no olvidó una regla universal. Había ajustado regularidades de una población, una época y una forma de etiquetar.
El aprendizaje automático construye modelos ajustando parámetros a partir de datos para reducir un objetivo. El resultado puede clasificar, estimar una cantidad, ordenar opciones, agrupar observaciones o elegir acciones. Que el ajuste reciba el nombre de aprendizaje no implica comprensión humana ni adquisición espontánea de fines.
Este capítulo pregunta: ¿qué aprende realmente un modelo, cómo se comprueba que generaliza y qué supuestos conectan los datos con el uso futuro?
464.1. Predicción, representación y objetivos#
Un problema de aprendizaje empieza antes del algoritmo. Hay que decidir qué entra, qué sale y para qué decisión servirá. Las entradas se representan mediante variables o características; la salida puede ser una clase, una puntuación o una acción. La representación hace visibles algunas diferencias e invisibles otras.
Un modelo es una familia de funciones posibles. Durante el entrenamiento se eligen parámetros que reducen una función de pérdida, es decir, una medida numérica de desacuerdo entre predicción y objetivo. En un problema sencillo puede buscarse
donde
Elegir objetivo distribuye errores. En detección de enfermedad, un falso negativo y un falso positivo no tienen el mismo coste. Exactitud global puede ocultar que una clase rara recibe casi todos los fallos. Umbrales y métricas deben relacionarse con consecuencias, prevalencia y capacidad posterior de revisión.
Una predicción estima una relación estadística. No identifica necesariamente una causa. Si el modelo aprende que cierto tratamiento aparece asociado a recuperación, puede estar viendo que se administra a pacientes menos graves. Usarlo para decidir intervenciones exige razonamiento causal, diseño experimental o supuestos adicionales.
El modelo tampoco fija el objetivo social. Una puntuación de «riesgo» sólo adquiere función cuando alguien decide qué resultado predecir, cuánto error tolerar y qué acción vincular a la salida. Esas decisiones no se delegan a los datos.
464.2. Entrenamiento, validación y prueba#
Evaluar con los mismos ejemplos usados para ajustar mide recuerdo del conjunto, no desempeño futuro. Por eso se separan datos de entrenamiento, validación y prueba. El entrenamiento ajusta parámetros; la validación guía elecciones como representación, complejidad y umbral; la prueba se reserva para una estimación final.
La separación debe respetar la unidad real. Si fotografías de una misma persona aparecen en entrenamiento y prueba, el modelo puede reconocer a la persona en vez del fenómeno. En series temporales, mezclar futuro y pasado filtra información imposible al momento de uso. En hospitales, dividir filas al azar puede compartir pacientes o protocolos entre conjuntos.
El conjunto de prueba también se desgasta. Si el equipo consulta repetidamente su resultado y modifica el sistema, esa información guía el desarrollo: la prueba funciona de hecho como validación. Se necesitan datos nuevos o un protocolo que limite adaptaciones.
Una cifra de desempeño tiene incertidumbre. Una muestra pequeña produce intervalos amplios; una muestra desequilibrada puede no contener casos críticos. Reportar promedio sin variación, subgrupos ni condiciones oculta la evidencia necesaria para decidir.
La comparación debe incluir una línea base. Un modelo complejo que predice demanda quizá no supere repetir la semana anterior. La pregunta relevante no es si la puntuación parece alta, sino si mejora una alternativa dentro del proceso real y a qué coste.
464.3. Aprendizaje supervisado, no supervisado y por refuerzo#
En aprendizaje supervisado, los ejemplos incluyen un objetivo: correo y etiqueta, imagen y diagnóstico, vivienda y precio. El modelo aprende una relación entre entradas y salidas. La etiqueta puede proceder de medición, decisión humana o resultado posterior; cada origen introduce errores y sesgos distintos.
En aprendizaje no supervisado, no hay una etiqueta objetivo del mismo tipo. Se buscan estructuras: grupos, dimensiones latentes, anomalías o representaciones compactas. Un agrupamiento no descubre automáticamente categorías naturales. Su forma depende de la distancia, variables y número de grupos elegidos.
El aprendizaje autosupervisado crea objetivos desde los propios datos, por ejemplo predecir una parte oculta. Permite aprovechar grandes colecciones sin etiquetas manuales y aprender representaciones reutilizables. El objetivo proxy sigue sin garantizar utilidad o veracidad en una tarea posterior.
En aprendizaje por refuerzo, un agente observa un estado, elige acciones y recibe recompensas. Busca una política que maximice retorno acumulado. Debe explorar para descubrir consecuencias y explotar lo aprendido. Una recompensa incompleta puede incentivar atajos: el agente optimiza la señal especificada, no la intención no expresada.
Estas categorías se combinan. Un sistema puede preentrenarse de modo autosupervisado, ajustarse con ejemplos supervisados y después optimizar preferencias. Nombrar el paradigma no describe por sí solo datos, objetivo ni garantías.
464.4. Generalización, sobreajuste y cambio de distribución#
Generalizar es mantener desempeño en ejemplos nuevos de la población de interés. Un modelo demasiado simple puede infraajustar y perder estructura; uno muy flexible puede capturar peculiaridades del entrenamiento. El sobreajuste aparece cuando mejorar la pérdida de entrenamiento ya no mejora —o empeora— la de validación.
Regularizar limita soluciones o penaliza complejidad; detener temprano evita seguir adaptándose al ruido; aumentar datos pertinentes puede reducir varianza. Ninguna técnica corrige una población equivocada. Más ejemplos del mismo sesgo hacen más precisa la relación sesgada.
La generalización ordinaria suele suponer que entrenamiento y uso siguen distribuciones suficientemente parecidas. En producción cambian usuarios, sensores, precios, políticas y adversarios. Ese cambio de distribución puede alterar entradas, frecuencia de resultados o relación entre ambos.
Detectar deriva en variables no demuestra que el desempeño cayó; algunas transformaciones son irrelevantes. Tampoco la ausencia de deriva visible garantiza estabilidad del objetivo. Cuando las etiquetas reales llegan tarde, se necesitan indicadores intermedios y auditorías periódicas.
El modelo puede cambiar el mundo que mide. Una recomendación altera compras; una puntuación modifica inspecciones; las nuevas decisiones producen nuevos datos. Estos bucles de retroalimentación vuelven inválida una prueba estática aunque no cambie el código.
Por eso desplegar no cierra el experimento. Hay que definir condiciones de uso, monitorizar entradas y resultados, registrar versiones, establecer umbrales de retirada y conservar una alternativa segura.
464.5. Datos, etiquetas y supuestos del problema#
Un conjunto de datos es una muestra producida por un proceso. Preguntar quién aparece, quién falta y por qué determina qué población representa. Datos accesibles no son necesariamente datos apropiados.
Las etiquetas contienen decisiones. «Fraude confirmado» depende de qué casos se investigaron; «buen empleado» de una evaluación organizativa; «toxicidad» de idioma y contexto. El desacuerdo entre anotadores puede revelar ambigüedad real, no sólo ruido que deba borrarse.
Las variables proxy sustituyen conceptos difíciles de medir. Ingresos pueden aproximar capacidad de pago; arrestos, delincuencia; clics, satisfacción. El proxy hereda instituciones y mecanismos de medición. Optimizarlo puede separar la cifra del propósito.
La fuga de información ocurre cuando una característica contiene datos que no estarán disponibles al predecir o codifica indirectamente la respuesta. Un diagnóstico registrado después del tratamiento puede producir resultados excelentes y un sistema inútil.
La documentación debe registrar procedencia, consentimiento o base legítima, cobertura, transformaciones, limitaciones y usos no previstos. También debe enlazar versiones del conjunto con modelos entrenados. Sin esa trazabilidad, no se sabe qué corregir cuando cambia una fuente.
Finalmente, el aprendizaje automático puede no ser la herramienta adecuada. Una regla explícita resulta preferible cuando el criterio es estable, debe ser exacto o necesita explicación directa. Un modelo aporta valor cuando existe una relación aprendible y datos adecuados, no por convertir cualquier decisión en predicción.
Síntesis#
El aprendizaje automático ajusta una función a datos para un objetivo definido. La pérdida formaliza parte de ese objetivo, no todo el valor de la decisión. Entrenamiento, validación y prueba cumplen funciones distintas y deben separarse según personas, tiempo y contexto. Supervisión, autosupervisión, agrupamiento y refuerzo ofrecen señales diferentes. Generalizar exige que la evidencia represente el uso; sobreajuste y cambio de distribución rompen esa conexión de maneras distintas. Los datos son productos sociales y técnicos, y sus etiquetas, proxies y ausencias forman parte del modelo.
Preguntas de transferencia#
1. Un clasificador obtiene 99 % de exactitud y la clase importante aparece en 1 % de los casos. ¿Es suficiente?#
No. Predecir siempre la clase mayoritaria ya alcanza 99 %. Hay que medir errores por clase y relacionarlos con consecuencias.
2. ¿Por qué no ajustar decisiones hasta maximizar el resultado del conjunto de prueba?#
Porque cada decisión usa información de ese conjunto. Deja de ser una estimación independiente y el resultado se sobreajusta indirectamente.
3. El desempeño cayó sin cambiar el modelo. ¿Qué pudo ocurrir?#
Pudieron cambiar población, instrumentos, comportamiento, objetivo o proceso de etiquetado. El código fijo no implica distribución fija.
4. Un modelo predice bien quién recibe un tratamiento. ¿Sabe quién se beneficiará?#
No necesariamente. Predice la práctica observada, que puede reflejar selección y disponibilidad. Estimar beneficio causal exige otra evidencia.
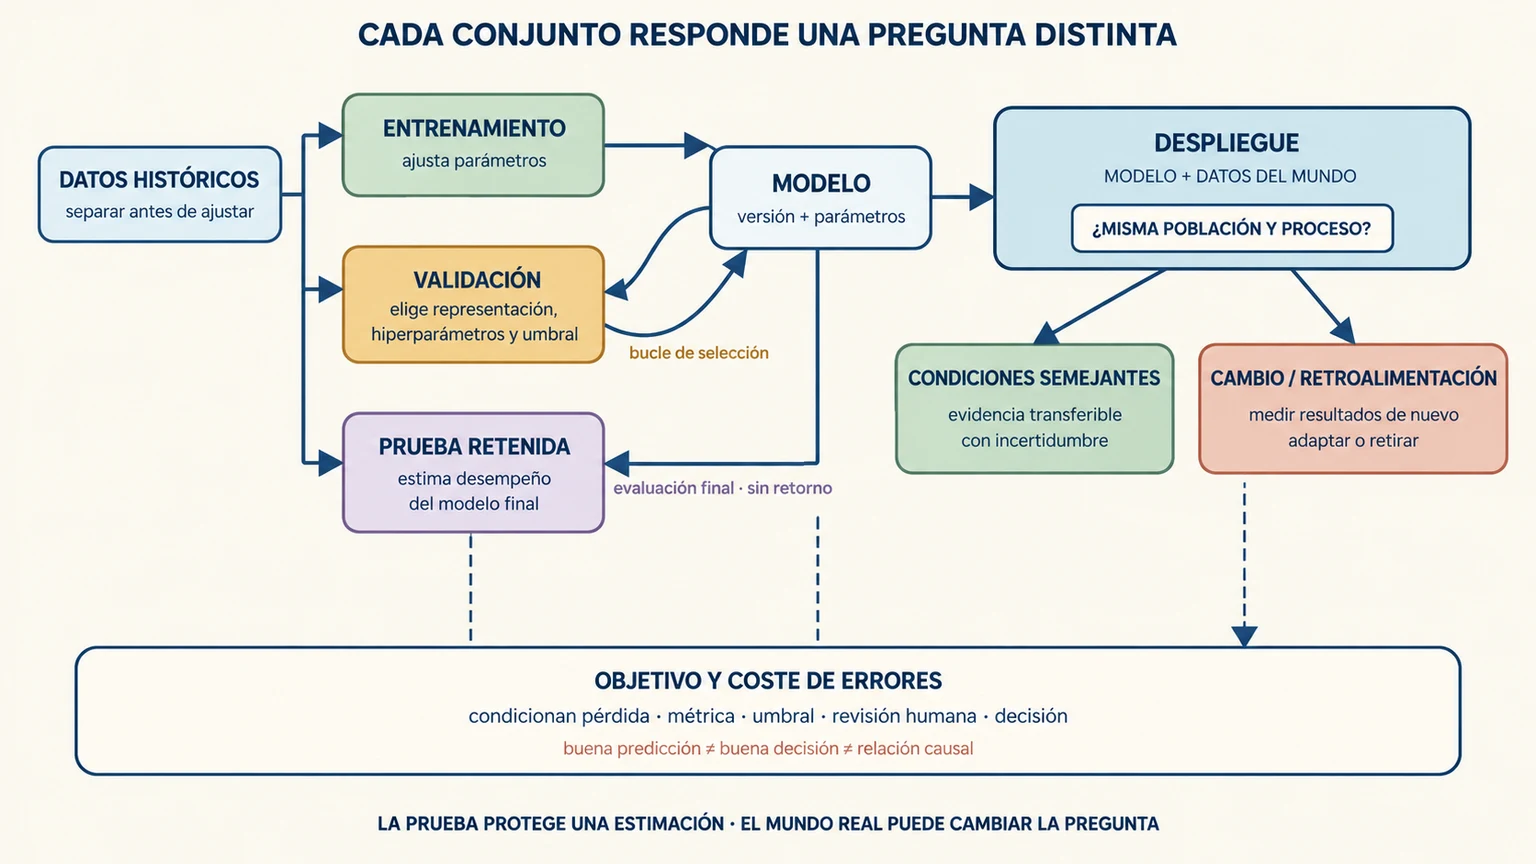
Clave de lectura. La prueba no participa en la selección. El despliegue abre una pregunta nueva: si las condiciones reales siguen representadas por la evidencia retenida.
Fuentes y lecturas del capítulo#
- NIST. Artificial Intelligence Risk Management Framework 1.0. 2023.
- Google. Machine Learning Crash Course: Datasets, Generalization, and Overfitting. Consulta: 7 de octubre de 2026.
- Peter Flach. Machine Learning: The Art and Science of Algorithms That Make Sense of Data. Cambridge University Press, 2012.
- Shalmali Joshi et al. A Review of the Role of Causality in Developing Trustworthy AI Systems. 2022.
- Adarsh Subbaswamy, Peter Schulam y Suchi Saria. Preventing Failures Due to Dataset Shift. AISTATS, 2019.
- Richard S. Sutton y Andrew G. Barto. Reinforcement Learning: An Introduction. MIT Press, 2018.