PARTE XLVII · Operación de los servicios públicos
511
Datos administrativos: cobertura, calidad y uso
Qué cambia cuando un registro operativo se usa para inferir
En este capítulo
Un distrito escolar registra matrículas y asistencia para organizar grupos, responder a ausencias y asignar recursos. Una oficina de planificación quiere usar esos registros para estimar qué proporción de adolescentes de la zona acude a la escuela. La base puede contar con exactitud las matrículas recibidas y, aun así, no incluir a jóvenes que nunca se inscribieron, asisten a centros no conectados o abandonaron sin que el expediente se actualizara. La respuesta depende de qué se pregunta y de cómo el sistema produce cada dato.
Los datos administrativos nacen del trabajo de una organización: tramitar, cobrar, asignar, autorizar, atender o controlar. Sus campos y categorías ayudan primero a cumplir esa tarea. Cuando otra oficina los reutiliza para estadística, investigación o decisión, cambia el propósito y con él las condiciones de validez. El capítulo 6 explica inferencia estadística en general; aquí la pregunta es anterior: ¿qué población llegó a producir las filas disponibles y qué transformaciones sufrieron antes de responder?
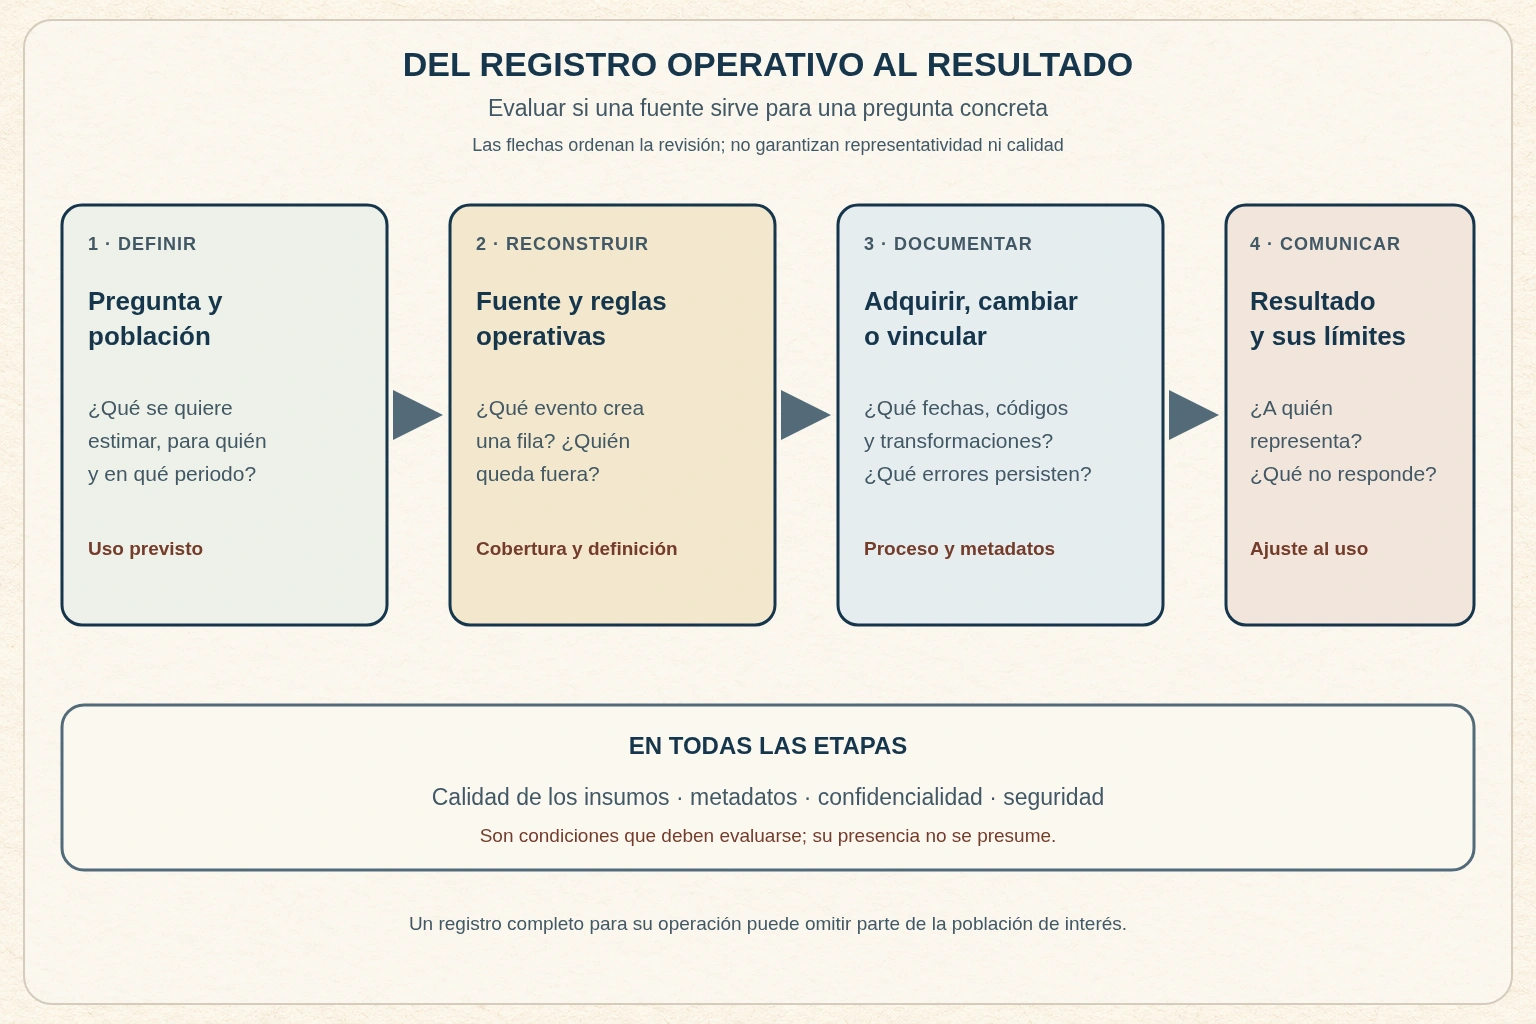
La calidad no reside en la base por sí sola; depende de la pregunta, las reglas de registro, el procesamiento y la población que se pretende describir.
511.1. El propósito original determina qué deja huella#
Una encuesta estadística se diseña para responder preguntas sobre una población; una fuente administrativa se produce principalmente para gestionar una función. La misma agencia puede tener ambos tipos. Naciones Unidas distingue fuentes estadísticas, fuentes administrativas creadas sobre todo para fines de gestión y otras fuentes generadas para fines comerciales o privados. También reconoce que los registros administrativos pueden reducir carga de respuesta y aportar información frecuente, pero suelen reflejar conceptos, coberturas y procesos que no fueron creados para la necesidad estadística posterior (ONU, módulo de aseguramiento de calidad de fuentes administrativas y otras, 2025).
En el ejemplo escolar, una fila puede generarse al completar una matrícula, al registrar una asistencia o al abrir un caso por ausencia. Cada evento representa una interacción distinta. Si el objetivo es contar estudiantes matriculados, la primera regla puede ser pertinente; si se estima asistencia cotidiana, hacen falta fechas y reglas de marcado; si se estudia a todos los adolescentes de la zona, el archivo probablemente no cubra por sí solo la población objetivo.
La pregunta debe fijar unidad, lugar y periodo antes de examinar la base. ¿Se cuentan personas, matrículas o días de asistencia? ¿Se incluyen jóvenes en instituciones privadas? ¿Un traslado crea una nueva fila o actualiza la existente? ¿Qué fecha define residencia o pertenencia al distrito? Los nombres de variables no contestan estas preguntas. Un campo “activo” puede significar matrícula administrativa vigente, no presencia física ese día.
511.2. Una fila ausente puede reflejar la regla, no el fenómeno#
La cobertura expresa qué parte de la población o de los eventos relevantes para una pregunta aparece en la fuente. El sesgo de selección surge cuando la probabilidad de quedar registrado guarda relación con la característica que se quiere describir. En el distrito, los adolescentes con menos acceso a transporte podrían tener menor matrícula y por tanto menor probabilidad de aparecer. La base mostraría quienes interactuaron con el sistema; no demostraría por sí misma cuántas personas quedaron fuera ni por qué. El catálogo metodológico de la Oficina Nacional de Estadística del Reino Unido clasifica estos problemas como errores de representación; es una taxonomía útil para revisar fuentes administrativas, no una norma universal (ONS, errores de representación y de enlace).
También existe sobrecobertura: duplicados, personas que se mudaron y no se dieron de baja, matrículas de prueba o registros que siguen abiertos. Un sistema puede ser internamente coherente y cubrir incompletamente la población. Campos llenos no prueban que todos los estudiantes estén representados; una fila faltante no significa que no exista la persona o el evento. Las tasas de cobertura necesitan un referente independiente o una metodología explícita para estimar lo no observado.
La oficina podría comparar el registro con un censo reciente, una encuesta o una fuente alternativa, pero la comparación no resuelve automáticamente la discrepancia. Las fuentes pueden usar límites territoriales, edades, periodos y definiciones diferentes. A veces dos bases comparten la misma omisión o dependen una de otra, lo que hace que parezcan coincidir sin cubrir a quienes faltan. El capítulo 1 explica por qué la convergencia de mediciones requiere examinar su procedencia y posibles dependencias.
Ejemplo construido. El distrito reúne 120 filas de matrícula, pero 10 corresponden a segundas inscripciones de estudiantes ya presentes. Quedan 110 personas distintas. De ellas, 20 residen fuera del territorio elegido para el análisis: el archivo contiene 90 adolescentes residentes matriculados. Si una fuente poblacional independiente y compatible estima 150 adolescentes residentes, esos 90 representan el 60 % del total. Dividir directamente 120 entre 150 daría un 80 % que mezcla filas duplicadas y personas ajenas a la población objetivo. El 60 % tampoco mide asistencia diaria: para eso todavía faltan observaciones de presencia y un periodo definido.
511.3. Conceptos, fechas y cambios del sistema afectan la medida#
La calidad no es una propiedad única ni una puntuación universal. Una variable puede ser correcta para administrar un proceso y no medir el concepto de interés. Un formulario que pregunta por escuela de matrícula puede responder dónde está inscrito el estudiante, no dónde vive. Un estado de “ausente” puede no distinguir falta justificada, error de carga o interrupción de conexión. Antes de comparar categorías se documenta cómo las define y utiliza el sistema que las produce.
Las fechas también expresan reglas. Fecha de evento, fecha de ingreso, fecha de procesamiento y fecha de extracción pueden diferir. Si se usa la fecha del último cambio, un expediente tardío parece reciente; si se calcula asistencia antes de que todas las escuelas cierren el periodo, algunas observaciones quedan incompletas. El resultado debe especificar su fecha de referencia y, cuando corresponda, revisiones posteriores.
El proceso puede cambiar cuando se modifica un formulario, un código, una plataforma, el incentivo del personal o la regla que activa el registro. Una subida de matrículas en una serie puede reflejar una nueva obligación de registrar, no un aumento de asistencia. Los proveedores de datos conocen el contexto operativo; quien reutiliza la fuente necesita metadatos y comunicación con ellos para entender definiciones, controles, demoras y cambios. El módulo ONU de 2025 recomienda tratar calidad de los insumos, metadatos, seguridad y confidencialidad a lo largo de la evaluación; está diseñado para organismos estadísticos oficiales y complementa, no sustituye, el marco nacional completo.
La revisión debe abarcar el dato de origen y su transformación. Un valor puede capturarse correctamente pero asignarse a una categoría errónea al agregarse; un código de escuela puede haber cambiado; una unión entre tablas puede duplicar estudiantes si la clave no es única. El capítulo 457 trata estructura e integridad de bases; aquí se sigue cómo la preparación transforma observaciones originales en una estadística específica.
511.4. Vincular registros añade oportunidades y errores#
Unir registros puede permitir responder preguntas que ninguna fuente contiene por separado. También puede fallar de dos maneras: un falso positivo enlaza expedientes de personas distintas y un falso negativo deja separadas filas de la misma persona. Un porcentaje alto de coincidencias no mide por sí solo la exactitud: puede conservar errores sistemáticos, concentrados en nombres poco comunes, transliteraciones, cambios de apellido o grupos con menos campos completos. El catálogo metodológico de la ONS separa errores de enlace y advierte que la tasa de coincidencia no basta para evaluar su calidad; se cita como guía de evaluación, no como regla aplicable a todos los sistemas (ONS, errores de enlace probabilístico).
Una vinculación se justifica por la pregunta y la base jurídica aplicable, no solo porque existan identificadores compartidos. Debe limitar datos a lo necesario, controlar quién accede, documentar los criterios de enlace y verificar su desempeño en subgrupos relevantes. La seudonimización puede reducir exposición, pero no elimina todos los riesgos de reidentificación ni vuelve lícito cualquier uso. El capítulo 463 desarrolla principios de privacidad; el 511 recuerda que seguridad y confidencialidad forman parte del aseguramiento del dato, no un sello que se obtiene al anonimizar.
El uso estadístico de registros nominales tiene reglas distintas a la gestión operativa de expedientes. Los principios de estadísticas oficiales de Naciones Unidas piden elegir fuentes según calidad, oportunidad, coste y carga de respuesta; no convierten la reutilización de cualquier registro en un derecho automático (Principio 5). La autoridad, el propósito, el acceso y la protección deben evaluarse conforme al derecho aplicable.
Ejemplo construido. De 100 expedientes, un algoritmo enlaza 96. Una comprobación independiente determina que 90 de esos enlaces son correctos y 6 unen personas distintas; además encuentra 2 pares verdaderos entre los 4 expedientes sin enlace. La tasa de enlace es 96/100 = 96 %, pero la proporción de enlaces propuestos que son correctos es 90/96 ≈ 93,8 % (precisión). Se recuperaron 90 de los 92 pares verdaderos, es decir, 90/92 ≈ 97,8 % (recuperación). Son medidas distintas. En datos reales, conocer los pares verdaderos requiere evidencia de validación, y una revisión parcial introduce incertidumbre; no basta declarar que el algoritmo acertó.
511.5. La fuente debe ajustarse al uso que se hará del resultado#
Una evaluación práctica empieza por formular qué se quiere estimar y para quién servirá. Después reconstruye quién genera el dato, con qué regla, cómo se transmite, quién puede faltar, qué significan campos y fechas, qué modificaciones ocurrieron y qué procesamiento se aplicó. Con esa información decide si la fuente basta, si requiere ajustes, si se combina con otra evidencia o si no puede responder la pregunta con solidez.
En el ejemplo, el registro puede estimar matrículas dentro del sistema escolar si la definición y cobertura están controladas. Para estimar asistencia diaria se necesita un campo apropiado y una observación completa del periodo. Para estimar qué proporción de todos los adolescentes acude a la escuela, quizá hagan falta una fuente poblacional y comprobaciones sobre jóvenes no matriculados. Ninguna de estas conclusiones se sigue solo del tamaño del archivo.
Al publicar, conviene decir qué fuente se usó, cuándo se extrajo, qué población observa, qué transformaciones se hicieron, dónde hay omisiones o incertidumbre y qué preguntas quedan fuera. Esta nota no debilita un resultado; permite usarlo sin atribuirle cobertura o significado que no posee. La oficina debe distinguir si el producto cuenta actividad registrada, estima una población o mide un resultado. La evaluación causal de una reforma educativa o de un servicio pertenece a un diseño evaluativo, no se resuelve con registros por sí solos; el capítulo 512 trata la evaluación de servicios con mayor amplitud.
Síntesis#
- Los datos administrativos se generan para gestionar una función; su estructura refleja reglas y contactos con ese sistema.
- Cobertura, consistencia interna, exactitud, oportunidad y ajuste conceptual describen problemas distintos.
- La ausencia de una fila no prueba la ausencia del fenómeno; quien no llega al procedimiento puede quedar fuera de la fuente.
- Fechas, códigos, formularios, incentivos y versiones del sistema afectan la comparabilidad temporal.
- La vinculación añade errores de inclusión y exclusión, además de obligaciones de acceso, confidencialidad y seguridad.
- La validez depende del uso; debe comunicarse qué población y concepto representa el resultado y qué límites conserva.
Preguntas de transferencia#
¿El registro representa a todos los adolescentes?#
Ejemplo construido. La oficina descubre que la base contiene todas las matrículas que llegaron por el sistema del distrito. ¿Puede concluir que representa a todos los adolescentes residentes?
Mostrar respuesta razonada
No a partir de ese dato. Debe comparar población objetivo, límites territoriales y edades; averiguar si incluye centros privados, estudiantes que se mudaron y quienes nunca se matricularon; y considerar una fuente externa que permita estimar faltantes. “Todas las filas recibidas” describe integridad del archivo, no cobertura de la población.
La coincidencia entre bases es del 96 por ciento#
Ejemplo construido. El equipo enlazó una base de matrícula con un registro de asistencia y obtuvo una tasa de coincidencia del 96 por ciento. ¿Es suficiente para declarar fiable el enlace?
Mostrar respuesta razonada
No. Hay que saber cómo se definió coincidencia, cuántos falsos positivos y negativos quedan, si se concentra el error en ciertos grupos y cómo se comprobó una muestra de pares enlazados y no enlazados. El porcentaje informa volumen del proceso, no por sí solo su exactitud o equidad (ONS, errores de enlace probabilístico).
Fuentes y lecturas del capítulo#
- División de Estadística de Naciones Unidas, módulo de aseguramiento de calidad para fuentes administrativas y otras fuentes (marzo de 2025): clasificación de fuentes, ajuste conceptual, cobertura y evaluación de calidad; complementa un marco nacional, no lo sustituye.
- Office for National Statistics, Cataloguing errors in administrative and alternative data sources – what, when and how: errores de medición, representación y procesamiento; falsos enlaces, enlaces omitidos y límites de la tasa de coincidencia.
- Naciones Unidas, Principio 5 de las estadísticas oficiales: elección de fuentes atendiendo a calidad, oportunidad, costes y carga de respuesta.